Data Contracts und CI/CD
Wie passen Data Contracts in deine CI/CD-Pipeline?
Von Dr. Simon Harrer · · Video 2:40 · 9 Folien
Kurz gesagt
Ein Data Contract ist eine Datei im Git-Repository des Datenprodukts. Jede Änderung läuft durch eine CI/CD-Pipeline. Die Pipeline prüft den Data Contract, testet die Daten in jeder Umgebung und veröffentlicht die Ergebnisse im Datenmarktplatz.
Auf YouTube ansehen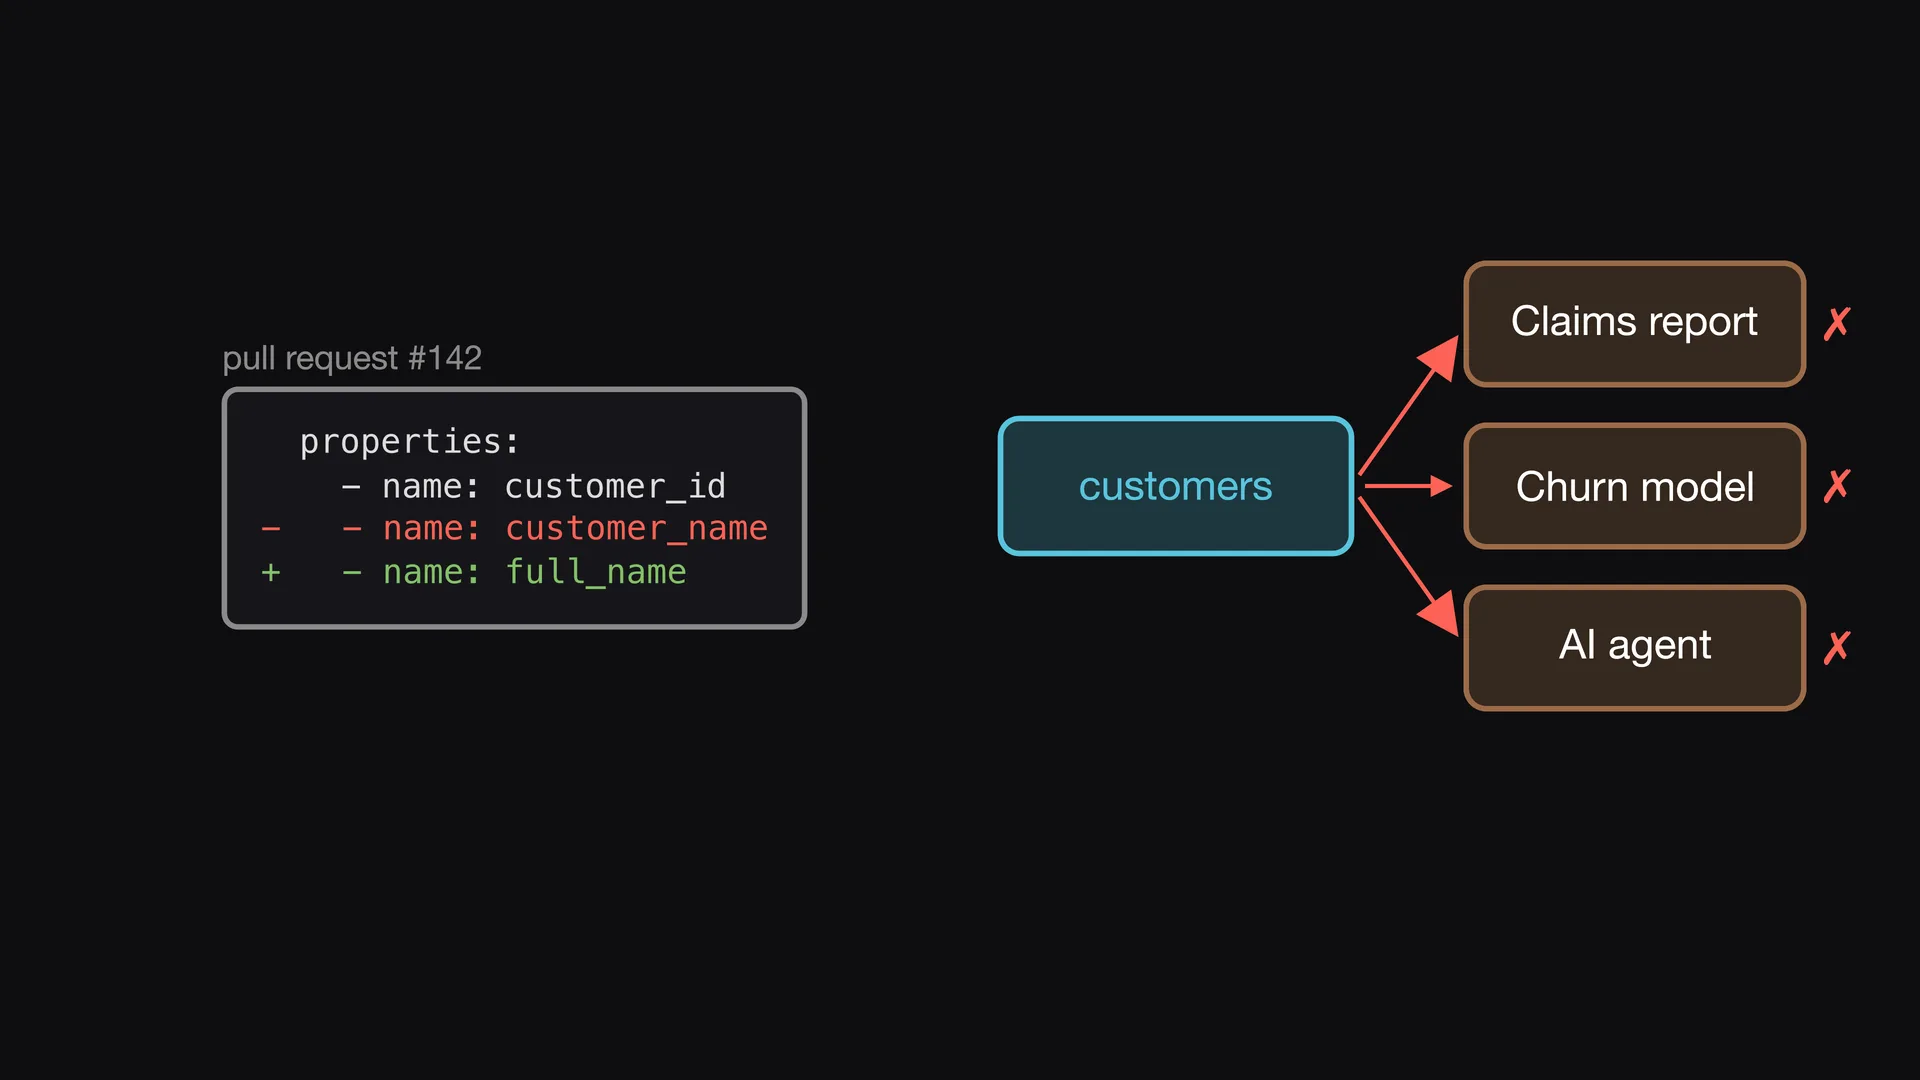
Eine Änderung in einer Zeile
Ein Data Engineer benennt in einem Pull Request eine Spalte um: customer name wird full name. Das Review sieht harmlos aus. Nach dem Deployment fallen ein Schadensbericht, ein Churn-Modell und ein KI-Agent aus. Der Data Contract hatte die Information, aber nichts hat sie geprüft.
Der Data Contract liegt in Git
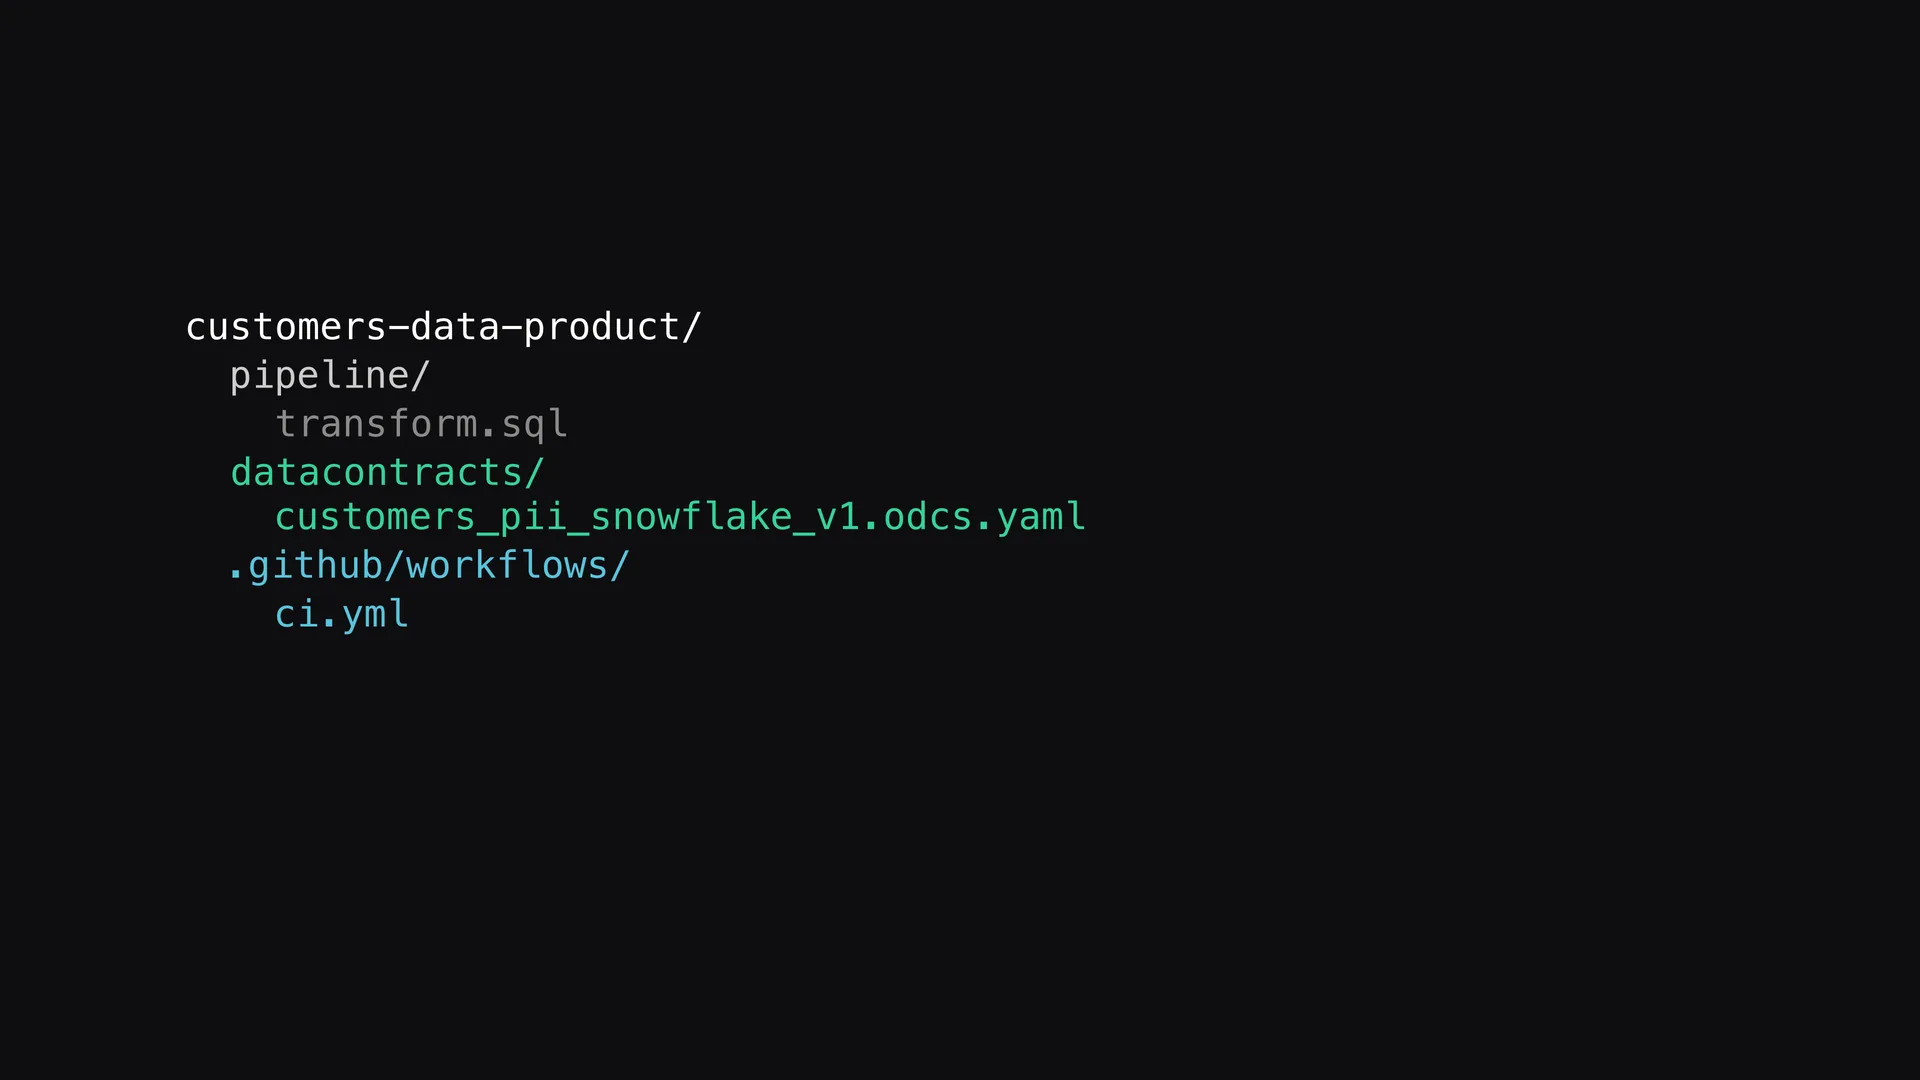
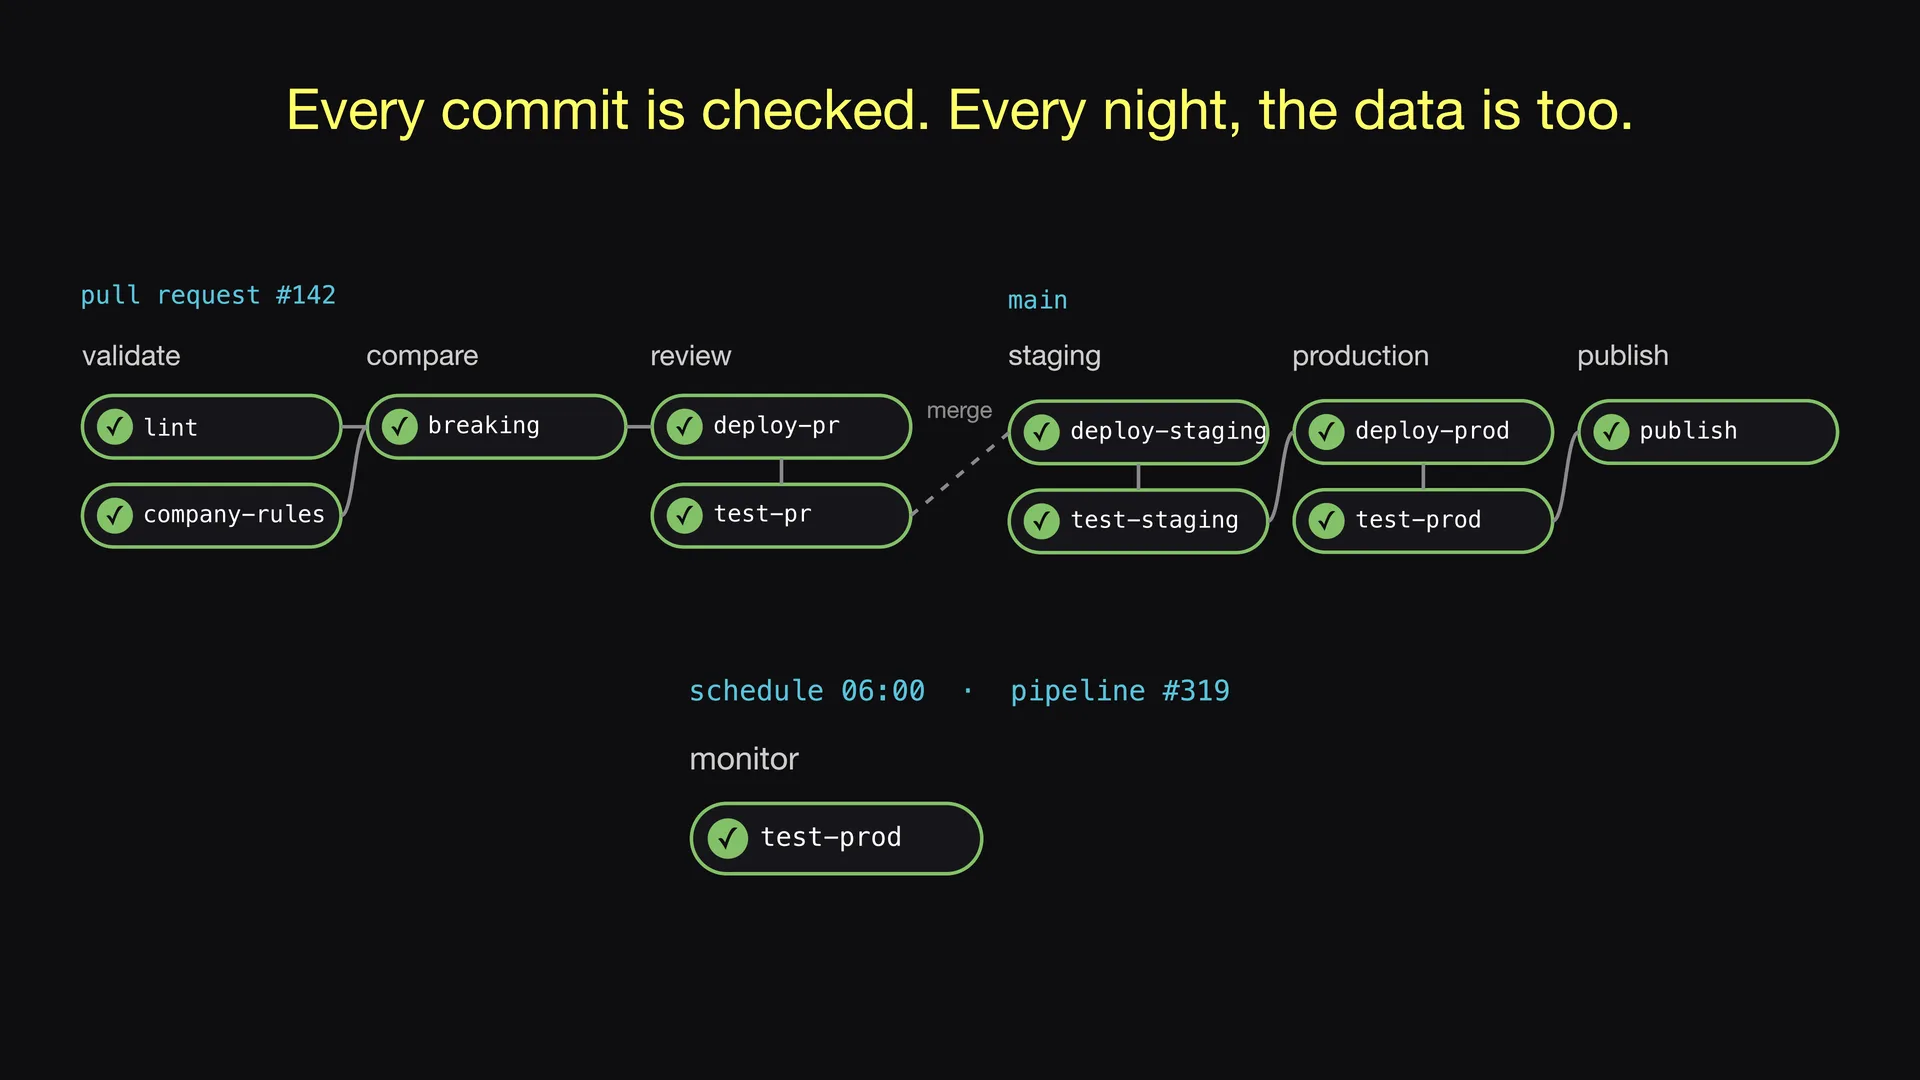
Halte den Data Contract im selben Git-Repository wie den Pipeline-Code. Der Dateiname nennt das Dataset, die Major-Version und die Plattform. Der Code und der Data Contract ändern sich gemeinsam. Jeder Commit startet die CI/CD-Pipeline.
Unternehmensregeln
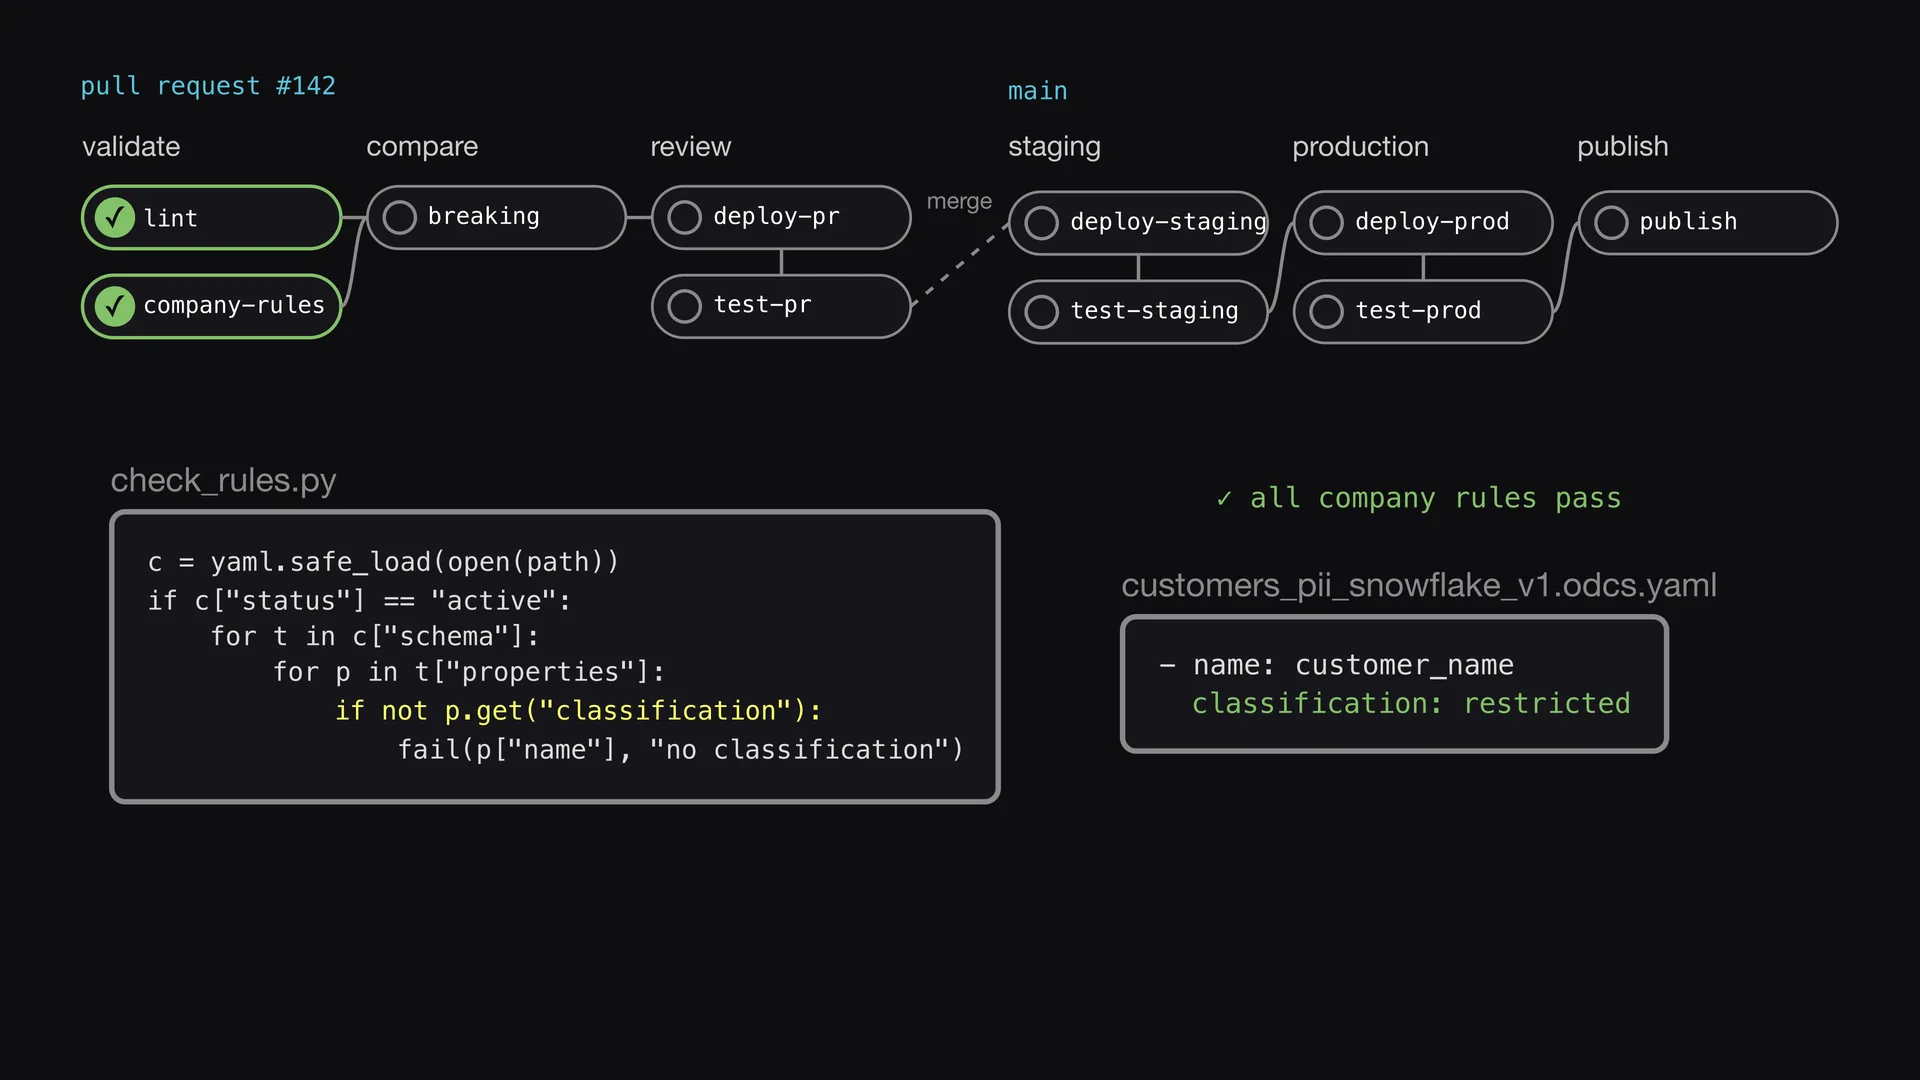
Zuerst prüft der Lint-Job, dass die Datei valides ODCS ist. Dann prüft ein kleines Python-Skript deine Unternehmensregeln. Jedes Feld eines aktiven Data Contracts muss zum Beispiel eine Klassifizierung haben. Der Build bleibt stehen, bis jedes Feld eine hat.
Breaking Changes stoppen den Build
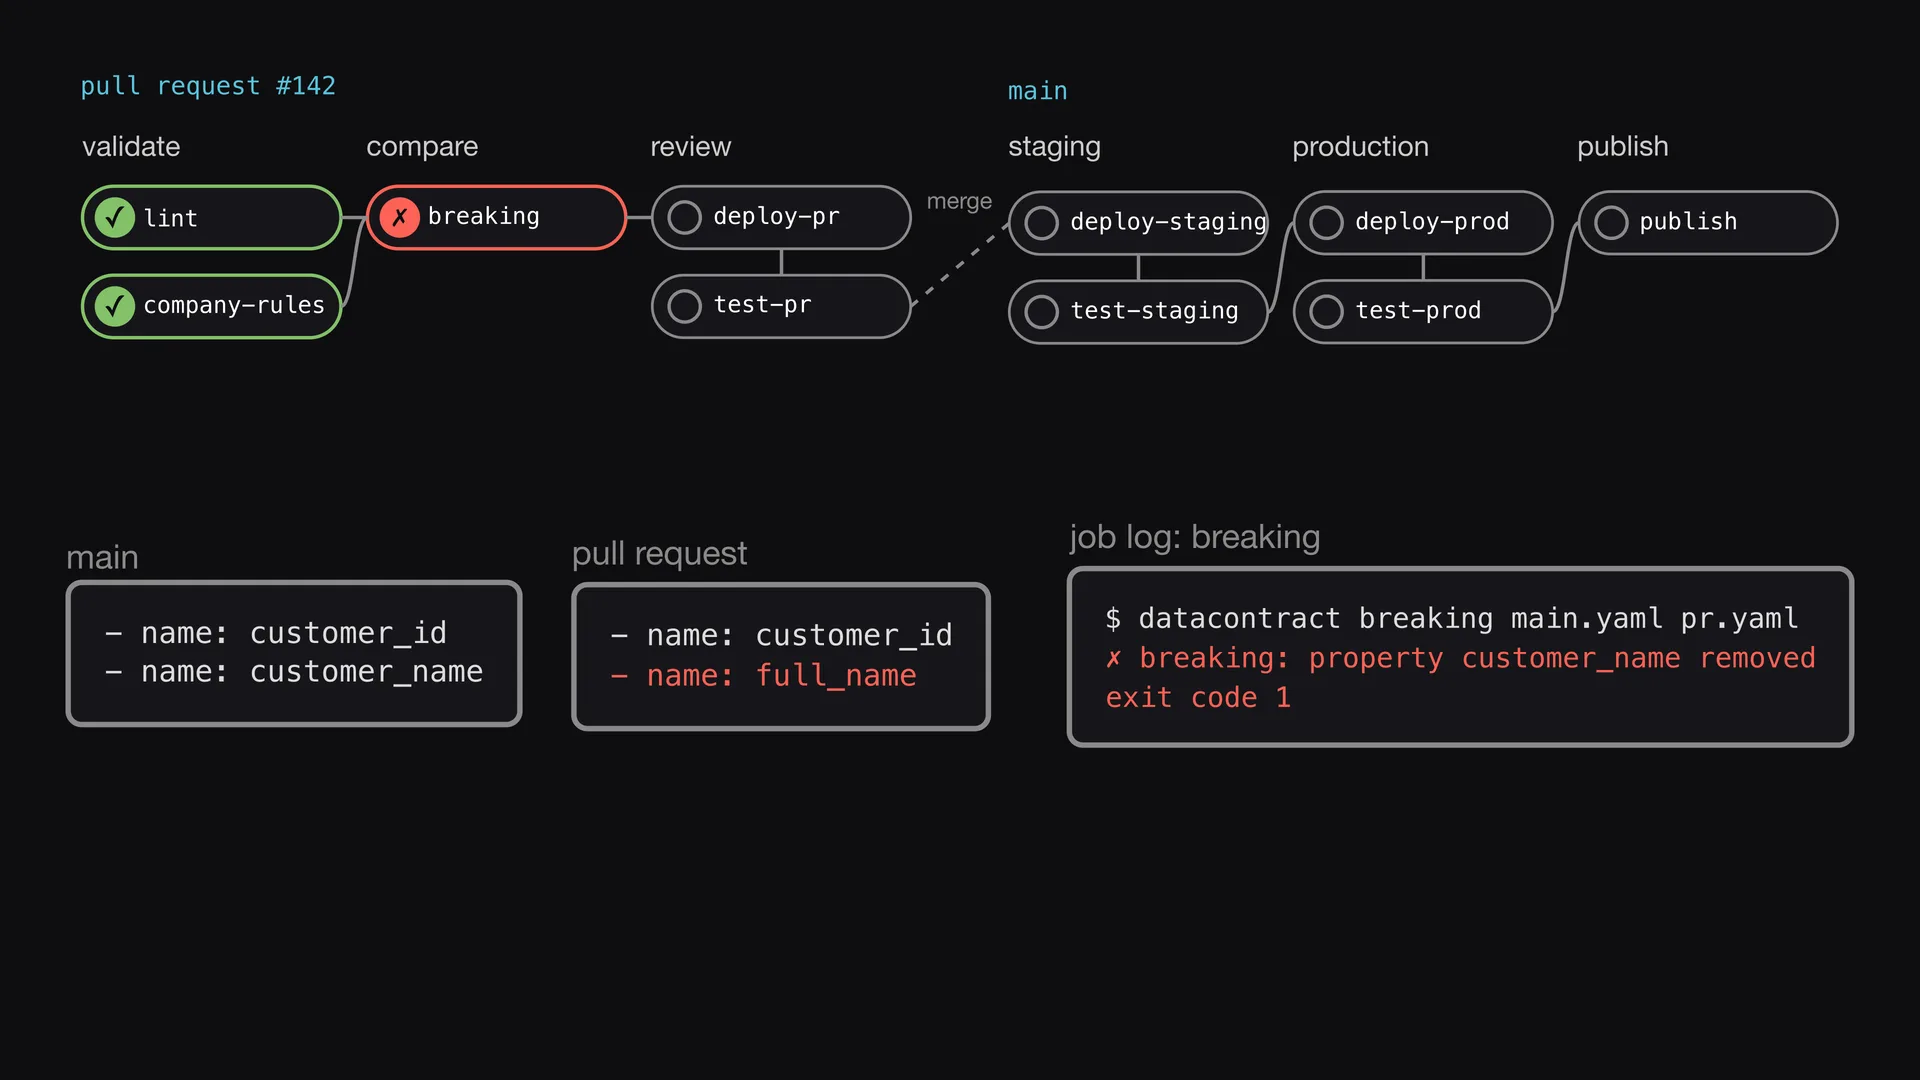
Der nächste Job vergleicht den geänderten Data Contract mit der Version auf dem main-Branch. Die Data Contract CLI stellt fest, dass eine Spalte entfernt wurde. Das ist ein Breaking Change, also schlägt der Build vor dem Merge fehl.
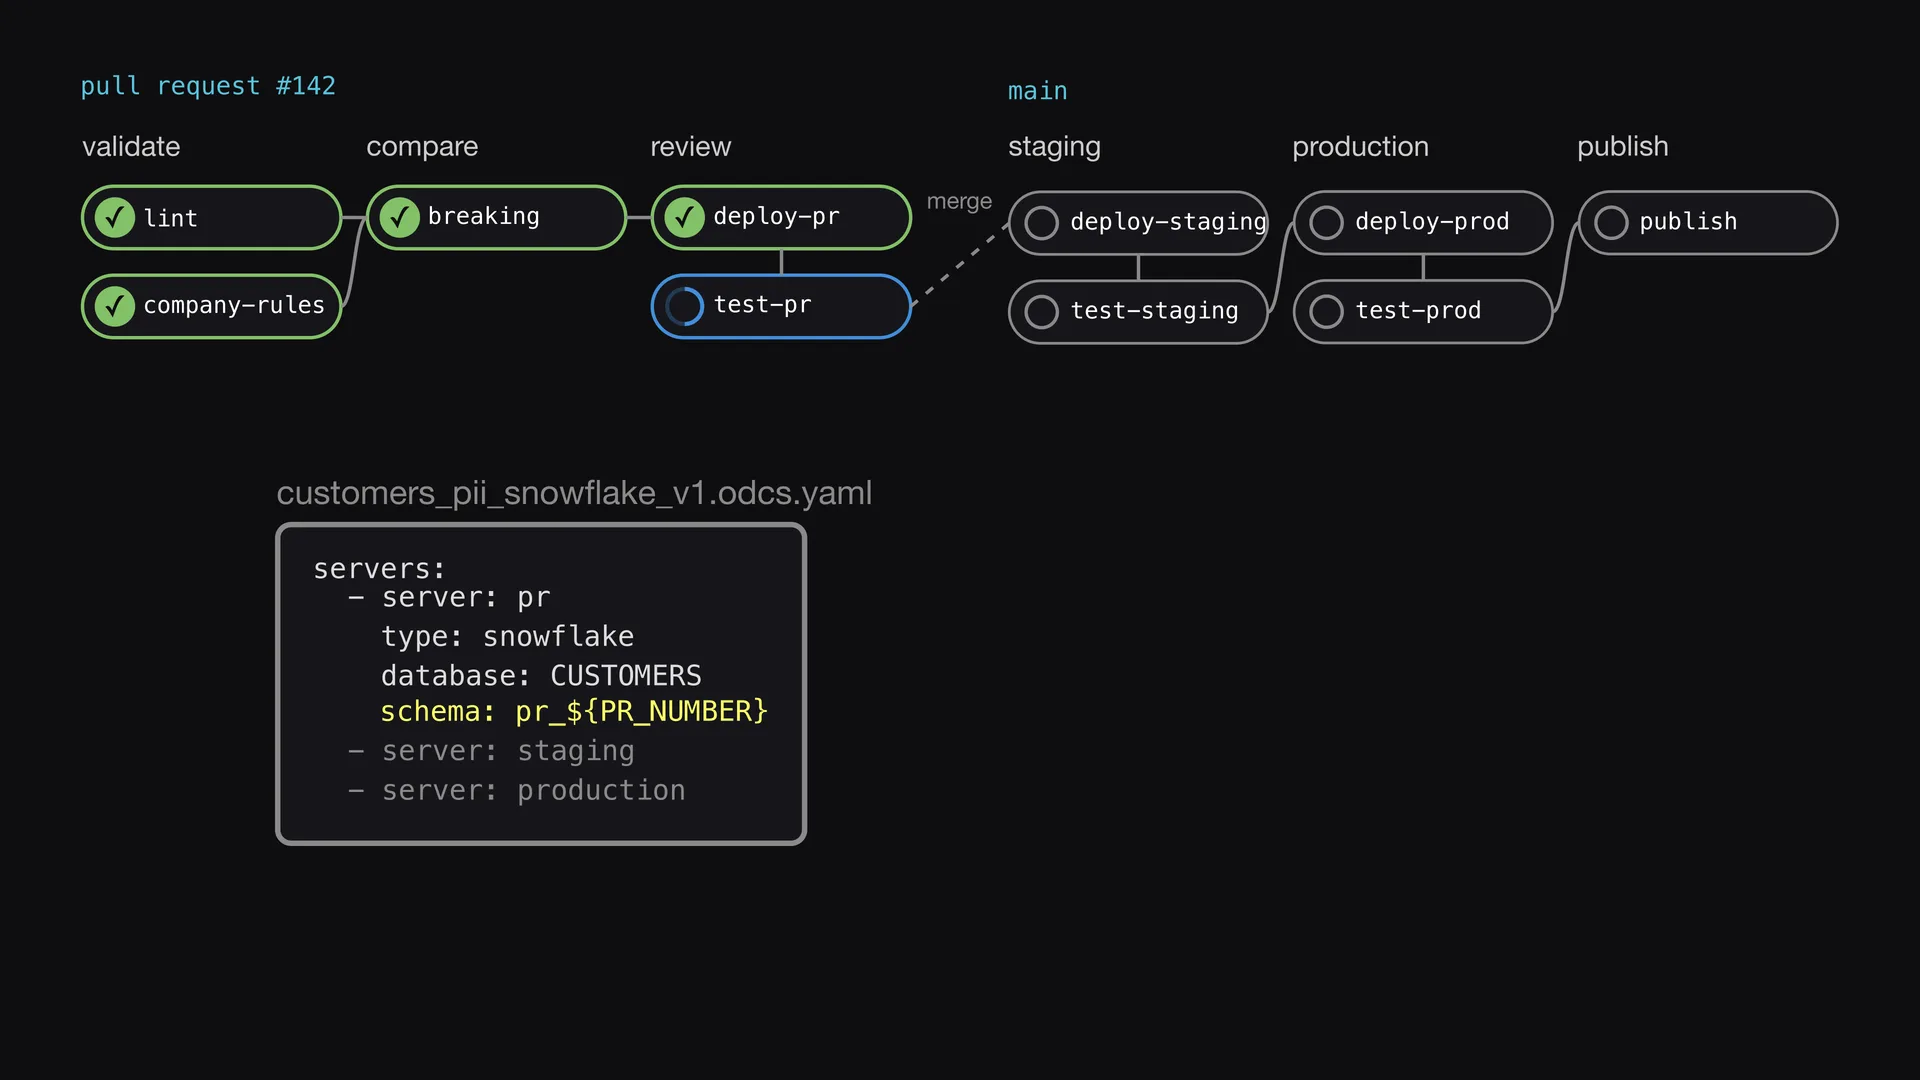
Ein Schema pro Pull Request
Vor dem Merge deployt die Pipeline die Änderung in eine eigene Umgebung. Der Server im Data Contract nimmt seinen Schemanamen aus einer Variable. So bekommt jeder Pull Request sein eigenes Schema, und die Tests berühren die Daten anderer nicht.
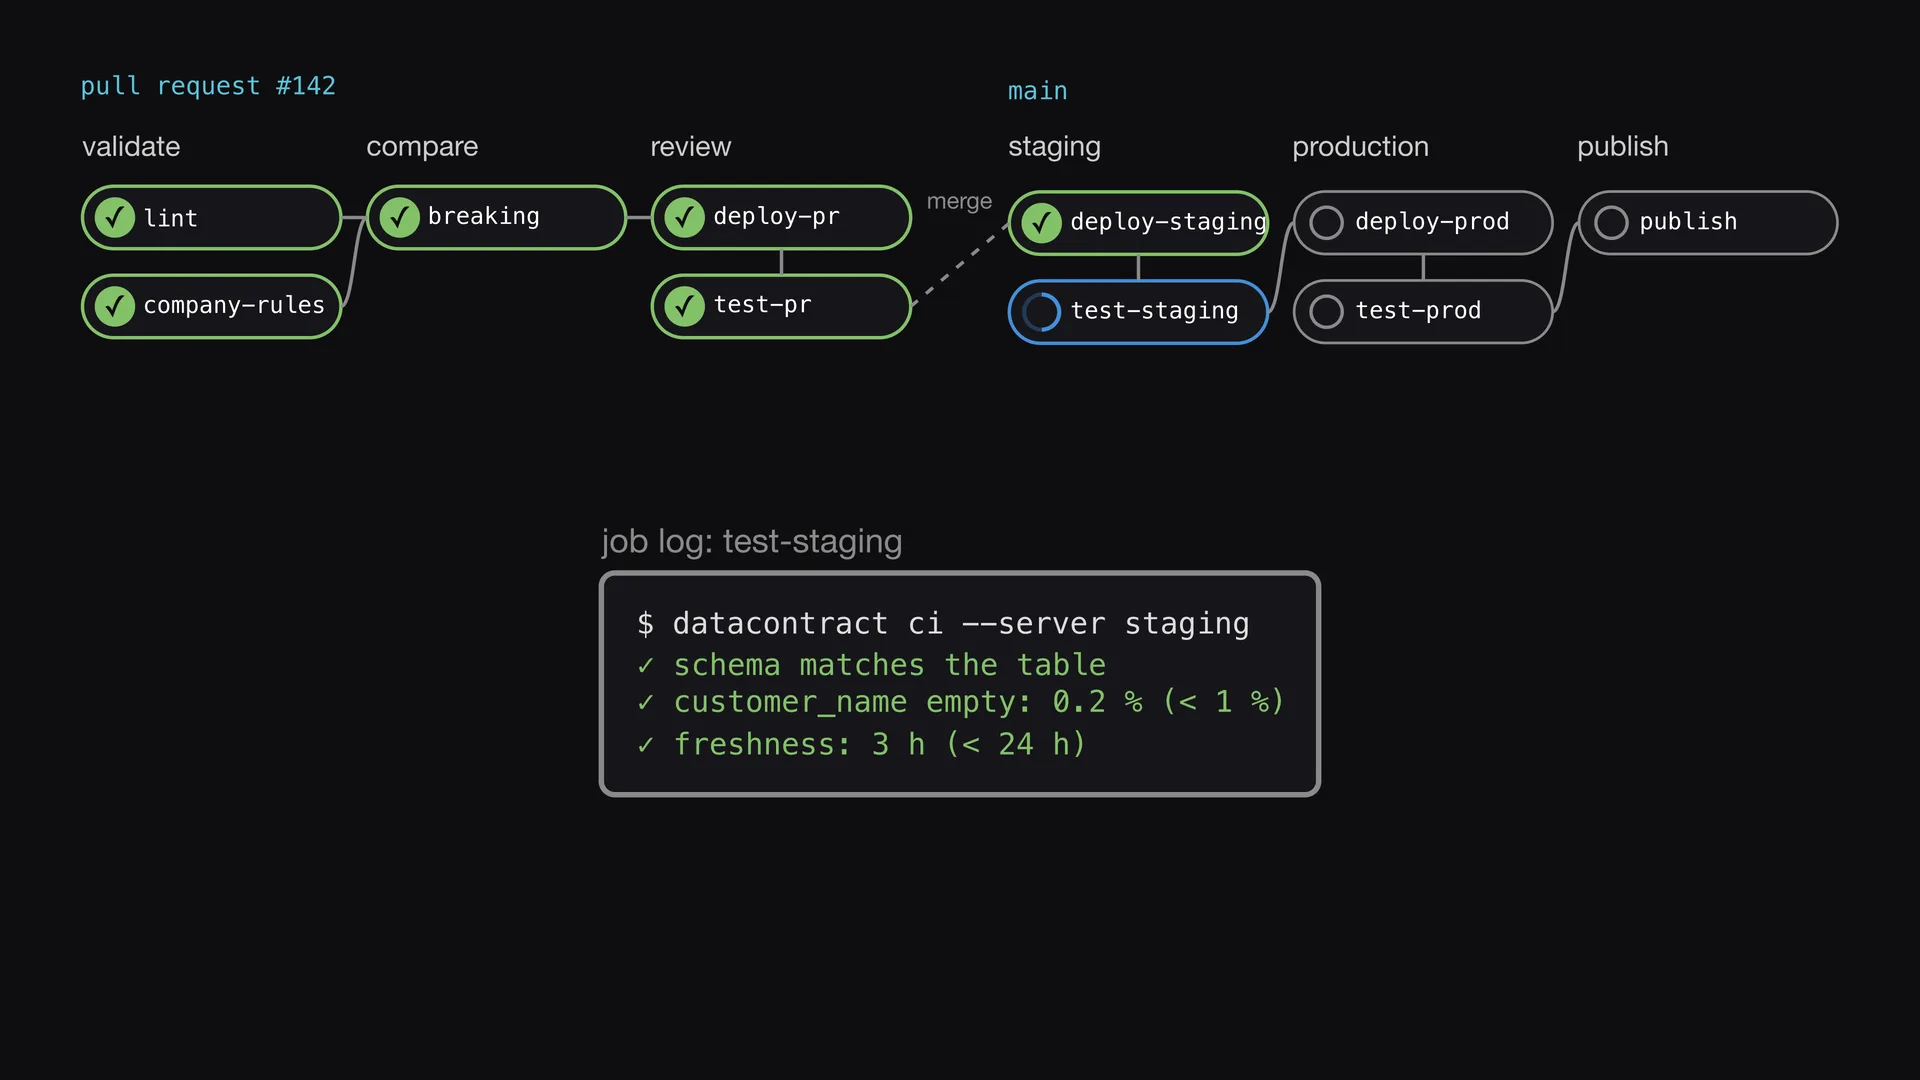
In Staging erneut testen
Nach dem Merge deployt die Pipeline nach Staging und führt die Datenpipeline aus. Dann testet sie das Schema, die Qualitätsregeln und die Freshness erneut. Die Pipeline nutzt für jede Umgebung denselben Data Contract. Nur der Server im Data Contract wechselt von einer Umgebung zur nächsten.
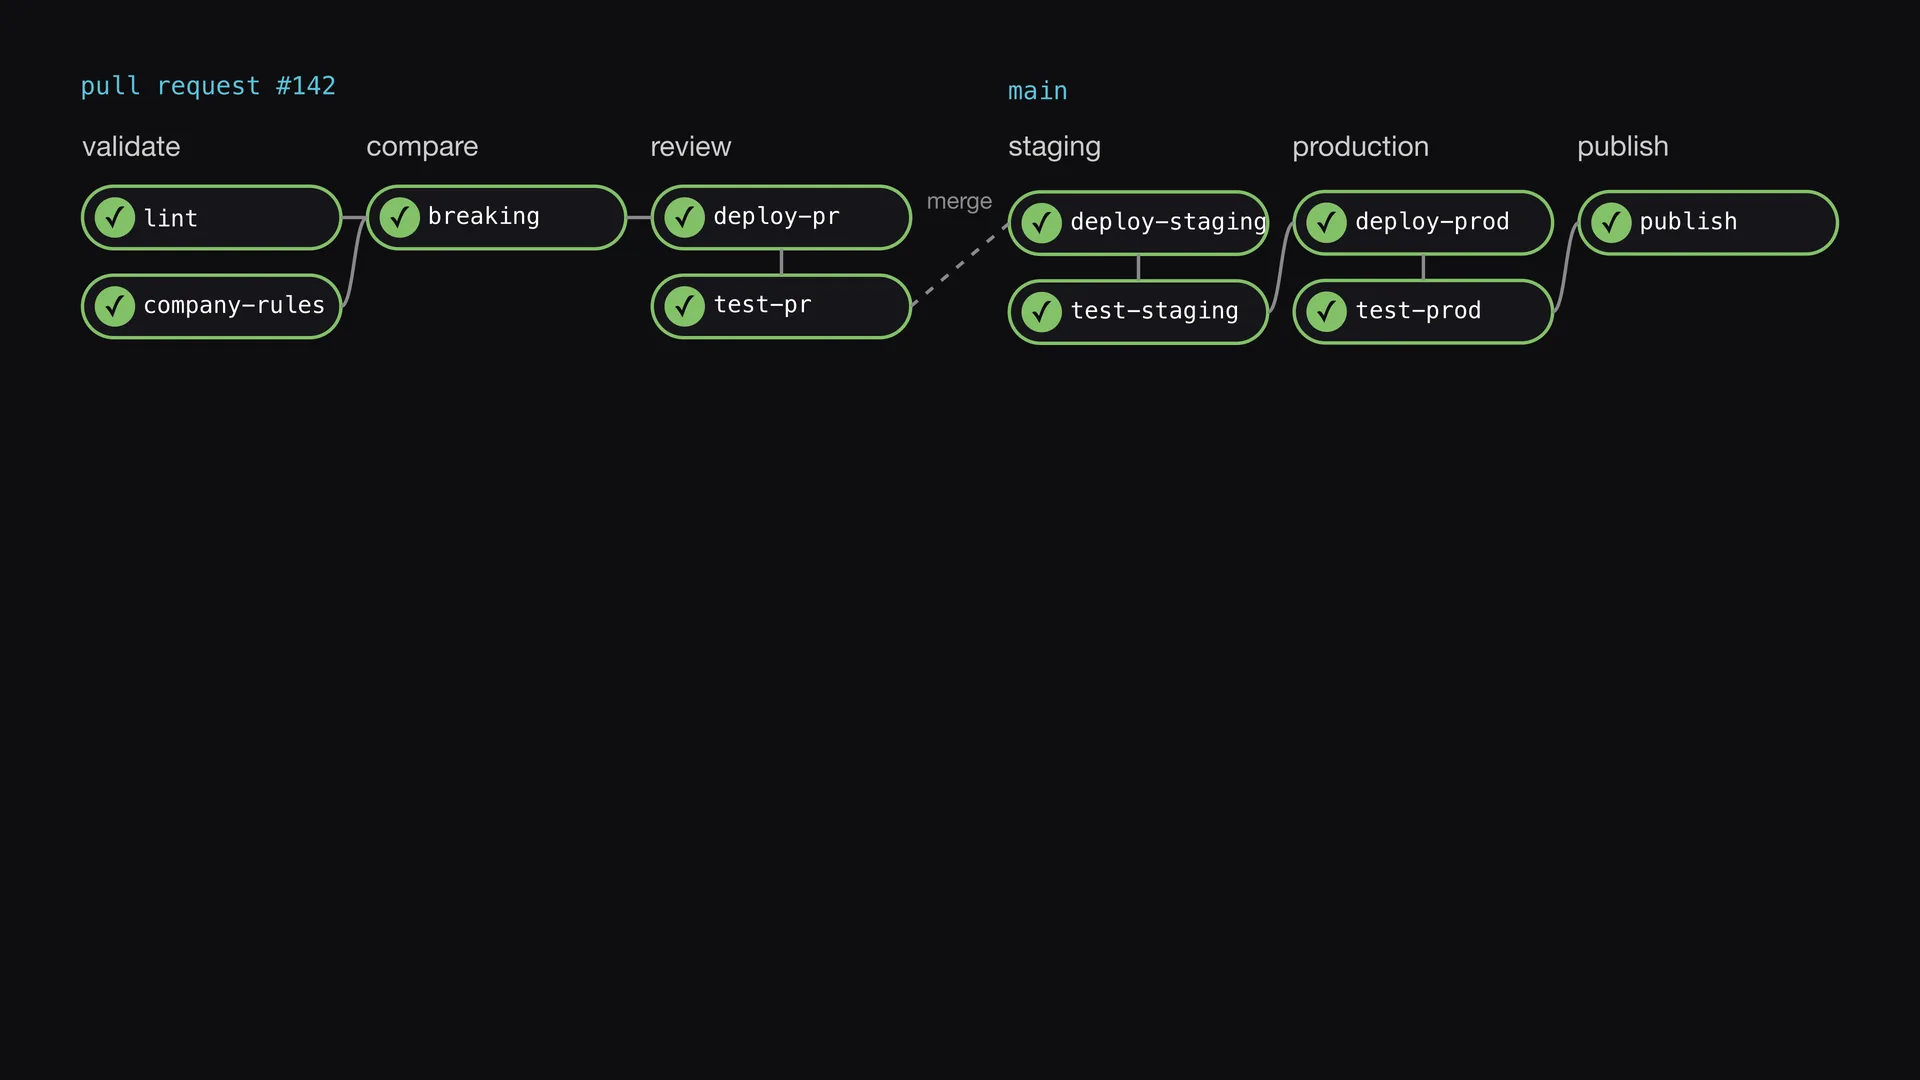
Veröffentlichen, wenn alle Jobs grün sind
Dann deployt die Pipeline nach Produktion und testet erneut. Erst wenn jeder Job grün ist, veröffentlicht sie den Data Contract und die Testergebnisse im Datenmarktplatz. Data Consumers sehen danach den aktuellen Stand des Versprechens.
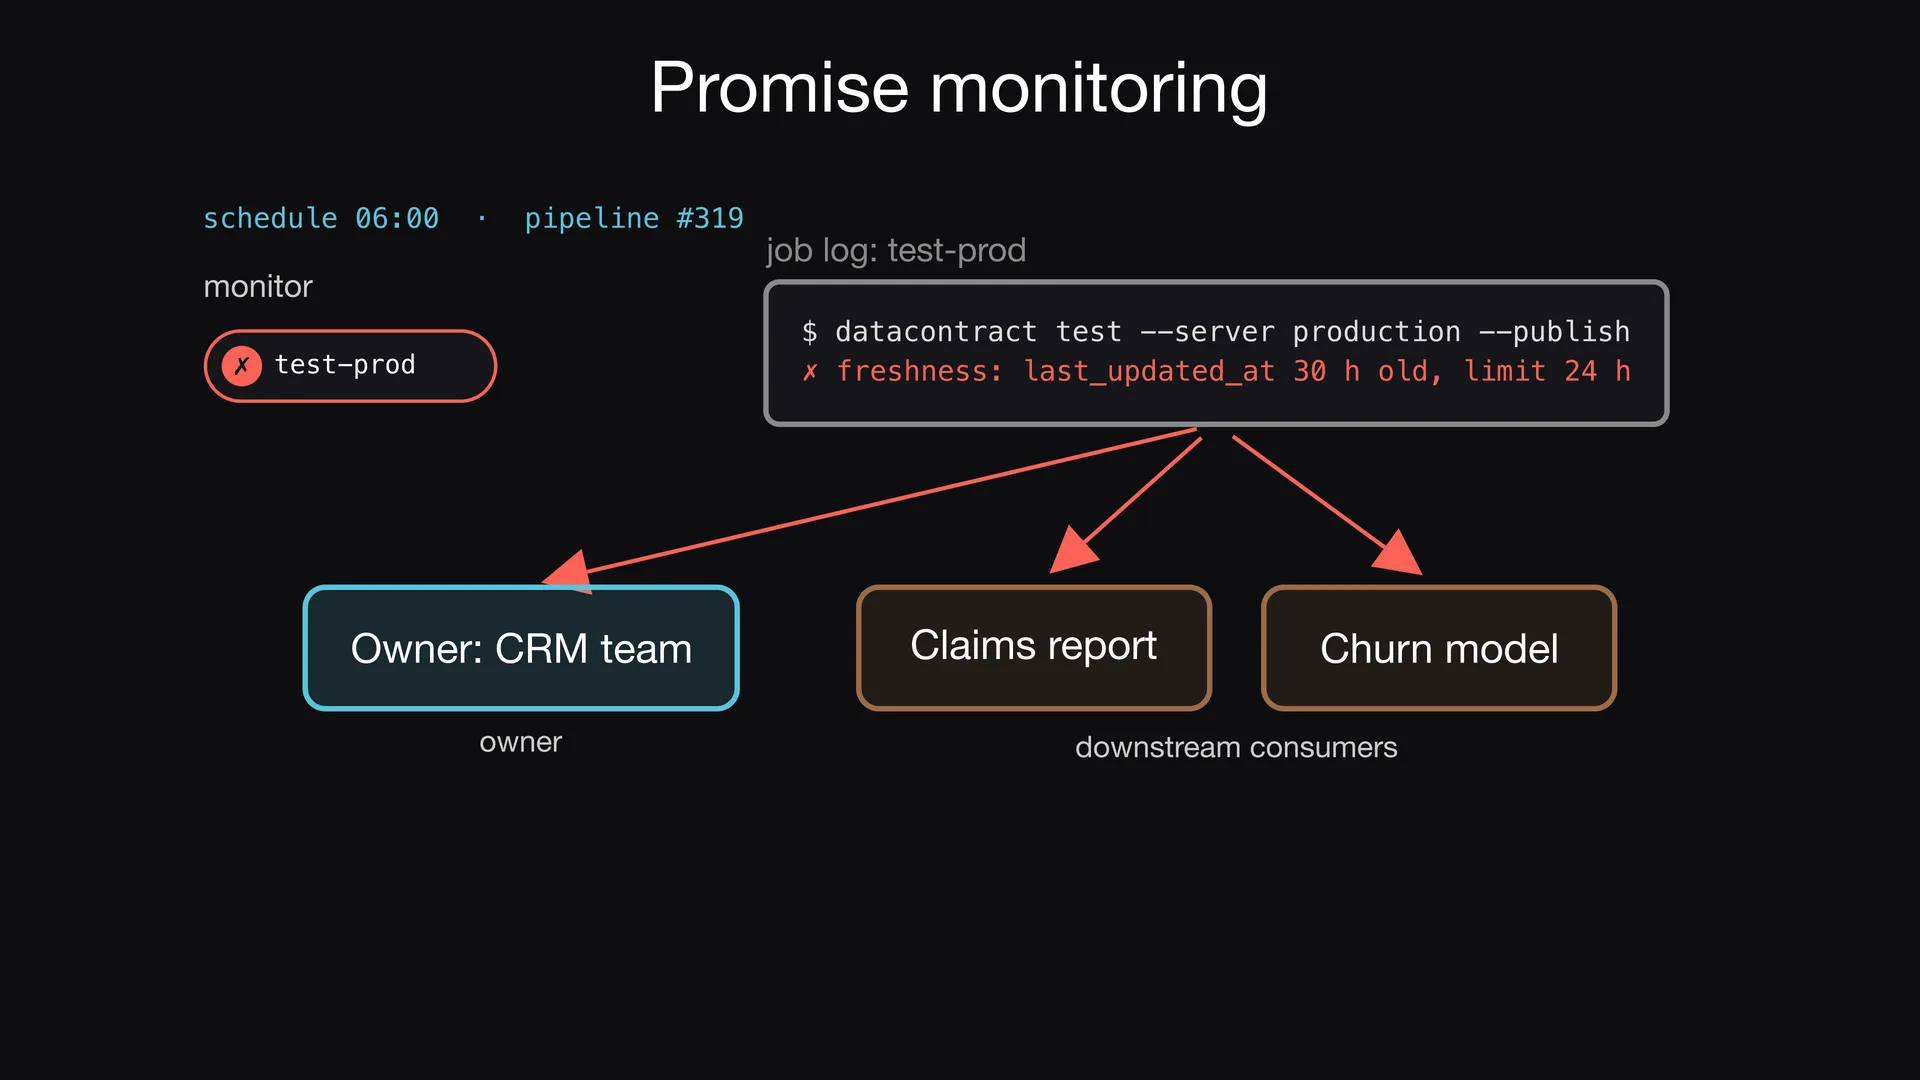
Das Versprechen jede Nacht überwachen
Der Code ändert sich über Nacht nicht, aber es kommen ständig neue Daten. Also testet eine zweite Pipeline jede Nacht die Produktionsdaten. Hier ist die customers-Tabelle 30 Stunden alt, das Limit liegt aber bei 24 Stunden. Der Datenmarktplatz informiert den Owner und die nachgelagerten Consumers.
Bei jedem Commit und jede Nacht
Jeder Commit läuft durch die Pipeline. Jede Nacht testet ein geplanter Job die Daten erneut. So werden Probleme sichtbar, bevor ein Data Consumer falsche Daten nutzt. Der Data Contract wird bei jeder Änderung und an jedem Tag geprüft.