Data Contracts y CI/CD
¿Cómo encajan los Data Contracts en tu pipeline de CI/CD?
Por Dr. Simon Harrer · · video de 2:40 · 9 diapositivas
En resumen
Un Data Contract es un archivo en el repositorio Git del producto de datos. Cada cambio pasa por un pipeline de CI/CD. El pipeline comprueba el Data Contract, prueba los datos en cada entorno y publica los resultados en el marketplace de datos.
Ver en YouTube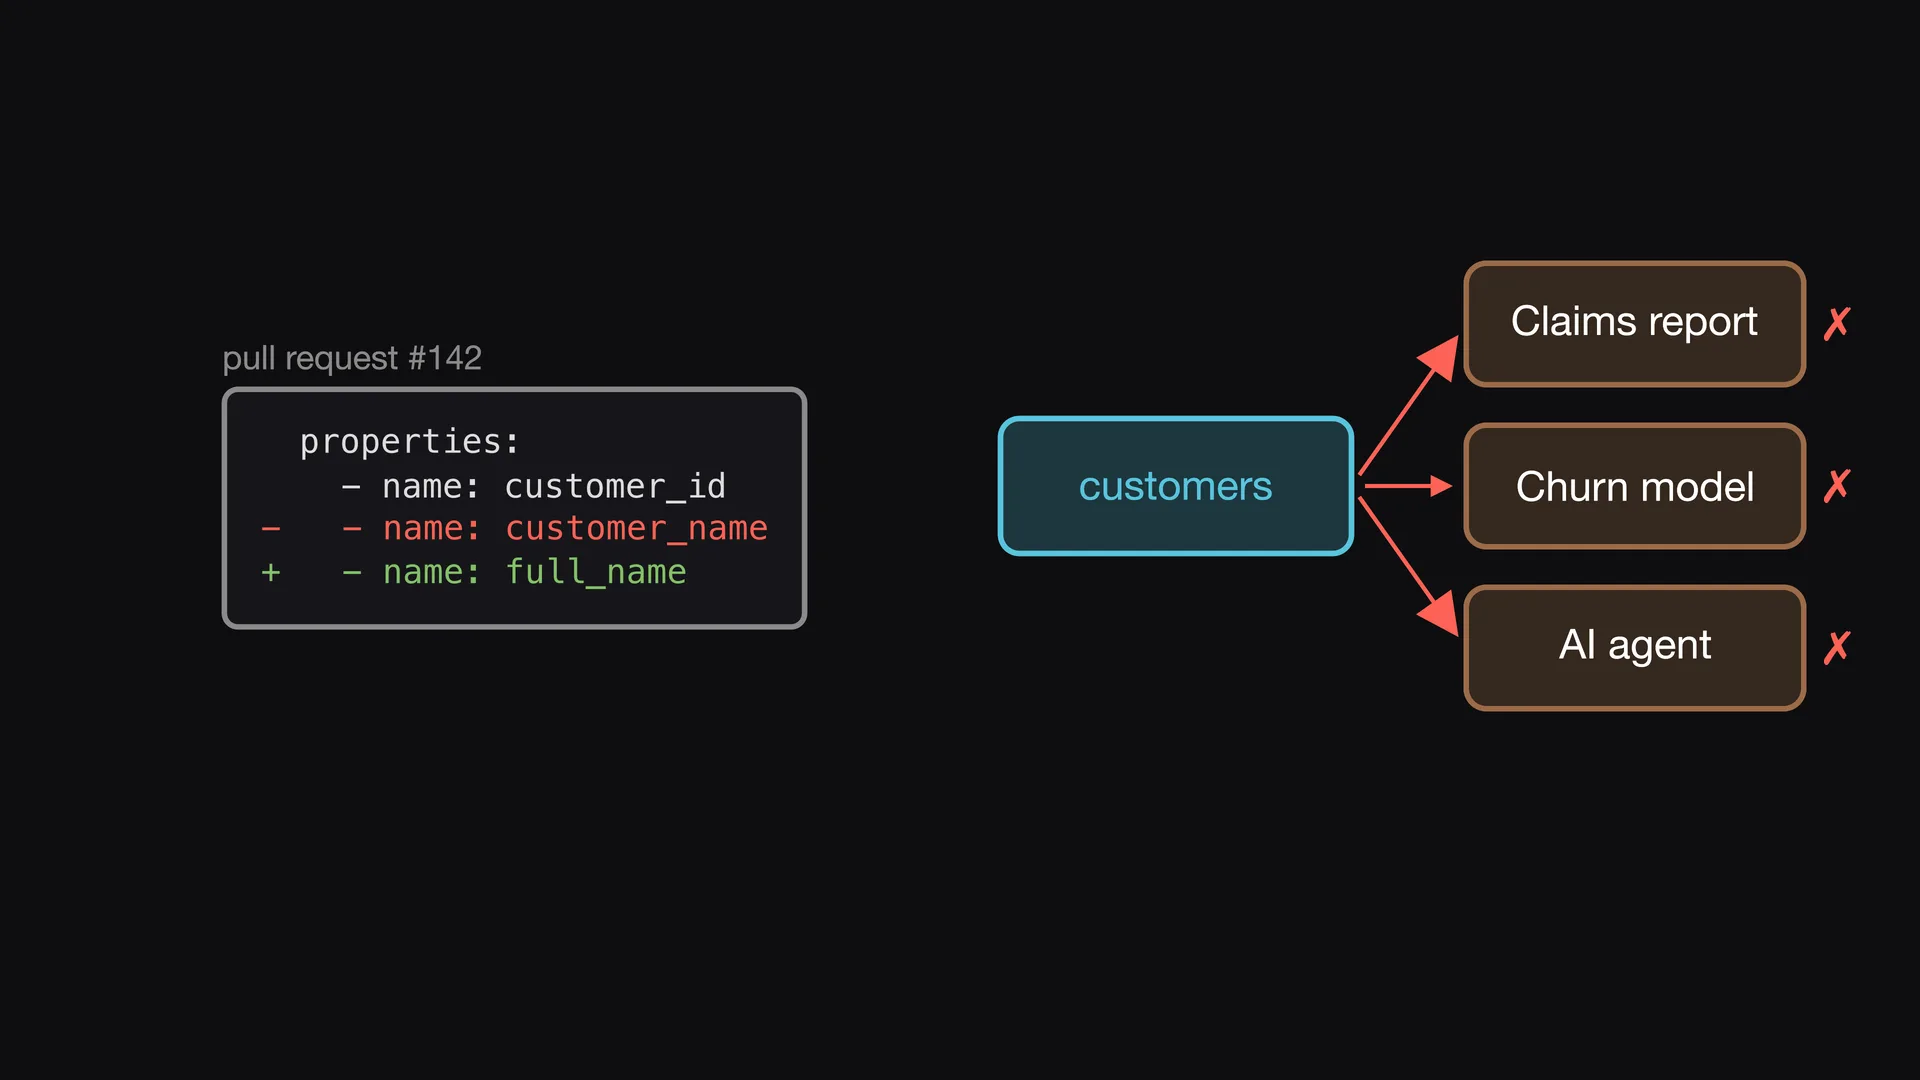
Un cambio de una línea
Un Data Engineer renombra una columna en un pull request: customer name pasa a ser full name. La revisión parece inofensiva. Tras el despliegue, se caen un informe de siniestros, un modelo de churn y un agente de IA. El Data Contract tenía la información, pero nada la comprobaba.
El Data Contract vive en Git
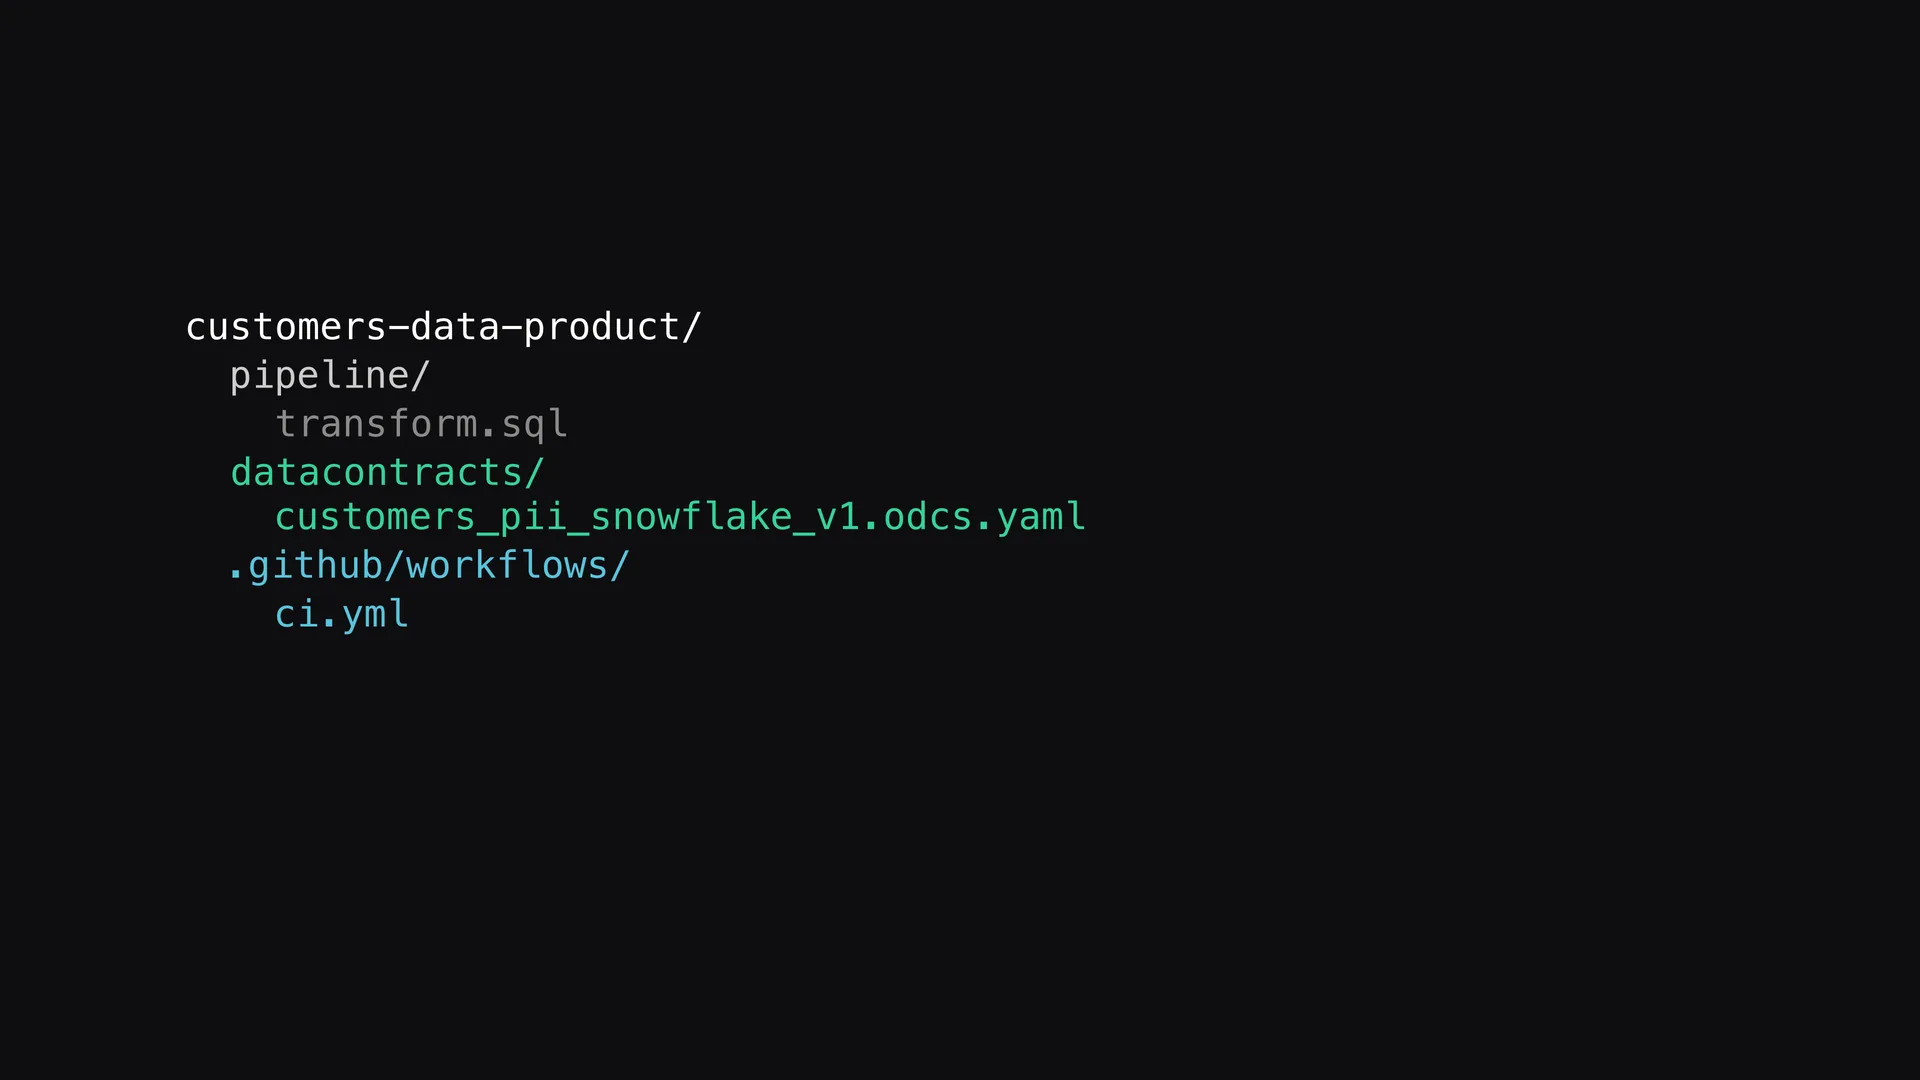
Guarda el Data Contract en el mismo repositorio Git que el código del pipeline. El nombre del archivo indica el dataset, la versión mayor y la plataforma. El código y el Data Contract cambian juntos. Cada commit arranca el pipeline de CI/CD.
Reglas de empresa
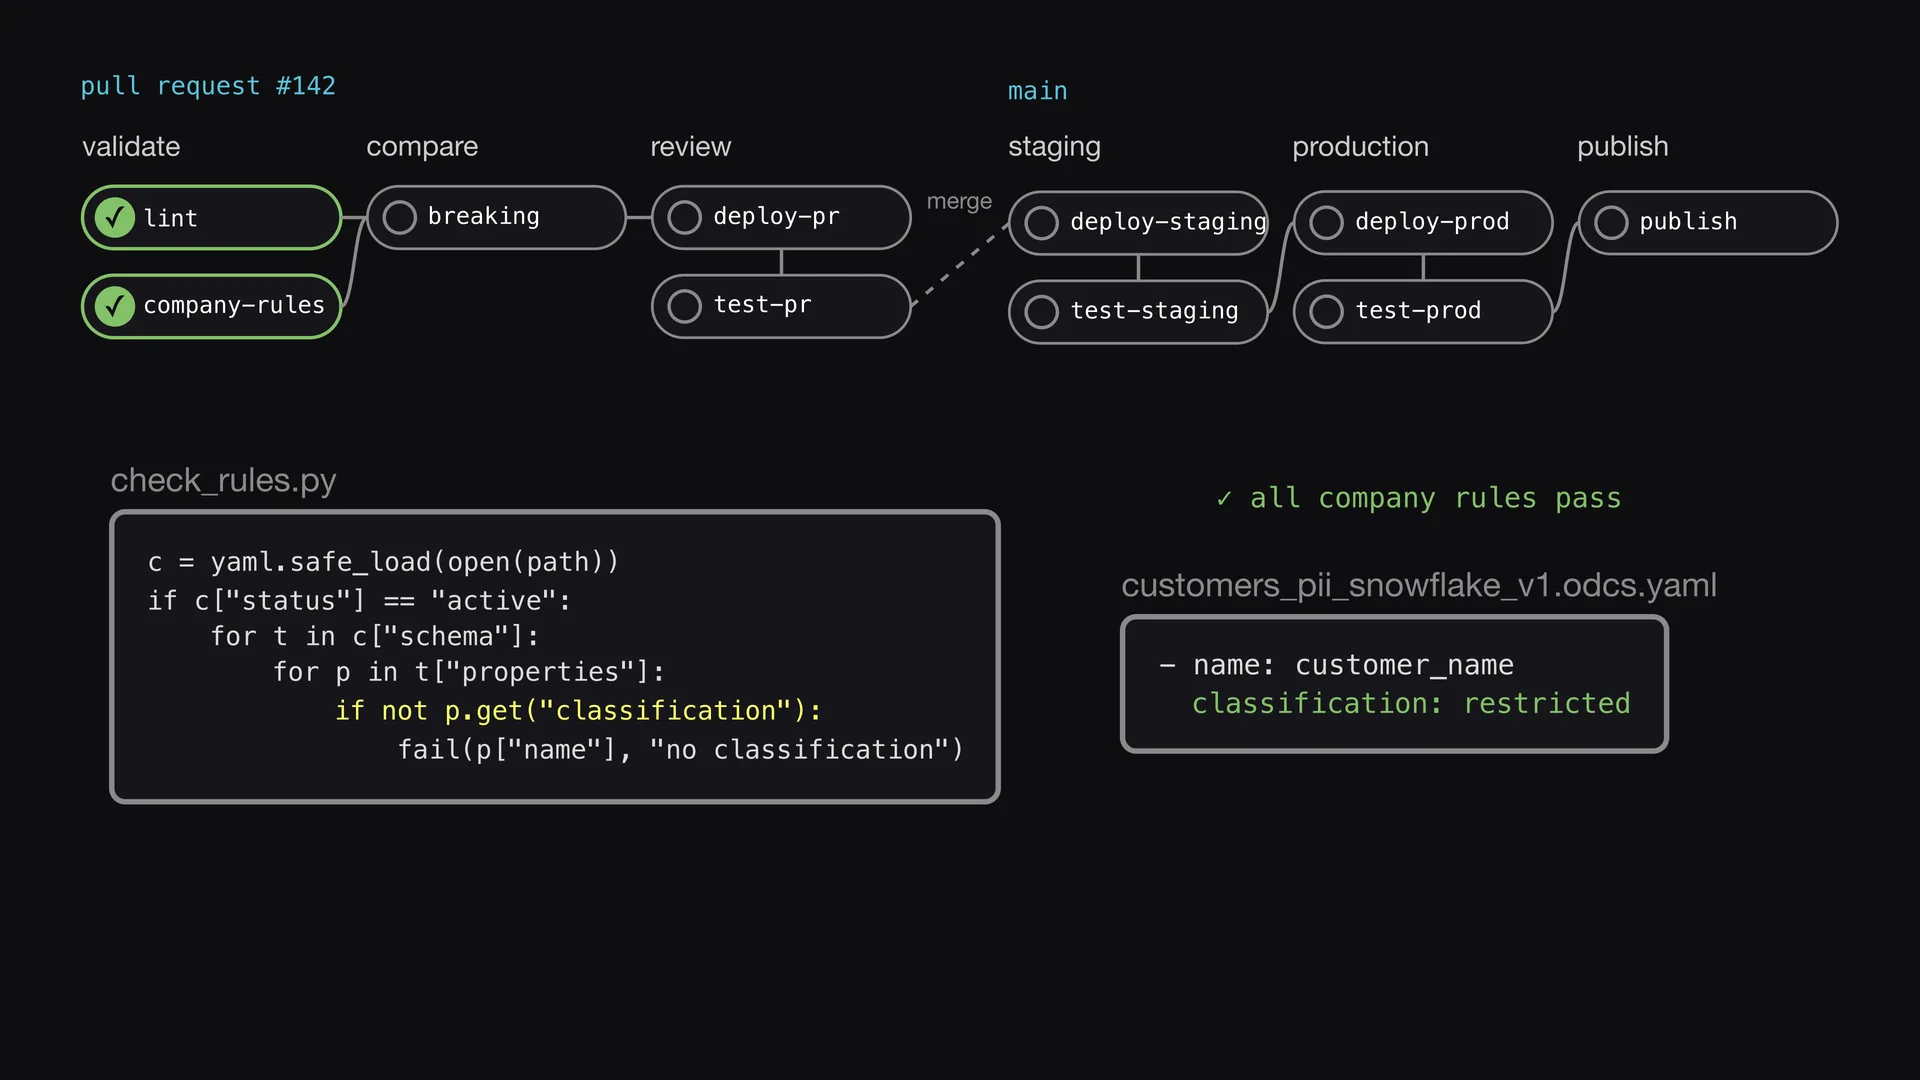
Primero, el job de lint comprueba que el archivo es ODCS válido. Después, un script pequeño de Python comprueba las reglas de tu empresa. Por ejemplo, cada campo de un Data Contract activo debe tener una clasificación. El build se queda parado hasta que cada campo tiene una.
Los cambios incompatibles paran el build
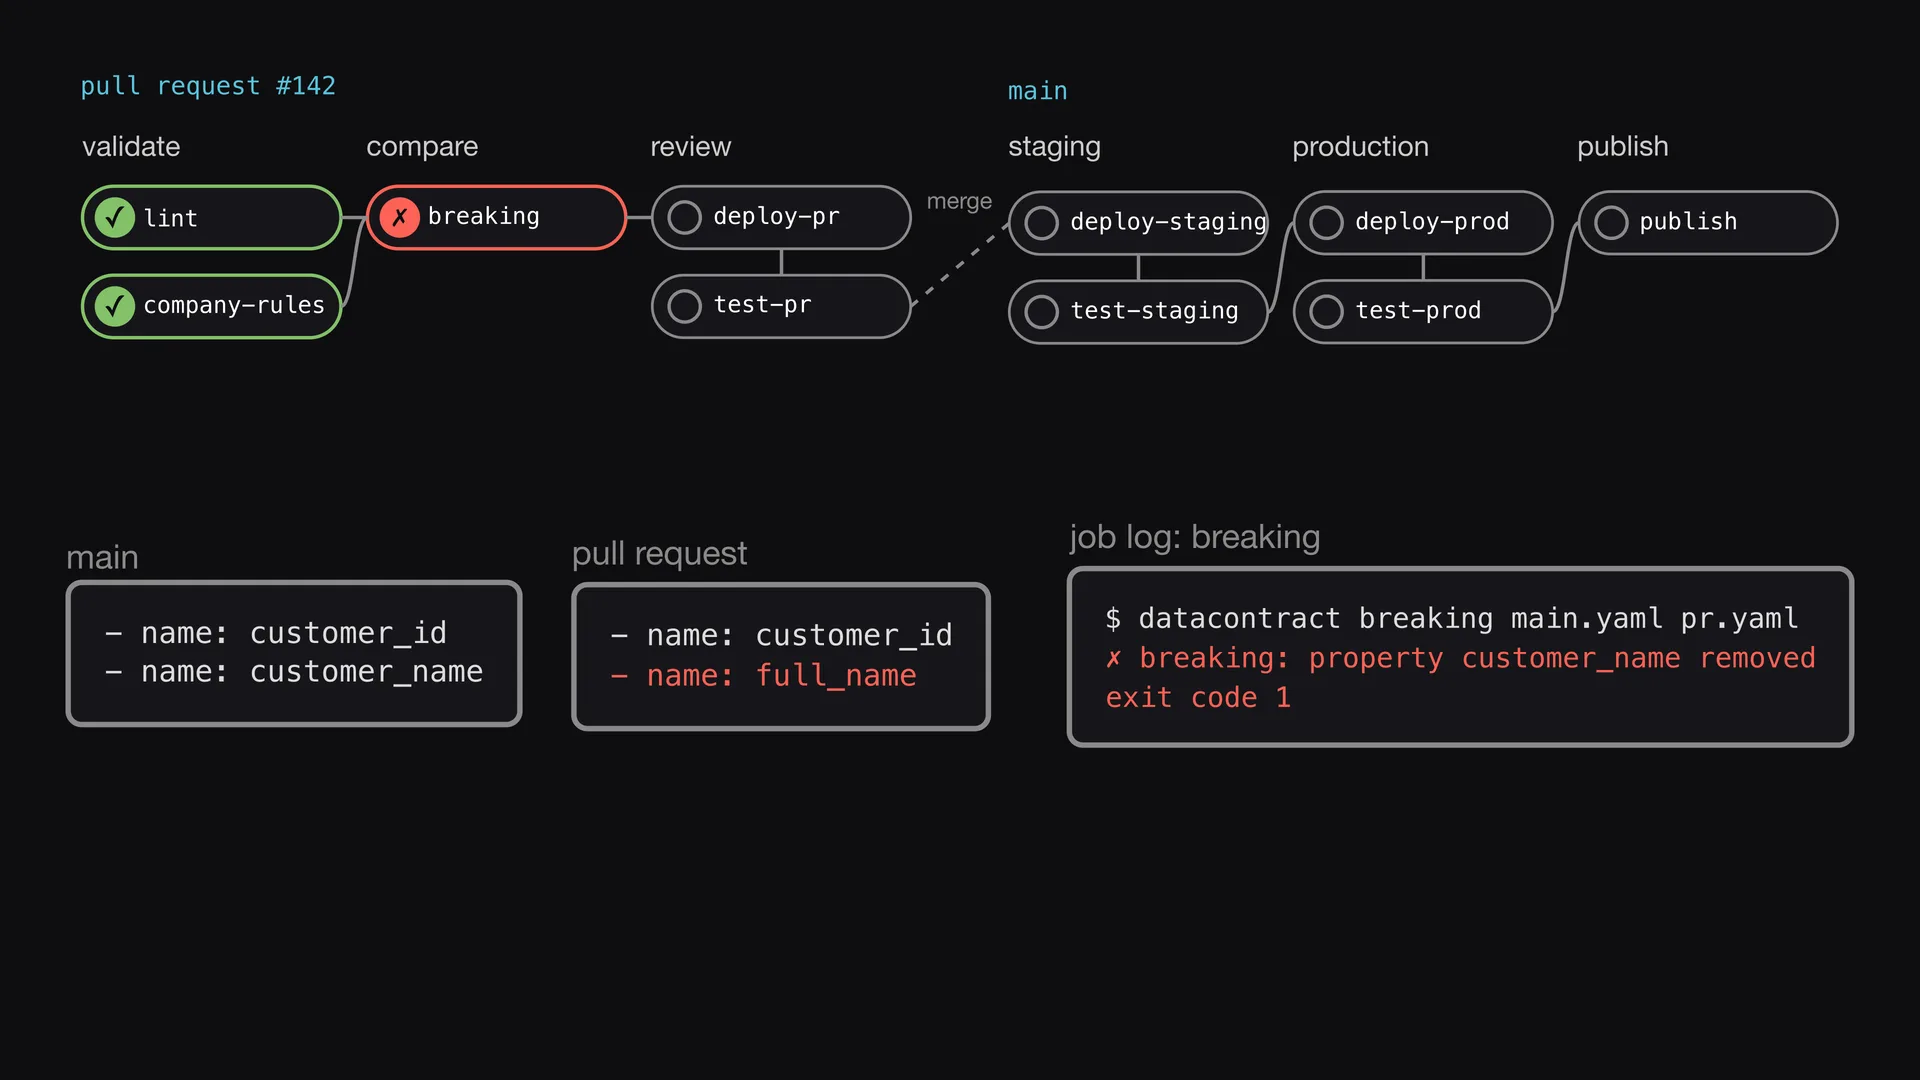
El job siguiente compara el Data Contract modificado con la versión de la rama main. La Data Contract CLI detecta que se ha eliminado una columna. Es un cambio incompatible, así que el build falla antes del merge.
Un esquema por pull request
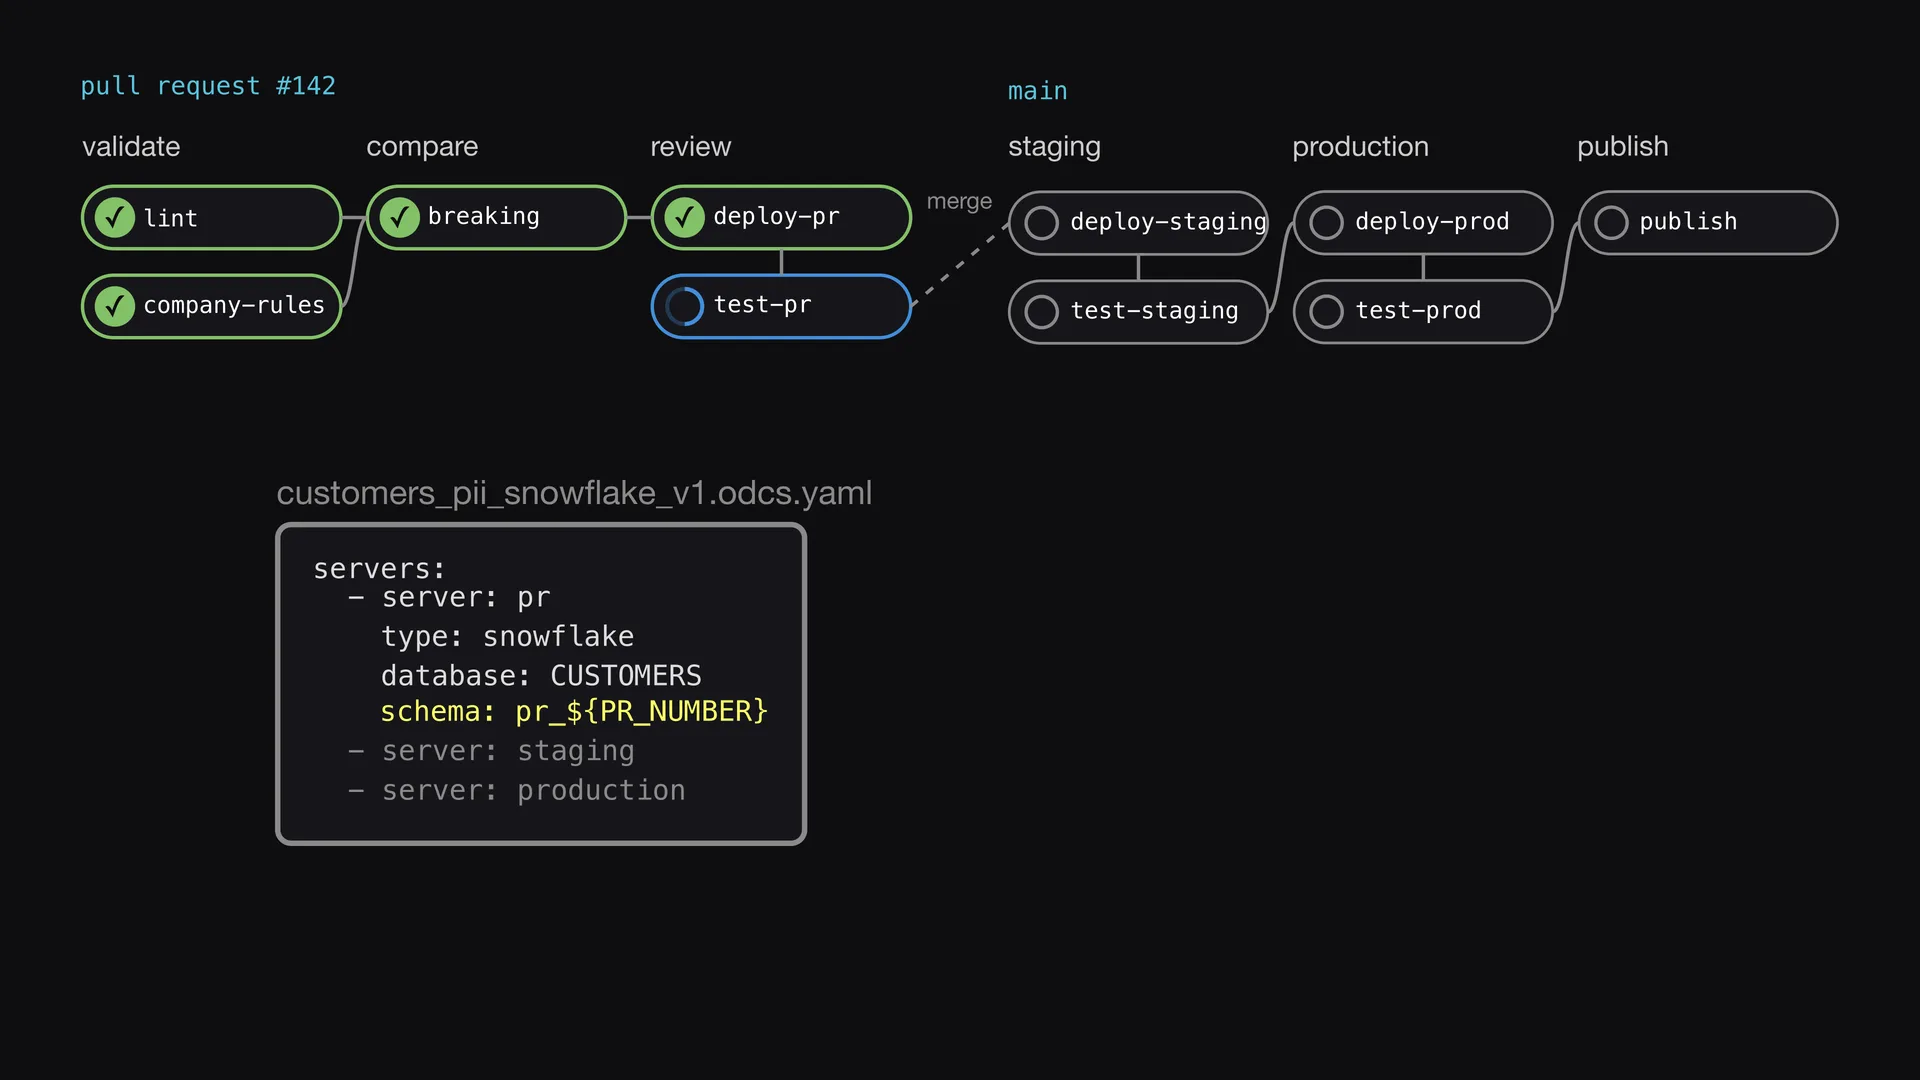
Antes del merge, el pipeline despliega el cambio en su propio entorno. El servidor del Data Contract toma el nombre del esquema de una variable. Así, cada pull request tiene su propio esquema y los tests no tocan los datos de los demás.
Probar otra vez en staging
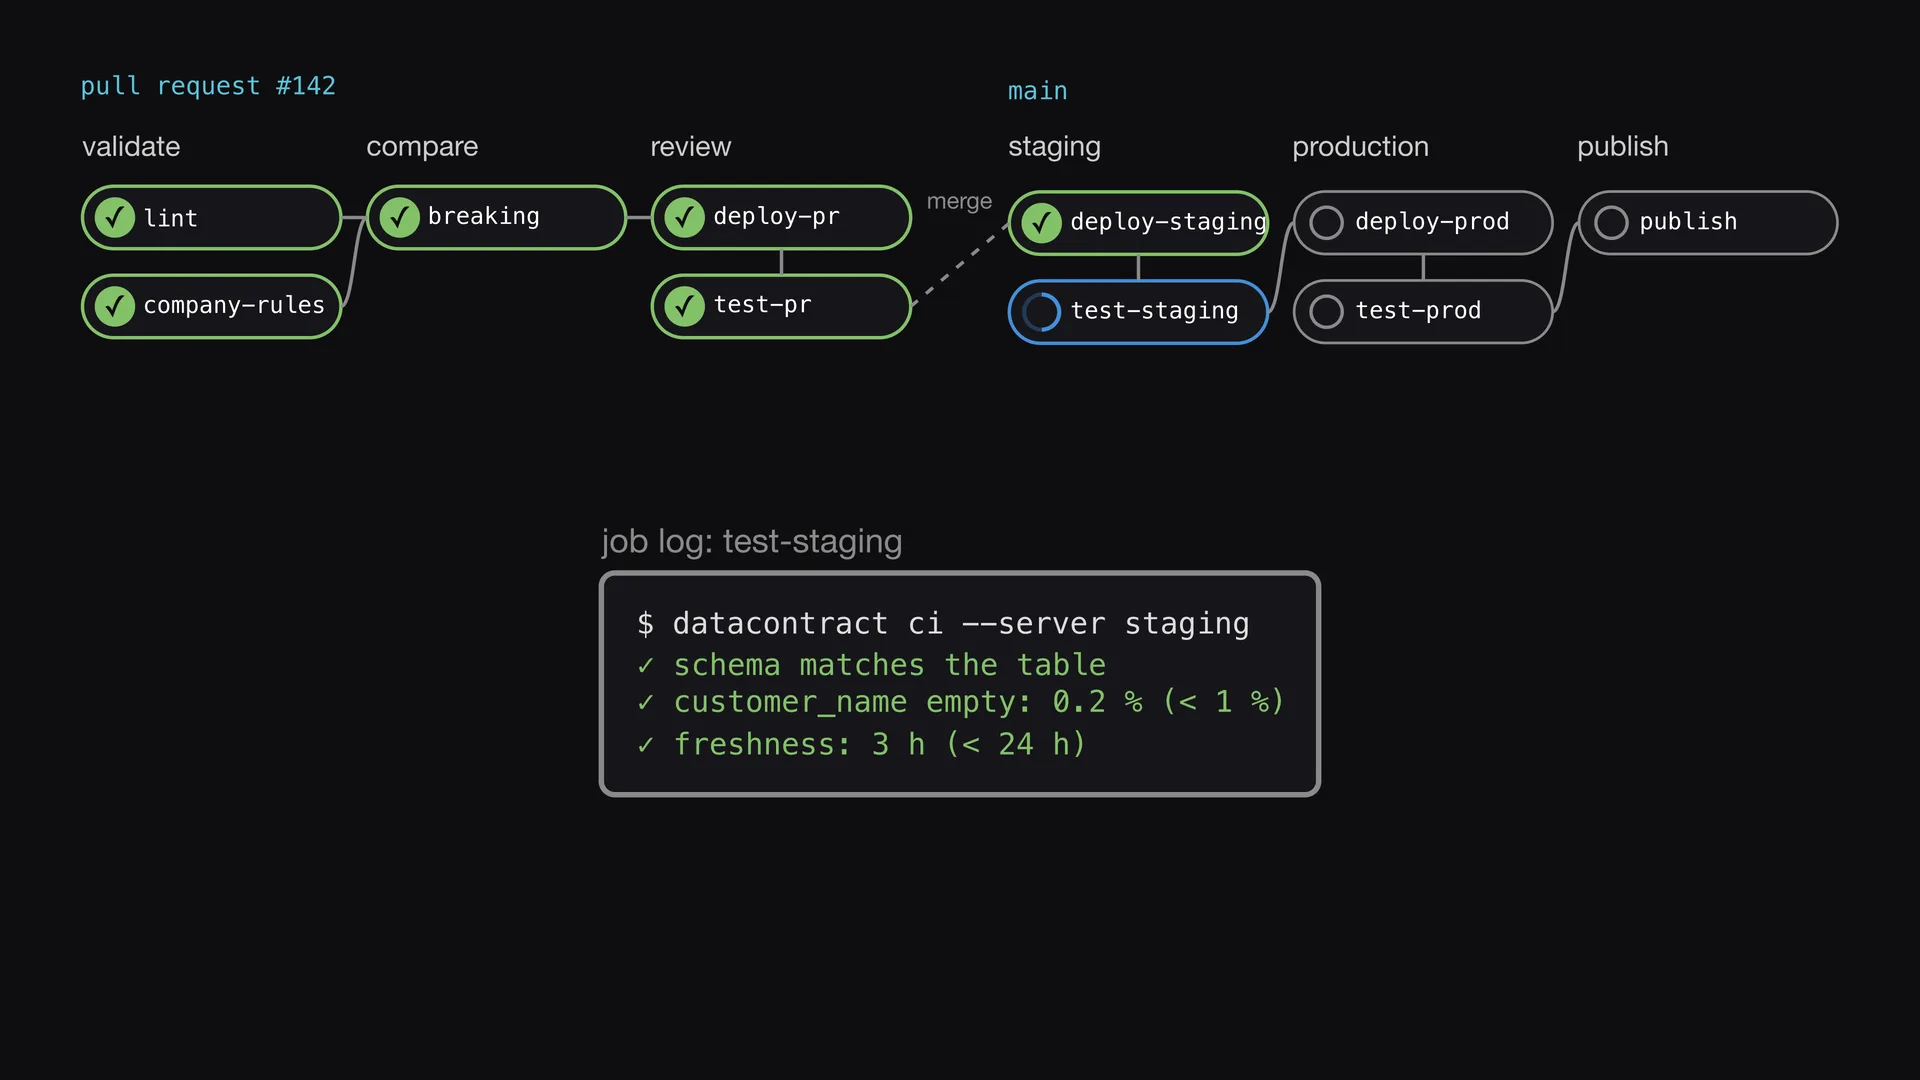
Tras el merge, el pipeline despliega en staging y ejecuta el pipeline de datos. Después prueba otra vez el esquema, las reglas de calidad y la frescura. El pipeline usa el mismo Data Contract en cada entorno. Solo cambia el servidor del Data Contract de un entorno al siguiente.
Publicar cuando todos los jobs están en verde
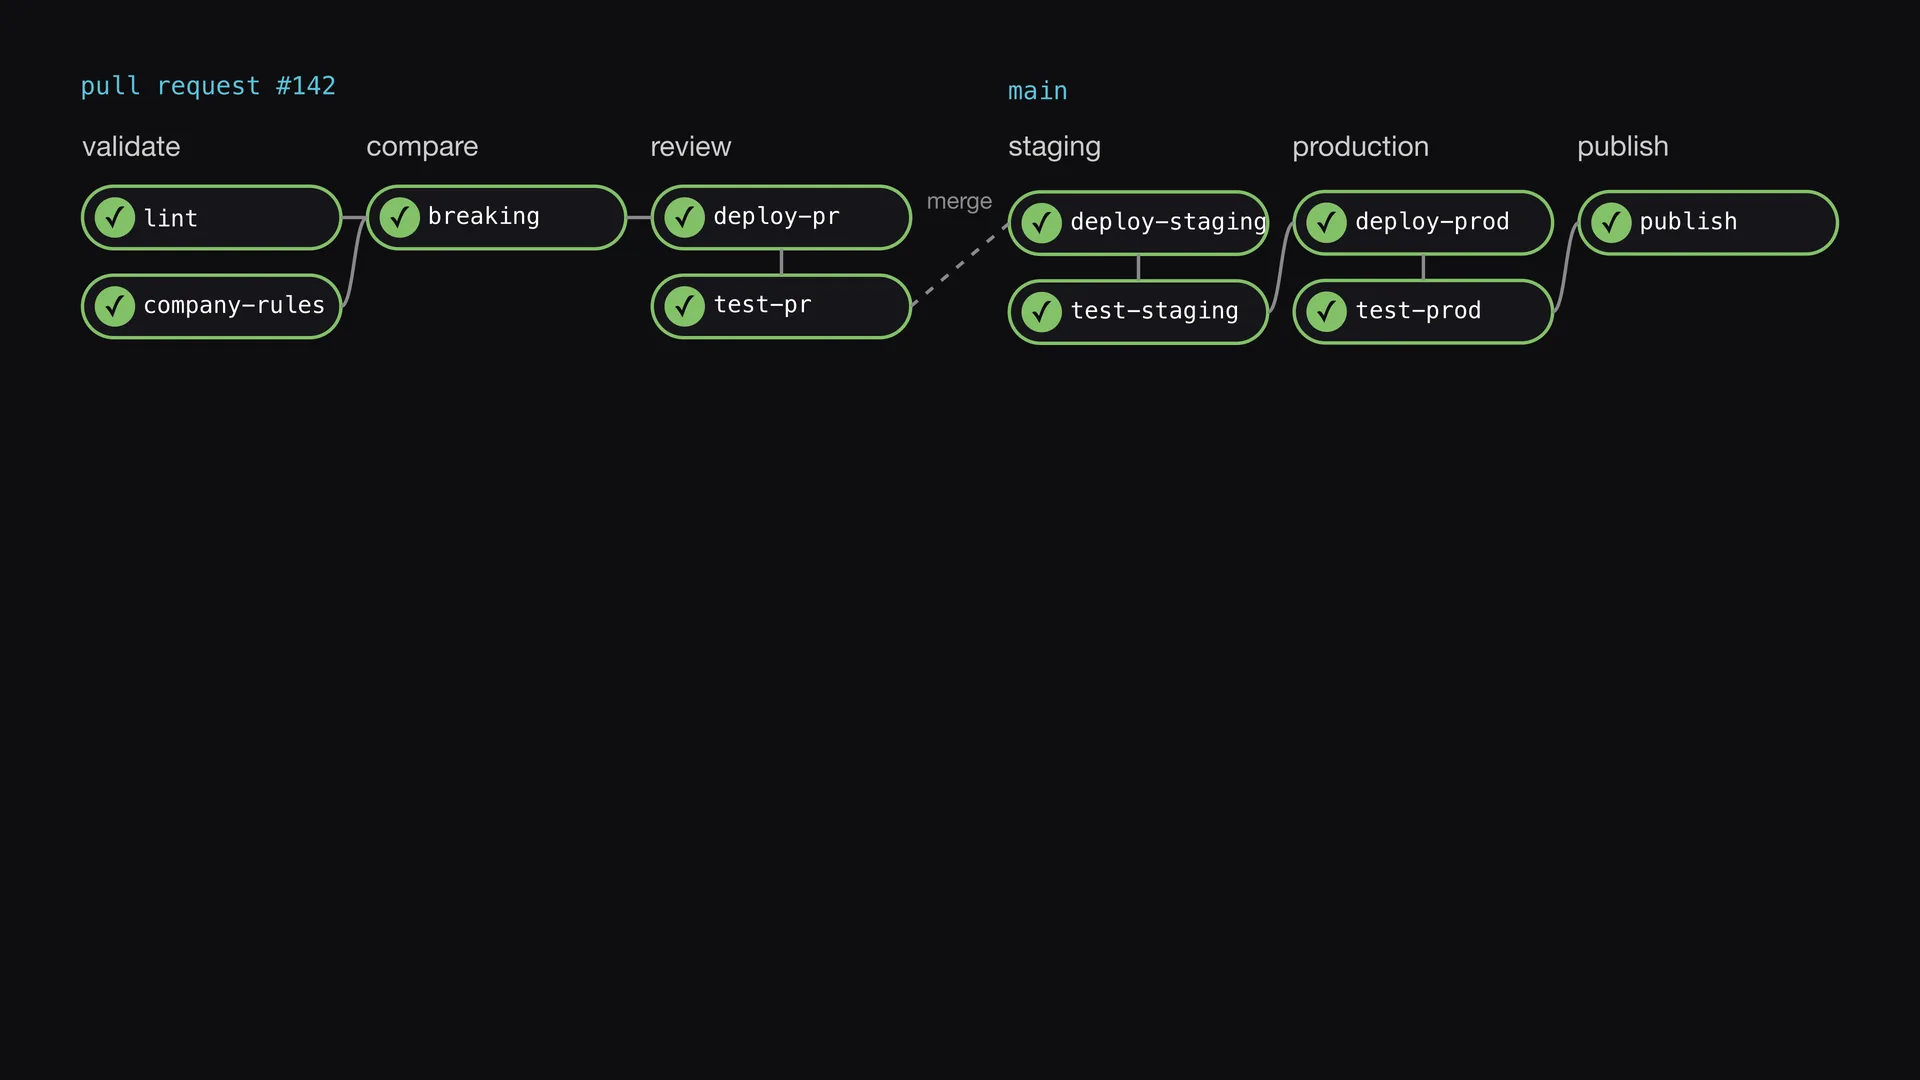
Después, el pipeline despliega en producción y prueba otra vez. Solo cuando cada job está en verde publica el Data Contract y los resultados de los tests en el marketplace de datos. Los Data Consumers ven entonces el estado actual de la promesa.
Vigilar la promesa cada noche
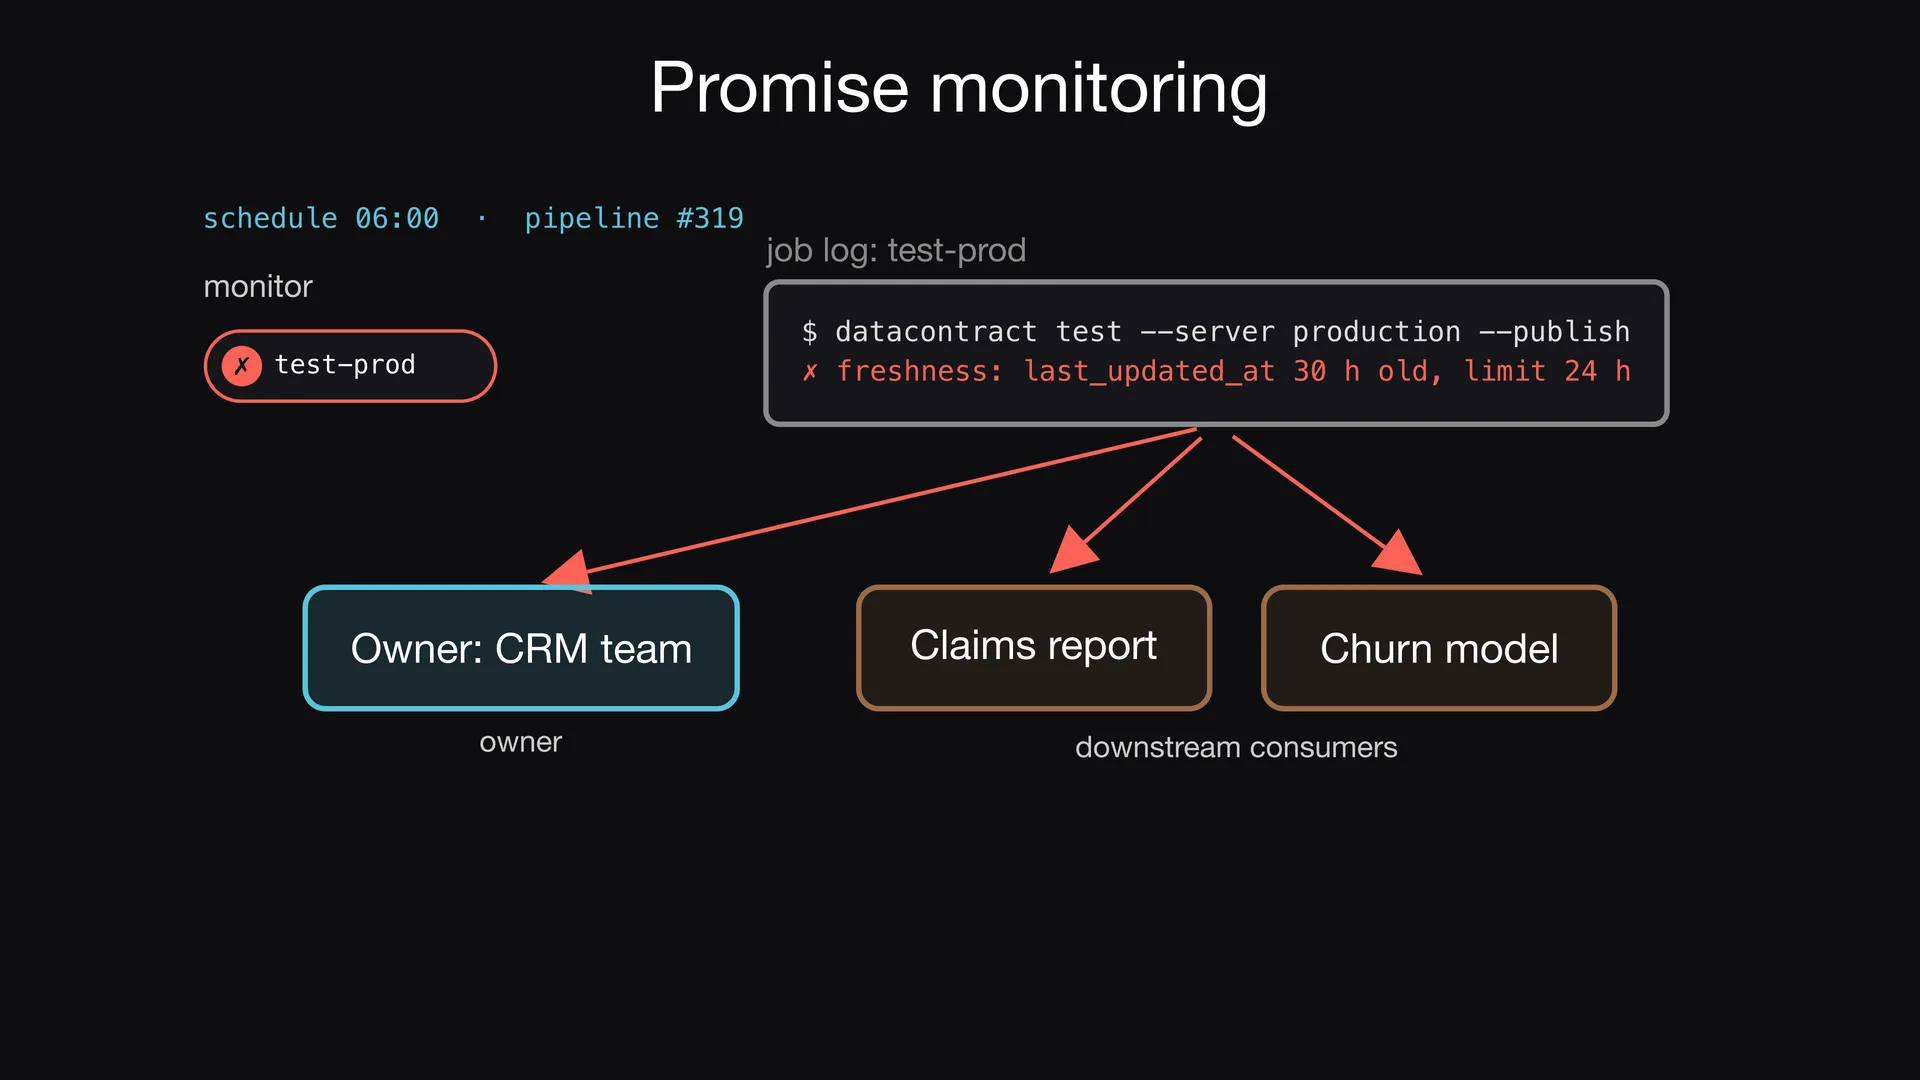
El código no cambia por la noche, pero llegan datos nuevos todo el tiempo. Así que un segundo pipeline prueba los datos de producción cada noche. Aquí, la tabla customers tiene 30 horas, pero el límite es de 24 horas. El marketplace de datos avisa al responsable y a los consumers que están aguas abajo.
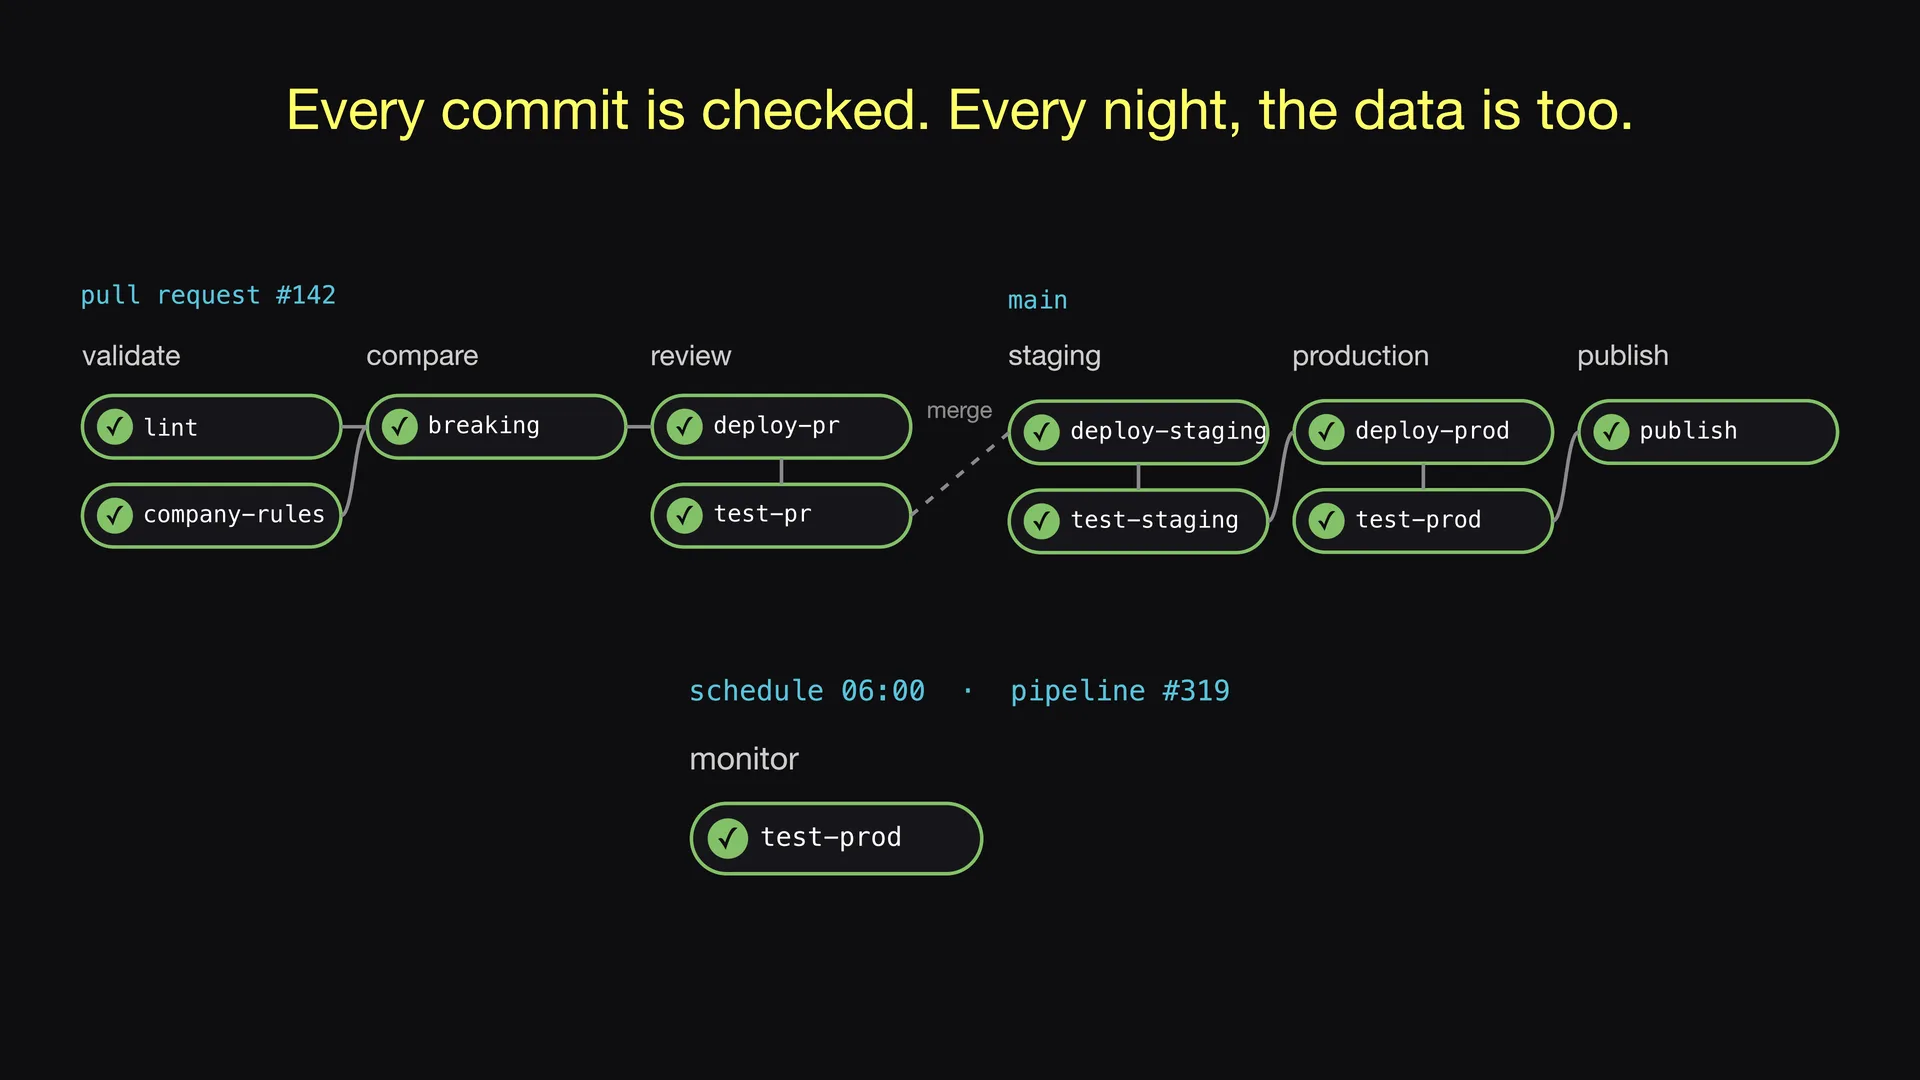
En cada commit y cada noche
Cada commit pasa por el pipeline. Cada noche, un job programado prueba los datos otra vez. Así, los problemas se ven antes de que un Data Consumer use datos incorrectos. El Data Contract se comprueba en cada cambio y cada día.