Artikel
Datenprodukte auf einer offenen Plattform bauen: Stackable + Entropy Data
Dr. Simon Harrer
Co-Founder & CEO, Entropy Data ·
Viele Unternehmen wollen eine moderne Datenplattform, ohne sich an einen Anbieter zu binden. Proprietäre Cloud-Angebote sind schnell eingerichtet, doch Daten, Logik und Wissen landen in einem geschlossenen System. Unsere Demo zeigt einen anderen Weg: eine offene Plattform aus Open Source und offenen Standards, selbst gehostet und vollständig unter deiner Kontrolle.
Die Plattform: Stackable
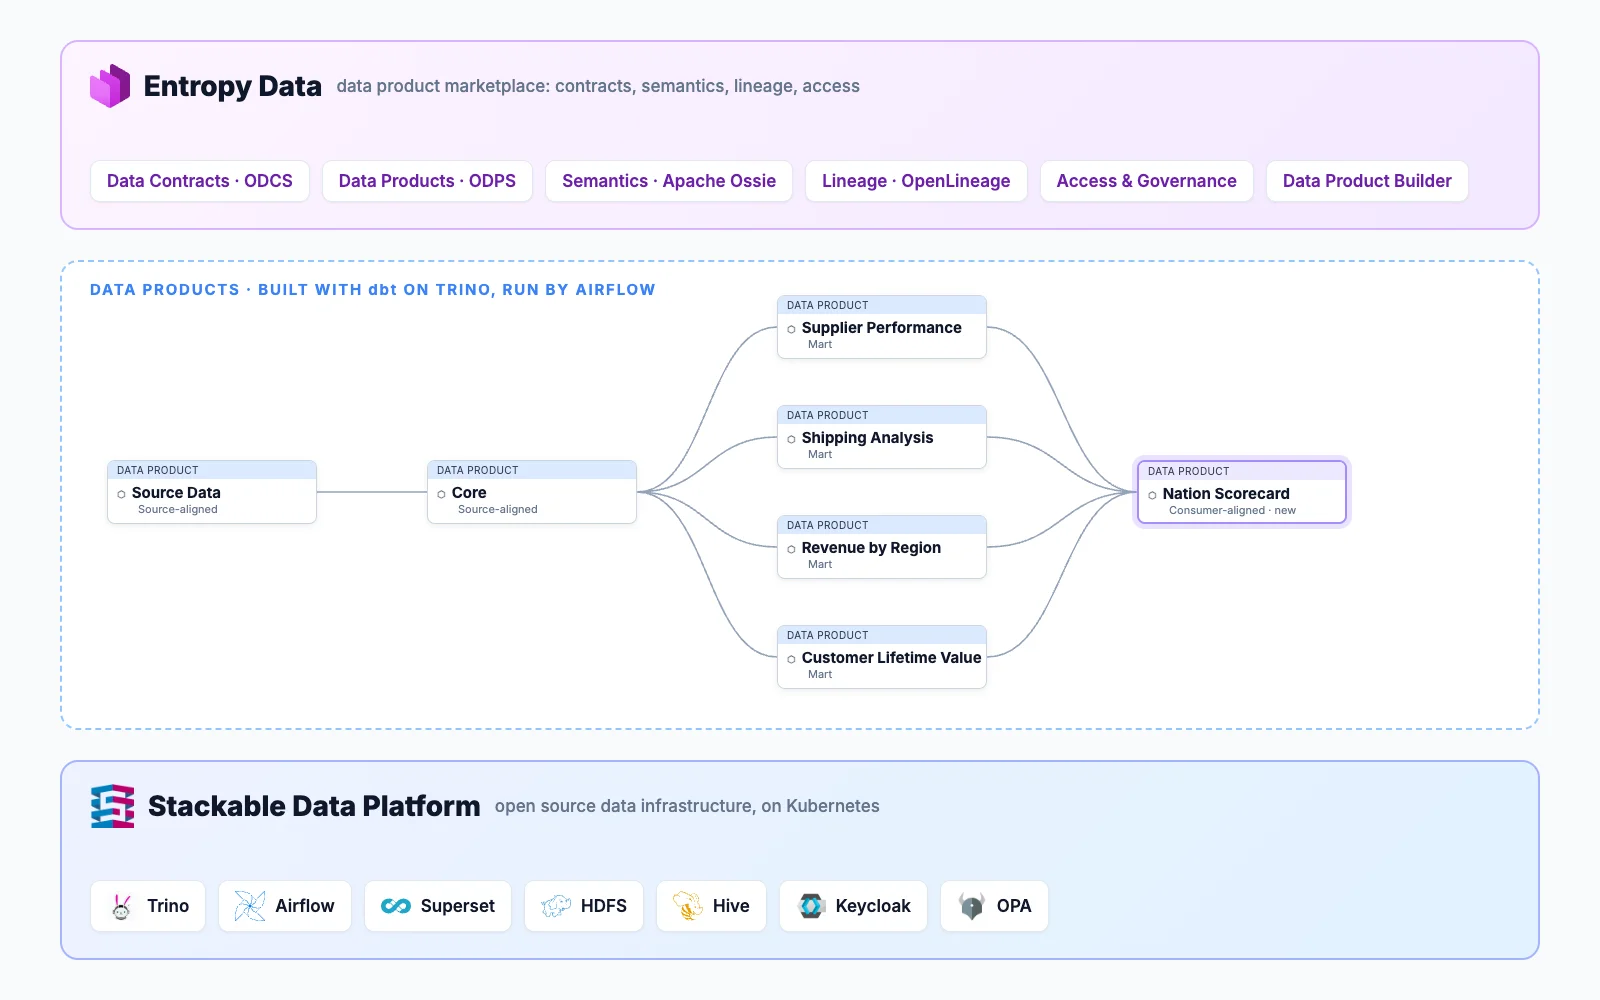
Die Stackable Data Platform bildet das Fundament. Sie bietet bewährte Open-Source-Komponenten wie Trino, Airflow, Superset und OPA auf Kubernetes, egal ob im eigenen Rechenzentrum oder in der Cloud. Die Komponenten sind aufeinander abgestimmt, sicher konfiguriert und werden per GitOps ausgerollt. Für Sicherheit und Support sorgt Stackable, ohne dass ein Vendor Lock-in entsteht.
Der Datenmarktplatz: Entropy Data
Auf der Plattform entstehen Datenprodukte, die aufeinander aufbauen. Entropy Data macht sie als Datenmarktplatz auffindbar und nutzbar. Jedes Datenprodukt hat einen Data Contract, der beschreibt, welche Daten es liefert, was sie bedeuten und in welcher Qualität. Eine gemeinsame Business-Ontologie verbindet Begriffe wie Kunde, Land oder Marke über alle Datenprodukte hinweg. Lineage zeigt, wie die Daten fließen, und Zugriffe werden über den Datenmarktplatz beantragt und genehmigt. Trino prüft bei jeder Abfrage, ob der Zugriff erlaubt ist.
Alles basiert auf offenen Standards: dem Open Data Contract Standard (ODCS) für Data Contracts, dem Open Data Product Standard (ODPS) für Datenprodukte, Apache Ossie für die Ontologie und OpenLineage für Lineage.
Contract-first, mit einem Coding Agent
Im Video bauen wir eine „Nation Scorecard“: eine Übersicht, wie sich jedes Land als Markt entwickelt, mit Umsatz, Kundenwert, Lieferqualität und lokalen Lieferanten.
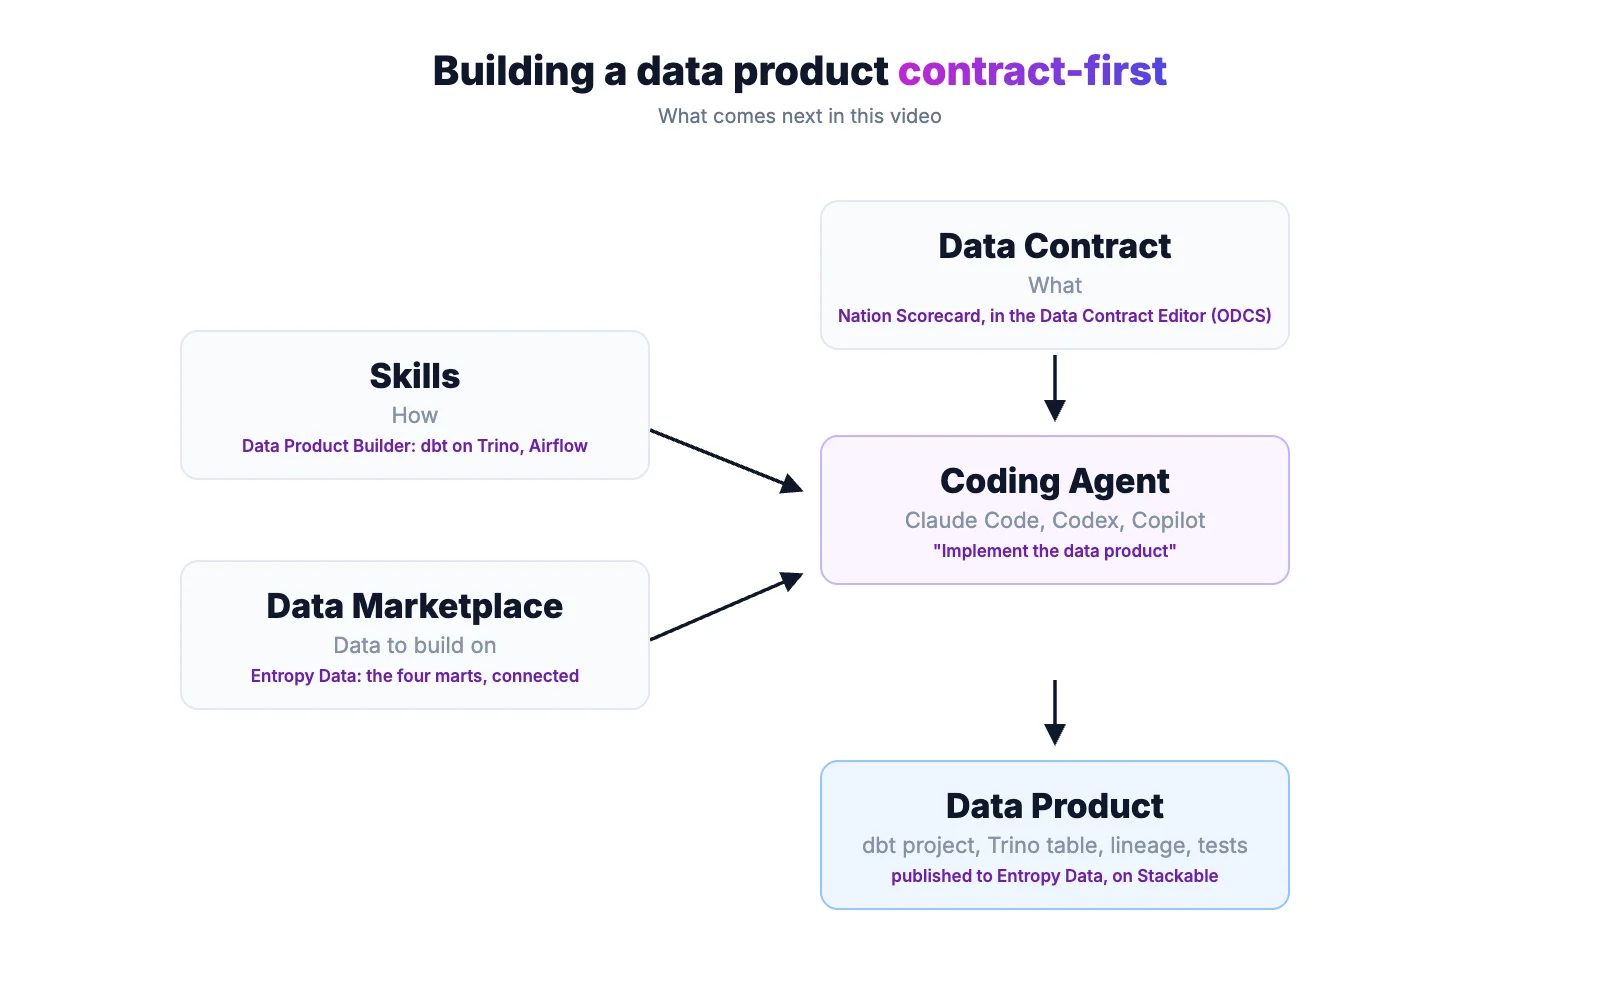
Zuerst kommt der Data Contract. Er beschreibt, was entstehen soll, bevor eine Zeile Code existiert. Land und Region werden nicht neu definiert, sondern aus der Business-Ontologie übernommen. Aus dem Data Contract entsteht mit einem Klick das Datenprodukt.
Die Umsetzung übernimmt ein Coding Agent. Er erhält drei Dinge: den Data Contract als Beschreibung, was zu bauen ist; Skills, die die Konventionen der Plattform kennen; und den Datenmarktplatz mit den Daten, auf denen er aufbauen kann. Die Anweisung ist ein einziger Satz: „Implementiere das Datenprodukt.“ Der Agent analysiert das Zielbild, sucht sich über den Datenmarktplatz die nötigen bestehenden Datenprodukte, besorgt sich Zugriff auf deren Daten, legt das dbt-Projekt an, baut die Tabelle in Trino inklusive Datenpipeline, testet die gefüllte Tabelle mit der Open-Source-Data Contract CLI gegen den Data Contract und veröffentlicht alles im Datenmarktplatz, inklusive Lineage. Nach wenigen Minuten ist das neue Datenprodukt aktiv. So arbeitet der Data Product Builder.
Freie Wahl auf jeder Ebene
Die Demo zeigt eine mögliche Zusammenstellung, keine feste. Auf der Plattform-Ebene lässt sich Stackable erweitern: Stackable bringt Operatoren für weitere Komponenten wie Spark, Druid oder HBase mit, und weil alles auf Kubernetes läuft, finden auch eigene Dienste und bestehende Systeme ihren Platz.
Auf der Governance-Ebene gilt dasselbe. Entropy Data setzt auf ODCS, ODPS, Apache Ossie und OpenLineage, sodass sich weitere Werkzeuge anbinden lassen, etwa ein vorhandener Datenkatalog, eigene Qualitäts-Checks oder zusätzliche Regeln in OPA. Data Contracts und Datenprodukte liegen als offene Standards in deinem eigenen Git-Repository. Die Entscheidung, welche Werkzeuge zum Einsatz kommen, bleibt bei dir.
Warum das zusammenpasst
Offene Standards sind dabei mehr als ein Prinzip. Sie geben dem Agent einen klaren Rahmen: Der Data Contract ist maschinenlesbar, die Tests sind deterministisch, und das Ergebnis lässt sich überprüfen. So wird aus einer Anweisung ein verlässliches Ergebnis.
Die Rolle des Menschen verschiebt sich: weg vom Programmieren, hin zur Frage, was gebaut werden soll und welchen Wert es stiftet. Die Plattform sorgt dafür, dass jedes neue Datenprodukt auf offenen Standards steht und sich nahtlos in die bestehende Datenlandschaft einfügt. Mehr zu dieser Arbeitsweise zeigt der Talk Building a Data Product Contract-first (with AI) (Englisch).
Wer tiefer einsteigen will: Die gesamte Demo ist offen auf GitHub verfügbar, inklusive Plattform-Konfiguration, Datenprodukten und Skills: github.com/entropy-data/entropydata-stackable-showcase.
Sprechen wir darüber
Du möchtest eine offene Datenplattform aufbauen oder Datenprodukte contract-first entwickeln? Melde dich bei uns:
- Stackable Data Platform: Sönke Liebau, CPO & Co-Founder von Stackable, auf LinkedIn.
- Entropy Data: Dr. Simon Harrer, CEO & Co-Founder von Entropy Data, auf LinkedIn.
Über den Autor
Dr. Simon Harrer
LinkedIn von Simon HarrerCo-Founder & CEO, Entropy Data
Simon baut Tools, die Daten, Menschen und KI zusammenarbeiten lassen. Er hat in verteilten Systemen promoviert, war sieben Jahre als Softwarearchitekt und Consultant bei INNOQ und hat Entropy Data mitgegründet, das er als CEO führt.