Artículo
Construir productos de datos sobre una plataforma abierta: Stackable + Entropy Data
Dr. Simon Harrer
Co-Founder & CEO, Entropy Data ·
Muchas empresas quieren una plataforma de datos moderna sin atarse a un único proveedor. Las ofertas cloud propietarias se configuran rápido, pero los datos, la lógica y el conocimiento terminan en un sistema cerrado. Nuestra demo muestra otro camino: una plataforma abierta construida con open source y estándares abiertos, autoalojada y totalmente bajo tu control.
La plataforma: Stackable
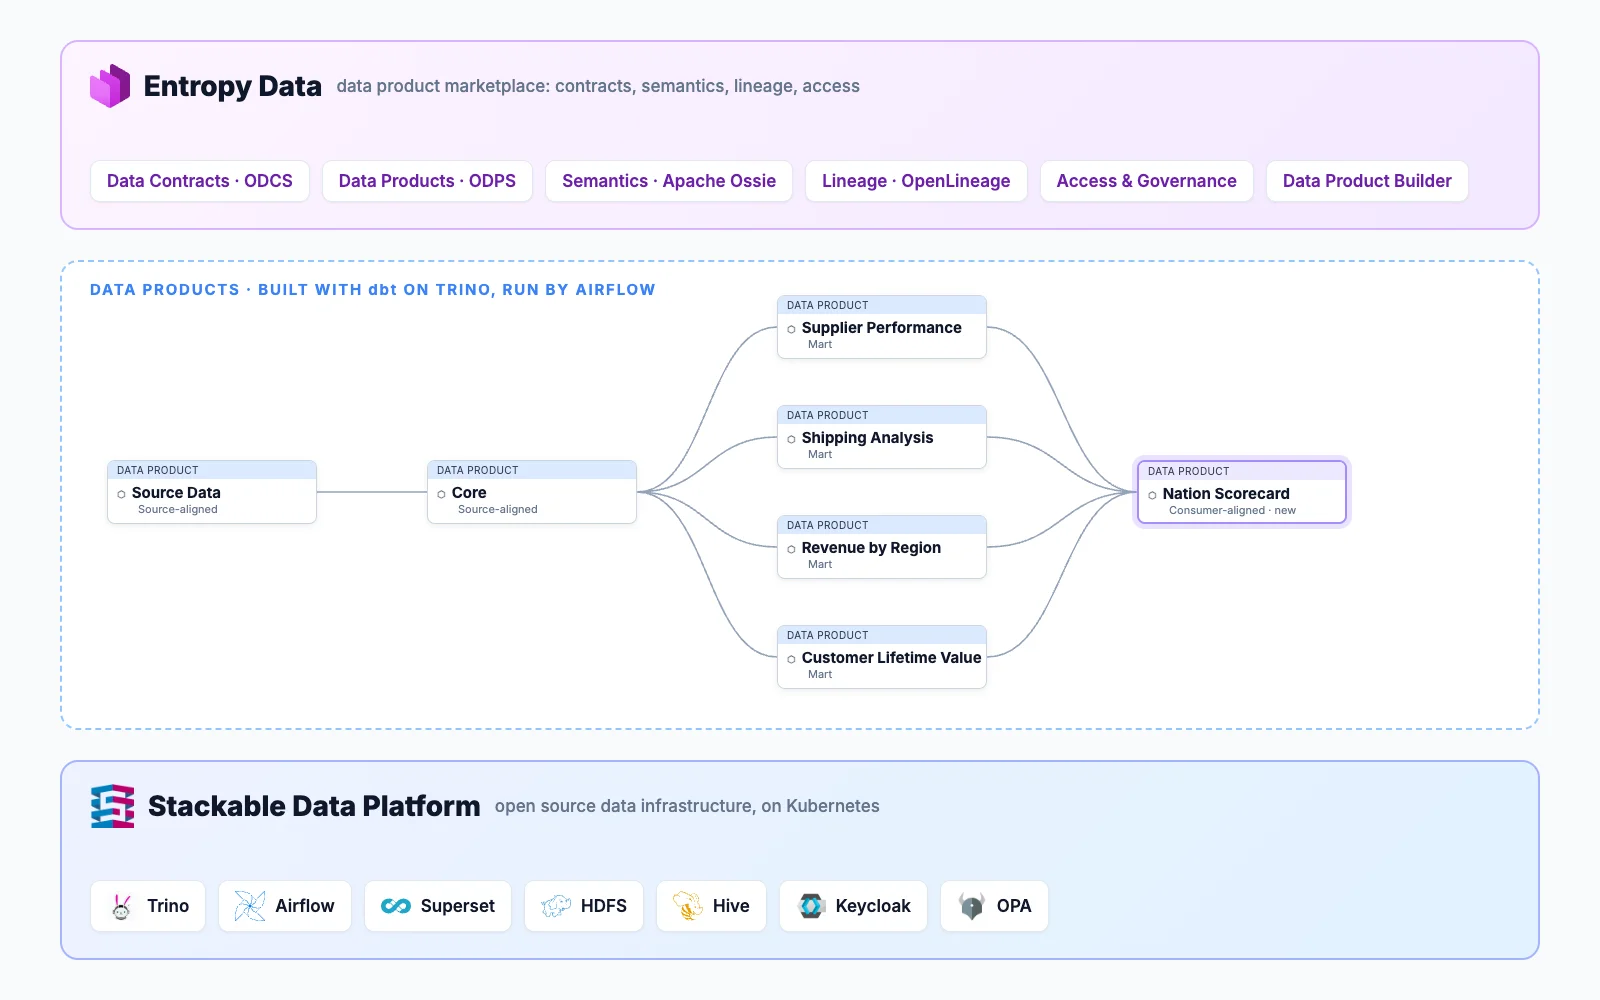
La Stackable Data Platform es la base. Ofrece componentes open source probados como Trino, Airflow, Superset y OPA sobre Kubernetes, ya sea en tu propio centro de datos o en la nube. Los componentes están ajustados para funcionar juntos, configurados de forma segura y se despliegan con GitOps. Stackable se encarga de la seguridad y el soporte, sin crear dependencia de un proveedor.
El marketplace: Entropy Data
Sobre la plataforma surgen productos de datos que se construyen unos sobre otros. Entropy Data los hace localizables y utilizables como marketplace de datos. Cada producto de datos tiene un Data Contract que describe qué datos entrega, qué significan y con qué calidad. Una ontología de negocio compartida conecta términos como cliente, país o marca en todos los productos de datos. El data lineage muestra cómo fluyen los datos, y el acceso se solicita y se aprueba a través del marketplace. En cada consulta, Trino comprueba si el acceso está permitido.
Todo se basa en estándares abiertos: el Open Data Contract Standard (ODCS) para los Data Contracts, el Open Data Product Standard (ODPS) para los productos de datos, Apache Ossie para la ontología y OpenLineage para el data lineage.
Contract-first, con un coding agent
En el video construimos un «Nation Scorecard»: una vista de cómo evoluciona cada país como mercado, con ingresos, valor del cliente, calidad de entrega y proveedores locales.
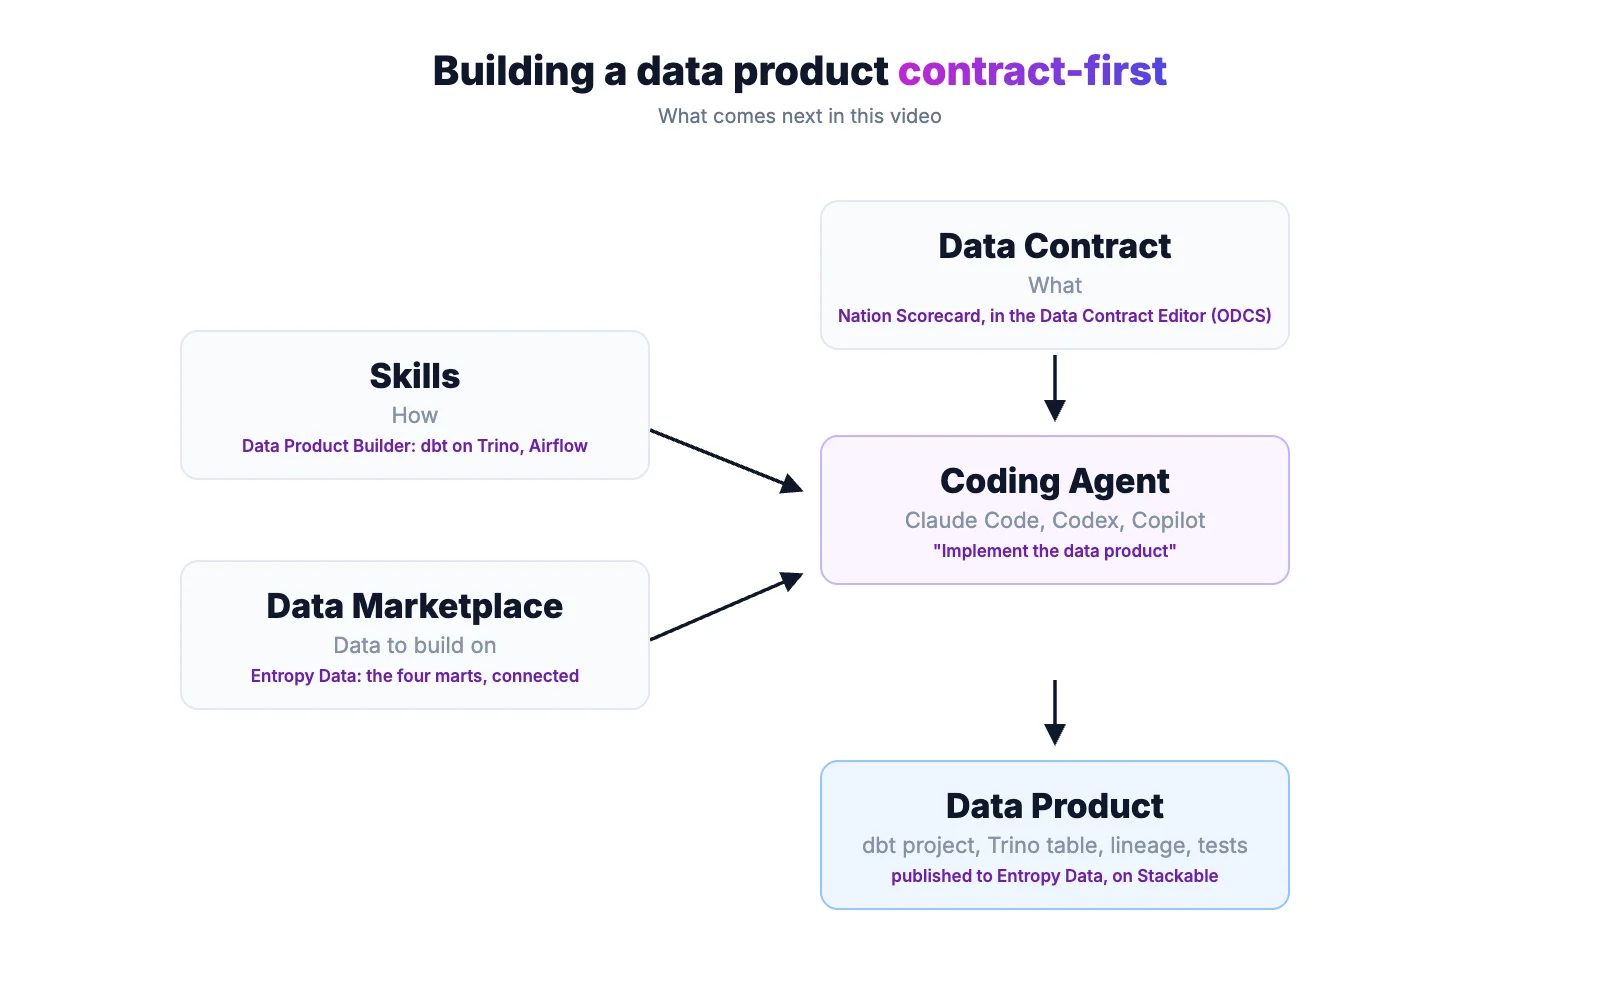
Primero va el Data Contract. Describe lo que se va a construir antes de que exista una sola línea de código. País y región no se definen de nuevo, sino que se toman de la ontología de negocio. Con un clic, el producto de datos se crea a partir del Data Contract.
Un coding agent se encarga de la implementación. Recibe tres cosas: el Data Contract como descripción de lo que hay que construir; skills que conocen las convenciones de la plataforma; y el marketplace con los datos sobre los que puede construir. La instrucción es una sola frase: «Implementa el producto de datos». El agente analiza el objetivo, busca en el marketplace los productos de datos existentes que necesita, obtiene acceso a sus datos, crea el proyecto dbt, construye la tabla en Trino junto con su pipeline de datos, prueba la tabla ya cargada contra el Data Contract con el Data Contract CLI open source y lo publica todo en el marketplace, incluido el data lineage. A los pocos minutos, el nuevo producto de datos está activo. Este es el Data Product Builder en acción.
Libertad de elección en cada capa
La demo muestra una combinación posible, no una fija. En la capa de plataforma, Stackable se puede ampliar: Stackable incluye operadores para más componentes como Spark, Druid o HBase, y como todo se ejecuta sobre Kubernetes, también tienen cabida tus propios servicios y los sistemas existentes.
Lo mismo vale para la capa de gobernanza. Entropy Data se basa en ODCS, ODPS, Apache Ossie y OpenLineage, así que puedes conectar otras herramientas, como un catálogo de datos existente, tus propios controles de calidad o reglas adicionales en OPA. Los Data Contracts y los productos de datos viven como estándares abiertos en tu propio repositorio Git. La decisión sobre qué herramientas usar sigue siendo tuya.
Por qué encaja
Aquí los estándares abiertos son más que un principio. Le dan al agente un marco claro: el Data Contract es legible por máquinas, los tests son deterministas y el resultado se puede verificar. Así una instrucción se convierte en un resultado fiable.
El papel de las personas cambia: deja de ser programar y pasa a ser decidir qué se debe construir y qué valor aporta. La plataforma se asegura de que cada nuevo producto de datos se apoye en estándares abiertos y encaje sin fricciones en el panorama de datos existente. Para saber más sobre esta forma de trabajar, mira la charla Building a Data Product Contract-first (with AI) (en inglés).
Si quieres profundizar: toda la demo está disponible de forma abierta en GitHub, incluida la configuración de la plataforma, los productos de datos y los skills: github.com/entropy-data/entropydata-stackable-showcase.
Hablemos
¿Quieres construir una plataforma de datos abierta o desarrollar productos de datos contract-first? Ponte en contacto con nosotros:
- Stackable Data Platform: Sönke Liebau, CPO & Co-Founder de Stackable, en LinkedIn.
- Entropy Data: Dr. Simon Harrer, CEO & Co-Founder de Entropy Data, en LinkedIn.
Sobre el autor
Dr. Simon Harrer
LinkedIn de Simon HarrerCo-Founder & CEO, Entropy Data
Simon construye herramientas para que los datos, las personas y la IA trabajen juntos. Es doctor en sistemas distribuidos, pasó siete años en INNOQ como arquitecto de software y consultor, y cofundó Entropy Data, donde es CEO.