Article
Construire des produits de données sur une plateforme ouverte : Stackable + Entropy Data
Dr. Simon Harrer
Co-Founder & CEO, Entropy Data ·
De nombreuses entreprises veulent une plateforme de données moderne sans se lier à un seul fournisseur. Les offres cloud propriétaires se mettent en place rapidement, mais les données, la logique et le savoir finissent dans un système fermé. Notre démo montre une autre voie : une plateforme ouverte, faite d'open source et de standards ouverts, auto-hébergée et entièrement sous votre contrôle.
La plateforme : Stackable
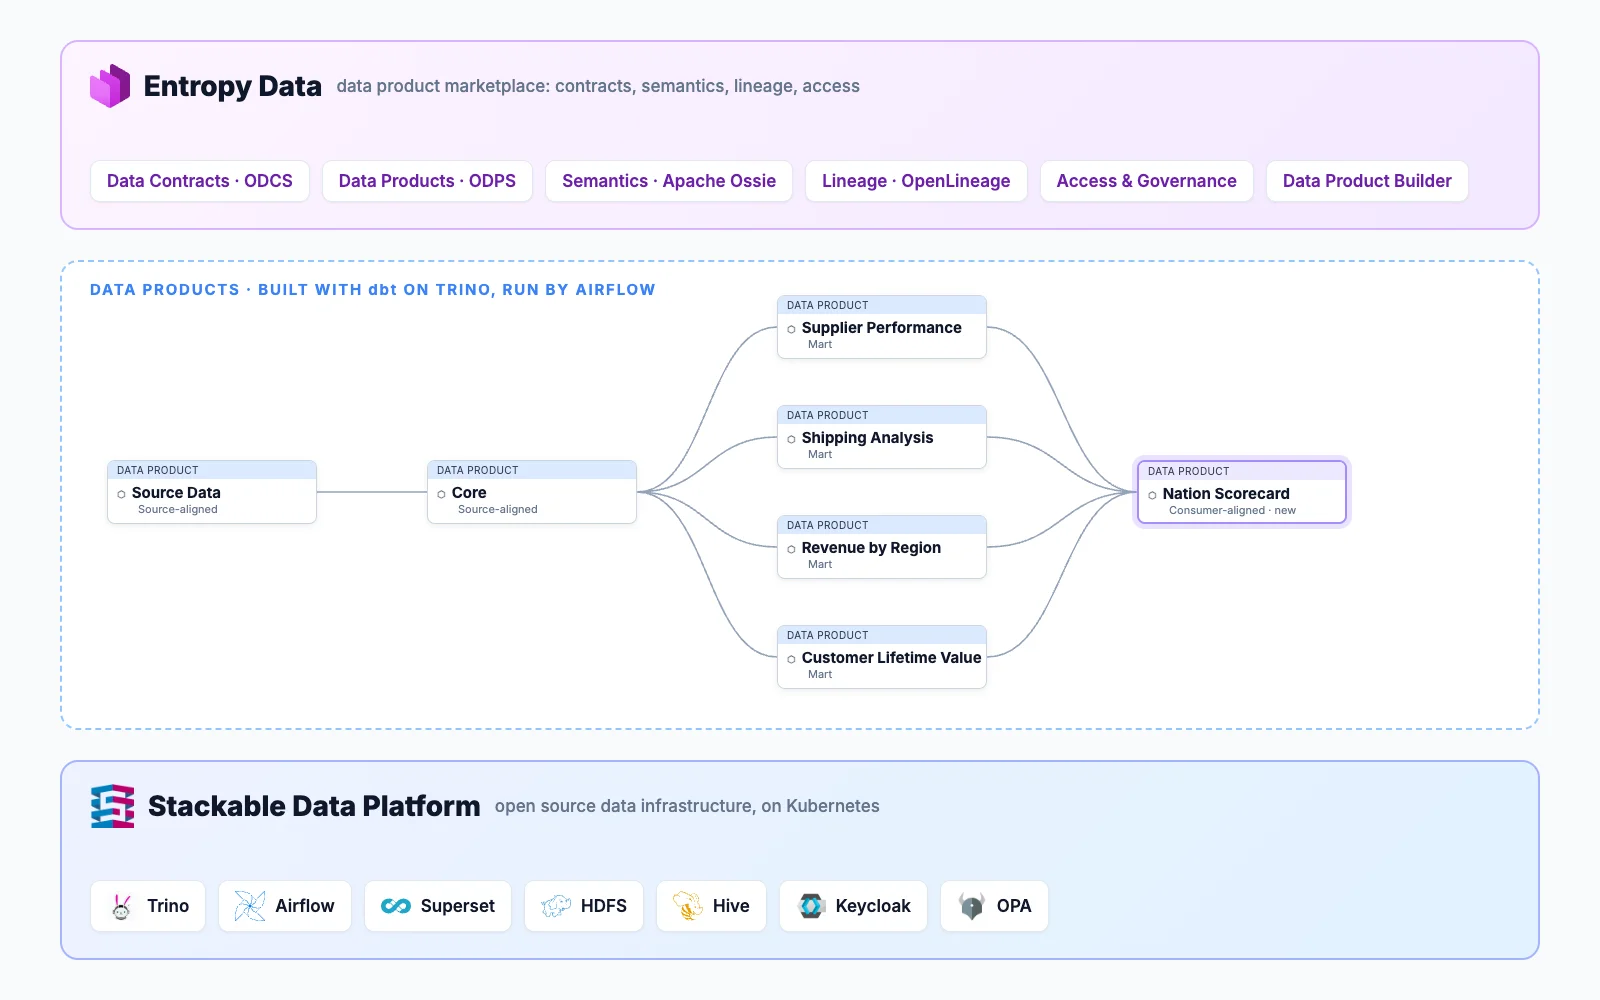
La Stackable Data Platform constitue le socle. Elle fournit des composants open source éprouvés comme Trino, Airflow, Superset et OPA sur Kubernetes, que ce soit dans votre propre centre de données ou dans le cloud. Les composants sont accordés les uns aux autres, configurés de manière sécurisée et déployés via GitOps. Stackable assure la sécurité et le support, sans créer de dépendance envers un fournisseur.
La marketplace : Entropy Data
Sur la plateforme naissent des produits de données qui s'appuient les uns sur les autres. Entropy Data les rend trouvables et utilisables sous la forme d'une marketplace de données. Chaque produit de données possède un Data Contract qui décrit les données qu'il fournit, ce qu'elles signifient et avec quelle qualité. Une ontologie métier commune relie des termes comme client, pays ou marque à travers tous les produits de données. Le lineage montre comment les données circulent, et l'accès est demandé et approuvé via la marketplace. À chaque requête, Trino vérifie que l'accès est autorisé.
Tout repose sur des standards ouverts : l'Open Data Contract Standard (ODCS) pour les Data Contracts, l'Open Data Product Standard (ODPS) pour les produits de données, Apache Ossie pour l'ontologie et OpenLineage pour le lineage.
Contract-first, avec un agent de codage
Dans la vidéo, nous construisons une « Nation Scorecard » : une vue d'ensemble de l'évolution de chaque pays en tant que marché, avec le chiffre d'affaires, la valeur client, la qualité de livraison et les fournisseurs locaux.
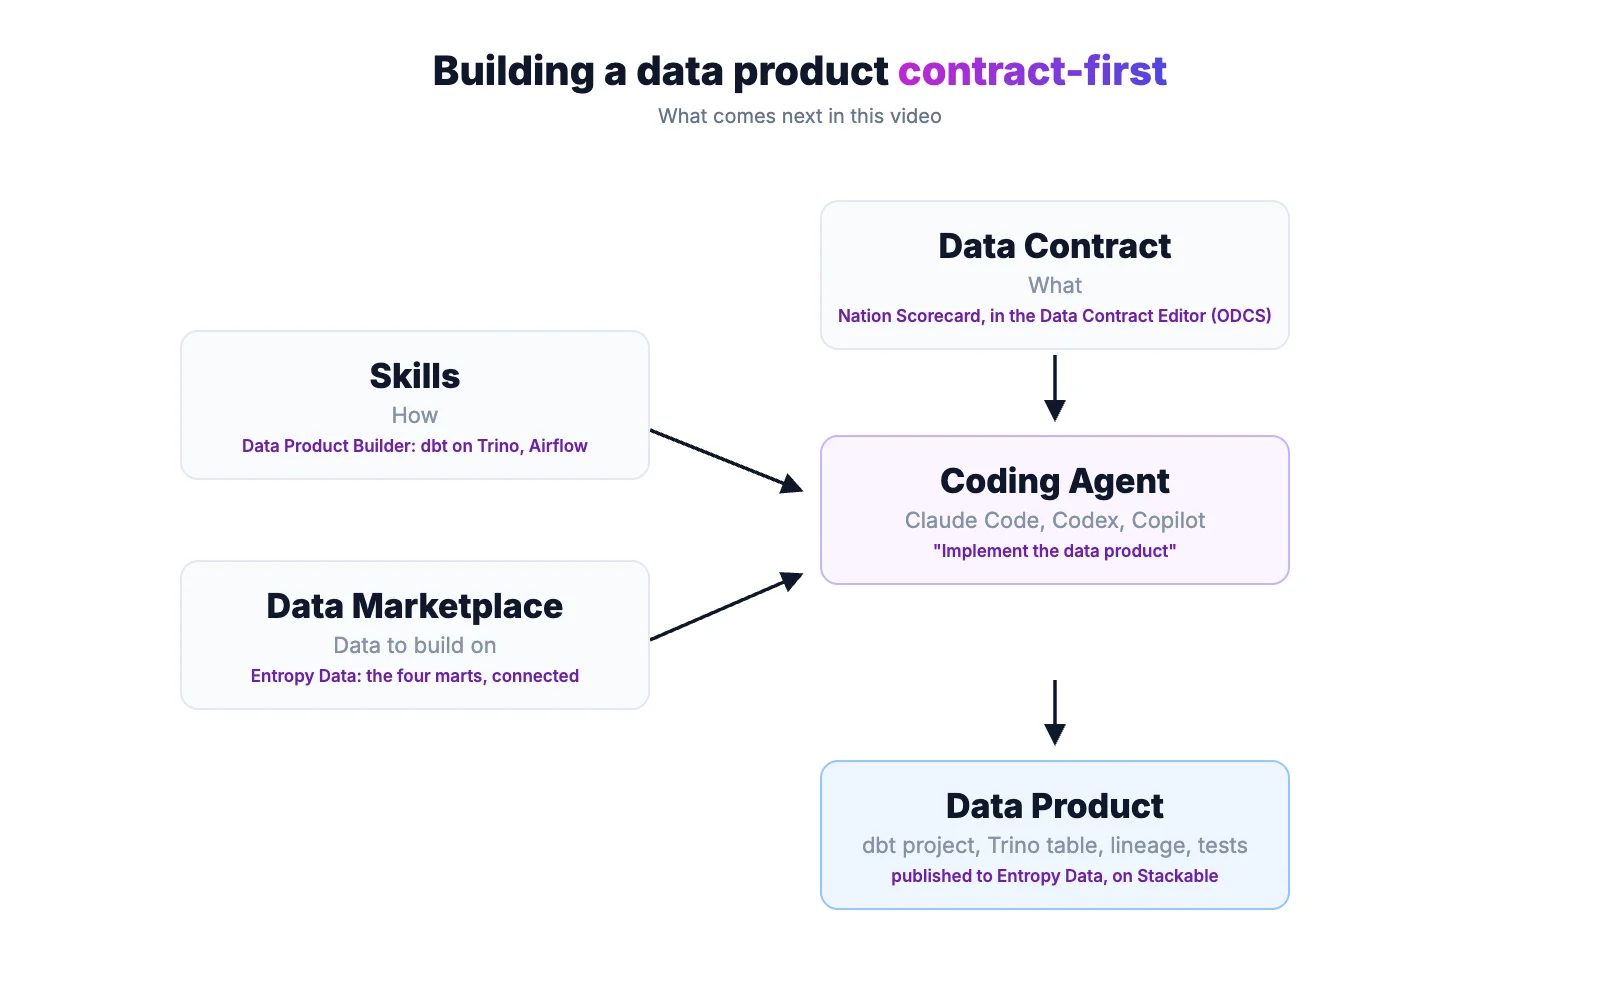
Le Data Contract vient en premier. Il décrit ce qui doit être construit avant même qu'une ligne de code n'existe. Le pays et la région ne sont pas redéfinis, mais repris de l'ontologie métier. En un clic, le produit de données est créé à partir du Data Contract.
Un agent de codage se charge de l'implémentation. Il reçoit trois choses : le Data Contract, qui décrit ce qu'il faut construire ; des skills qui connaissent les conventions de la plateforme ; et la marketplace, avec les données sur lesquelles il peut s'appuyer. La consigne tient en une phrase : « Implémente le produit de données. » L'agent analyse la cible, cherche dans la marketplace les produits de données existants dont il a besoin, obtient l'accès à leurs données, crée le projet dbt, construit la table dans Trino avec le pipeline de données, teste la table remplie par rapport au Data Contract avec le Data Contract CLI open source, puis publie le tout dans la marketplace, lineage compris. Au bout de quelques minutes, le nouveau produit de données est actif. C'est le Data Product Builder à l'œuvre.
Libre choix à chaque niveau
La démo montre une combinaison possible, pas une combinaison figée. Au niveau de la plateforme, Stackable peut être étendue : Stackable fournit des opérateurs pour d'autres composants comme Spark, Druid ou HBase, et comme tout tourne sur Kubernetes, vos propres services et vos systèmes existants y trouvent aussi leur place.
Il en va de même au niveau de la gouvernance. Entropy Data s'appuie sur ODCS, ODPS, Apache Ossie et OpenLineage, si bien que d'autres outils peuvent s'y connecter, par exemple un catalogue de données existant, vos propres contrôles qualité ou des règles supplémentaires dans OPA. Les Data Contracts et les produits de données résident sous forme de standards ouverts dans votre propre dépôt Git. Le choix des outils vous appartient.
Pourquoi cela va ensemble
Les standards ouverts sont ici plus qu'un principe. Ils donnent à l'agent un cadre clair : le Data Contract est lisible par une machine, les tests sont déterministes et le résultat est vérifiable. C'est ainsi qu'une consigne devient un résultat fiable.
Le rôle des personnes évolue : moins de programmation, davantage la question de ce qui doit être construit et de la valeur que cela crée. La plateforme garantit que chaque nouveau produit de données repose sur des standards ouverts et s'intègre sans heurt dans le paysage de données existant. Pour en savoir plus sur cette façon de travailler, voir la présentation Building a Data Product Contract-first (with AI) (en anglais).
Pour aller plus loin : toute la démo est disponible en open source sur GitHub, y compris la configuration de la plateforme, les produits de données et les skills : github.com/entropy-data/entropydata-stackable-showcase.
Parlons-en
Vous souhaitez bâtir une plateforme de données ouverte ou développer des produits de données contract-first ? Contactez-nous :
- Stackable Data Platform : Sönke Liebau, CPO & Co-Founder de Stackable, sur LinkedIn.
- Entropy Data : Dr. Simon Harrer, CEO & Co-Founder d'Entropy Data, sur LinkedIn.
À propos de l'auteur
Dr. Simon Harrer
LinkedIn de Simon HarrerCo-Founder & CEO, Entropy Data
Simon construit des outils pour faire travailler ensemble les données, les gens et l'IA. Docteur en systèmes distribués, il a passé sept ans chez INNOQ comme architecte logiciel et consultant avant de cofonder Entropy Data, qu'il dirige en tant que CEO.