Conférence
Open Standards for Data Mesh
Dr. Simon Harrer, Co-Founder & CEO @ Entropy Data ·
Dans cette conférence donnée au Data Mesh Belgium Meetup #7 de Louvain, je passe en revue les trois standards ouverts qui façonnent aujourd’hui la construction d’un Data Mesh : l’Open Data Contract Standard (ODCS), l’Open Data Product Standard (ODPS) et l’Open Semantic Interchange (OSI). Je montre comment ils s’articulent, où va l’outillage, et pourquoi l’un d’eux sera partout d’ici quatre ans.
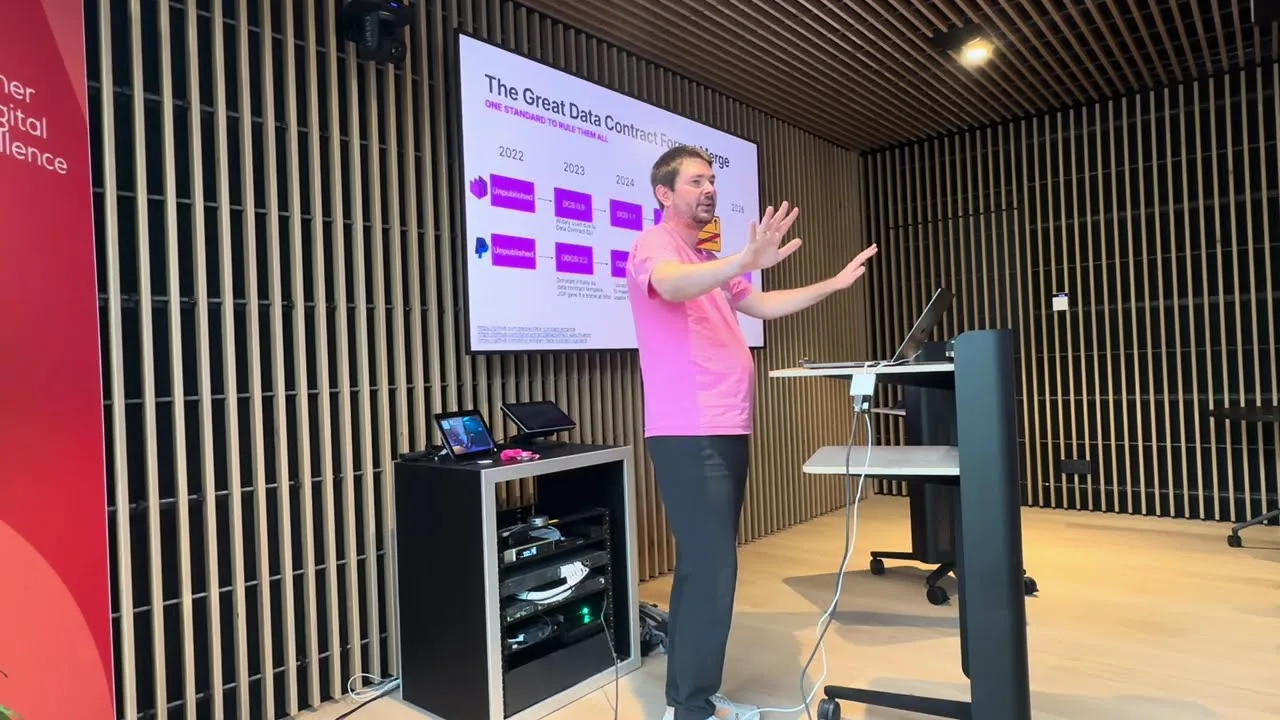
Enregistré en direct au Data Mesh Belgium Meetup #7 de Louvain. La transcription ci-dessous est une version éditée de la conférence.
Merci à Tom De Wolf (ACA) et Emma Houben (AE) pour l’invitation et l’accueil du meetup, ainsi qu’à la communauté BITOL pour les standards ouverts que nous construisons ensemble.
TL;DR
Les cinq points clés et enseignements de la conférence.
-
Les bons standards sont ouverts et partagés. Les standards qui valent la peine sont adoptés de facto, portés par une initiative ouverte, façonnés par de nombreux contributeurs et libres d’utilisation. Si un seul éditeur les dicte, ce ne sont pas des standards.
-
Le Data Contract est la couche de confiance. Un Data Contract définit la propriété, la structure, la sémantique, la qualité et les conditions d’utilisation des données échangées entre un Data Producer et ses Data Consumers, comme une API pour les données. Quand les données et le contrat divergent, ce sont les données qui ont tort.
-
L’outillage compte plus que le standard. Un contrat ne prend de la valeur que si vous automatisez par-dessus : tests, détection des breaking changes, génération de code et diffusion des métadonnées vers les catalogues de données. Sur GitHub, la Data Contract CLI est plus populaire que la spécification ODCS elle-même.
-
ODPS transforme les contrats en graphe du mesh. Chaque produit de données déclare des Input Ports et des Output Ports qui référencent des Data Contracts ODCS : le graphe de dépendances de votre Data Mesh se déduit des fichiers YAML au lieu d’être dessiné à la main. Attention à l’homonymie : l’Open Data Product Standard de BITOL n’est pas l’Open Data Product Specification.
-
ODCS sera partout dans quatre ans. Swagger 1.0 est sorti en 2011 et OpenAPI est aujourd’hui partout. ODCS 3.0 est sorti en 2025 et, comme le monde va plus vite, la prédiction est qu’il se diffusera bien plus rapidement : mieux vaut s’y préparer.
Introduction
Merci pour l’invitation, Tom. C’est ma première fois à Louvain, et jusqu’ici c’est formidable. Je m’appelle Simon et je suis développeur dans l’âme. J’ai passé sept ans en cabinet de conseil et, depuis août 2025, je suis Co-Founder et CEO d’Entropy Data, où nous construisons une marketplace de produits de données. Nous avons des clients dans sept pays, dont les États-Unis, l’Australie et la Belgique.
À côté de cela, j’ai co-écrit « Java by Comparison » à l’époque où je faisais du Java (aujourd’hui, c’est Claude qui code pour moi), et j’ai co-traduit en allemand le livre « Data Mesh » ; le plus cool, c’est que dans l’édition allemande les illustrations sont imprimées en couleur. Je co-écris datamesh-architecture.com et datacontract.com, je co-maintiens les projets open source Data Contract CLI et Data Contract Editor, et je siège au TSC du projet BITOL de la Linux Foundation, qui porte les standards ouverts pour les Data Contracts et les produits de données. D’ailleurs, nous avons tenu notre réunion du TSC aujourd’hui même dans les bureaux de Tom : une belle manière de commencer la soirée en présentiel.
Petit rappel sur le Data Mesh
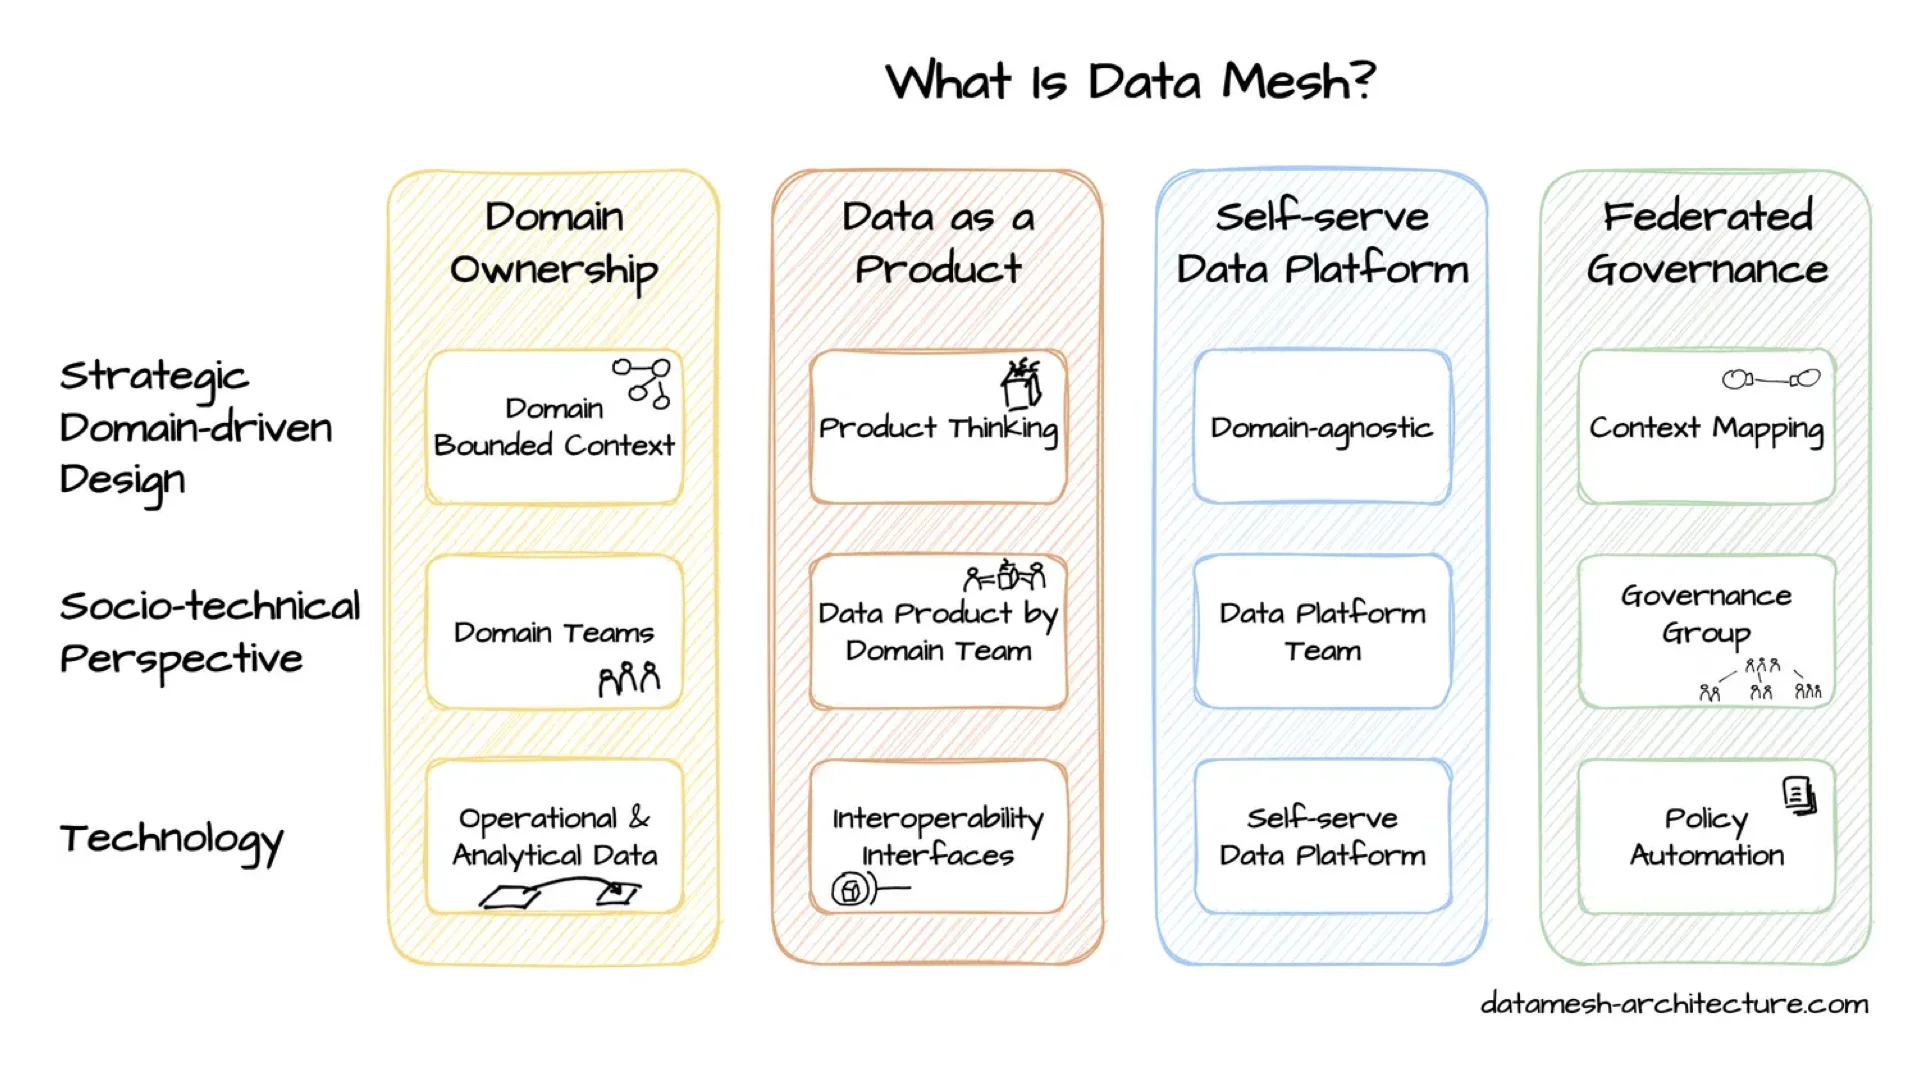
On est à un meetup Data Mesh, donc vous connaissez sans doute déjà tout cela : un rappel très rapide, histoire de partir du même point. Le Data Mesh, concept forgé par Zhamak Dehghani, repose sur quatre principes : la propriété par domaine, la donnée comme produit, la plateforme de données en self-service et la gouvernance fédérée.
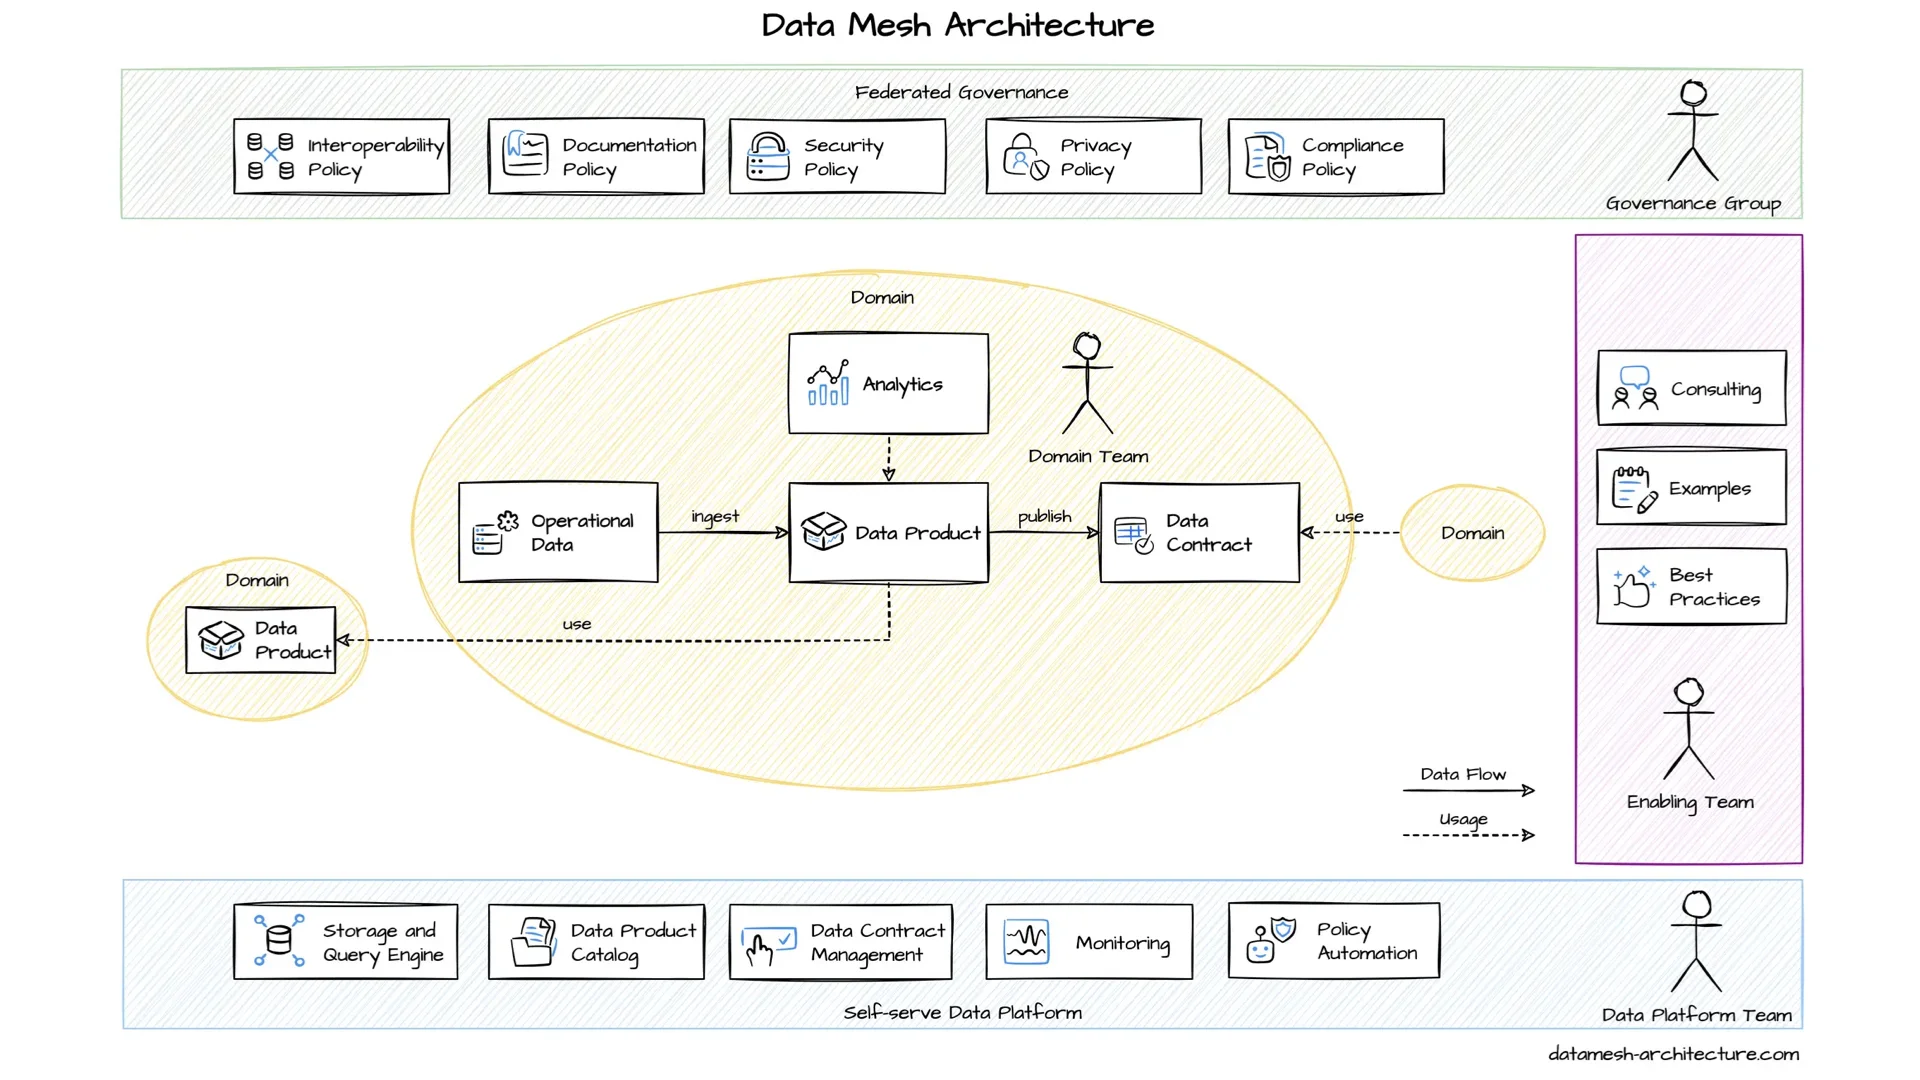
L’architecture typique place la plateforme self-service en bas, la gouvernance fédérée en haut, et sur le côté une enabling team qui aide les autres. Au centre, on trouve les domaines et leurs équipes, qui construisent des produits de données utilisables par les autres.
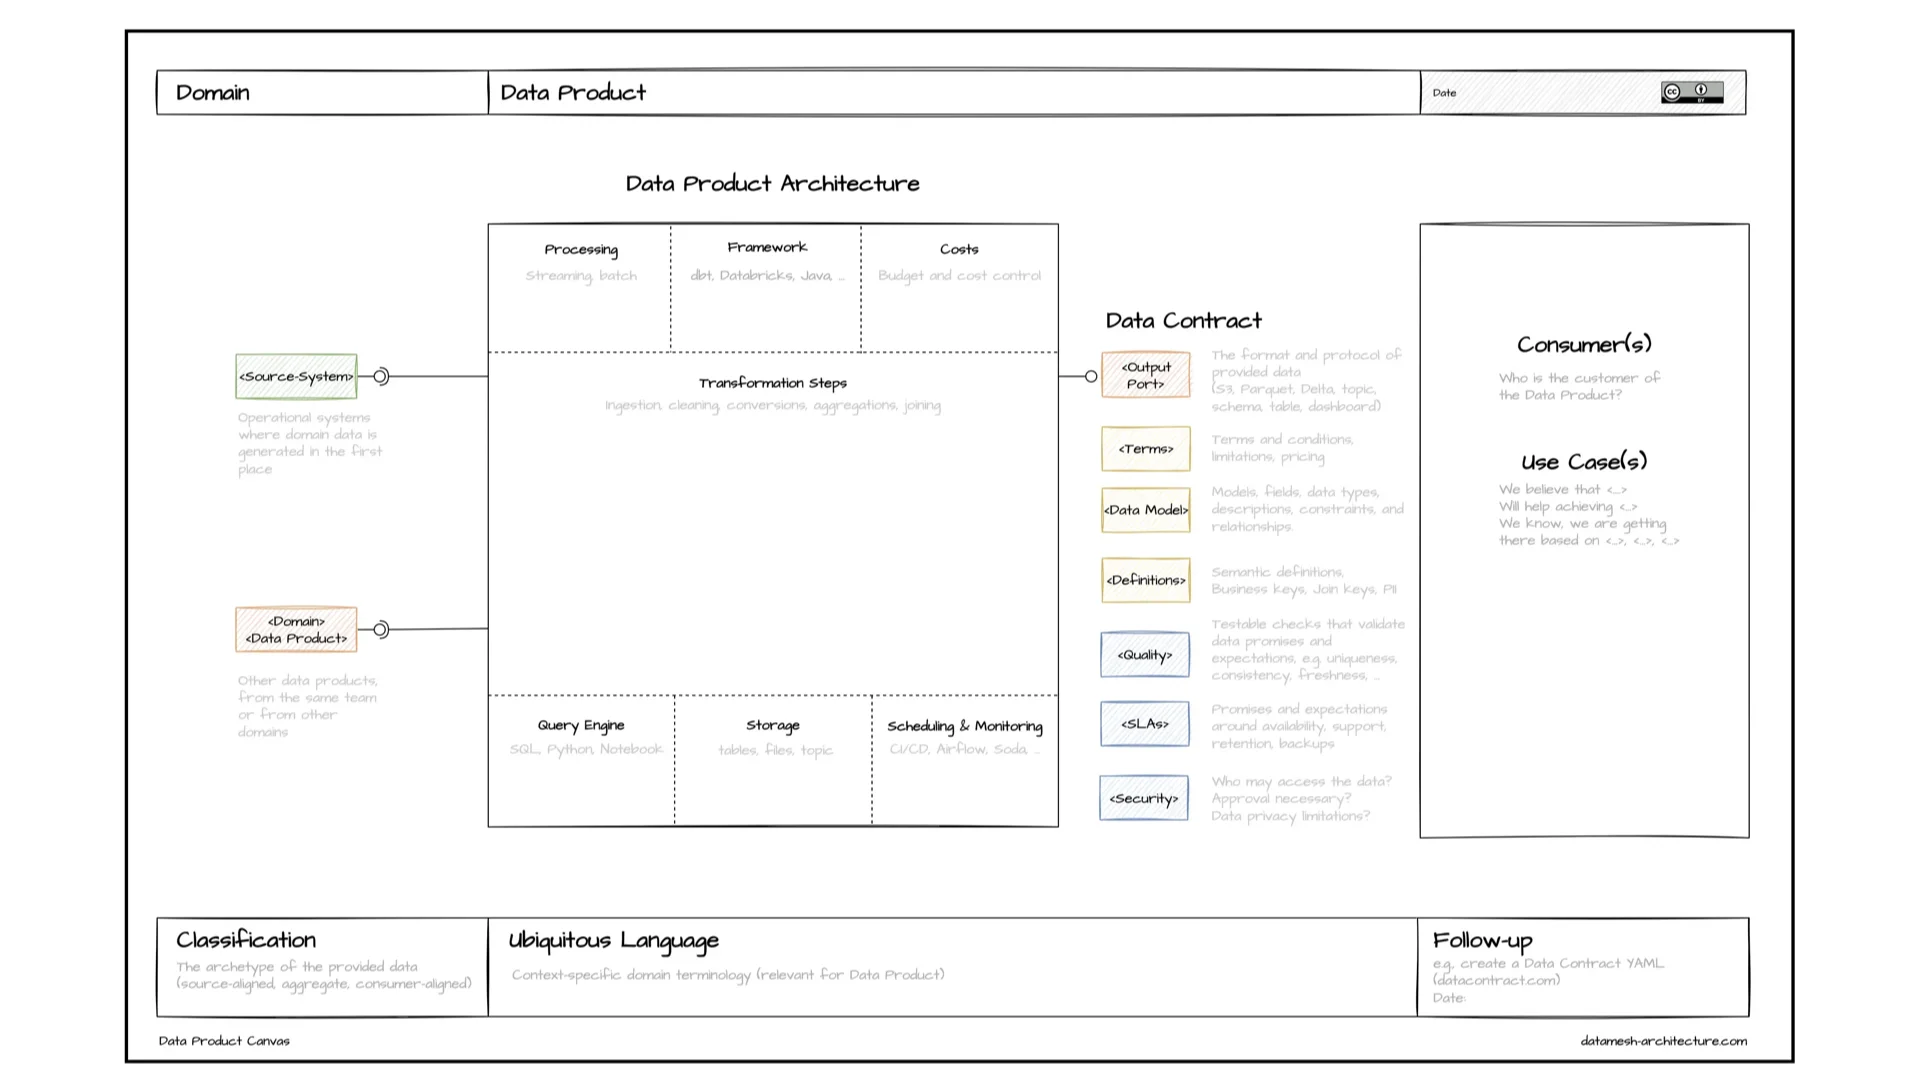
Quand une équipe construit un produit de données, nous utilisons souvent le Data Product Canvas, un modèle Miro open source créé à l’époque du conseil. Les Input Ports viennent des systèmes sources ou d’autres produits de données. Les Output Ports proposent des données via un Data Contract à des consommateurs porteurs de cas d’usage. Au milieu se trouve l’implémentation : traitement, framework, moteur de requête, stockage, ordonnancement, coûts. Mis bout à bout, tout cela forme le graphe du mesh.
Qu’est-ce qu’un standard, et pourquoi en avons-nous besoin ?
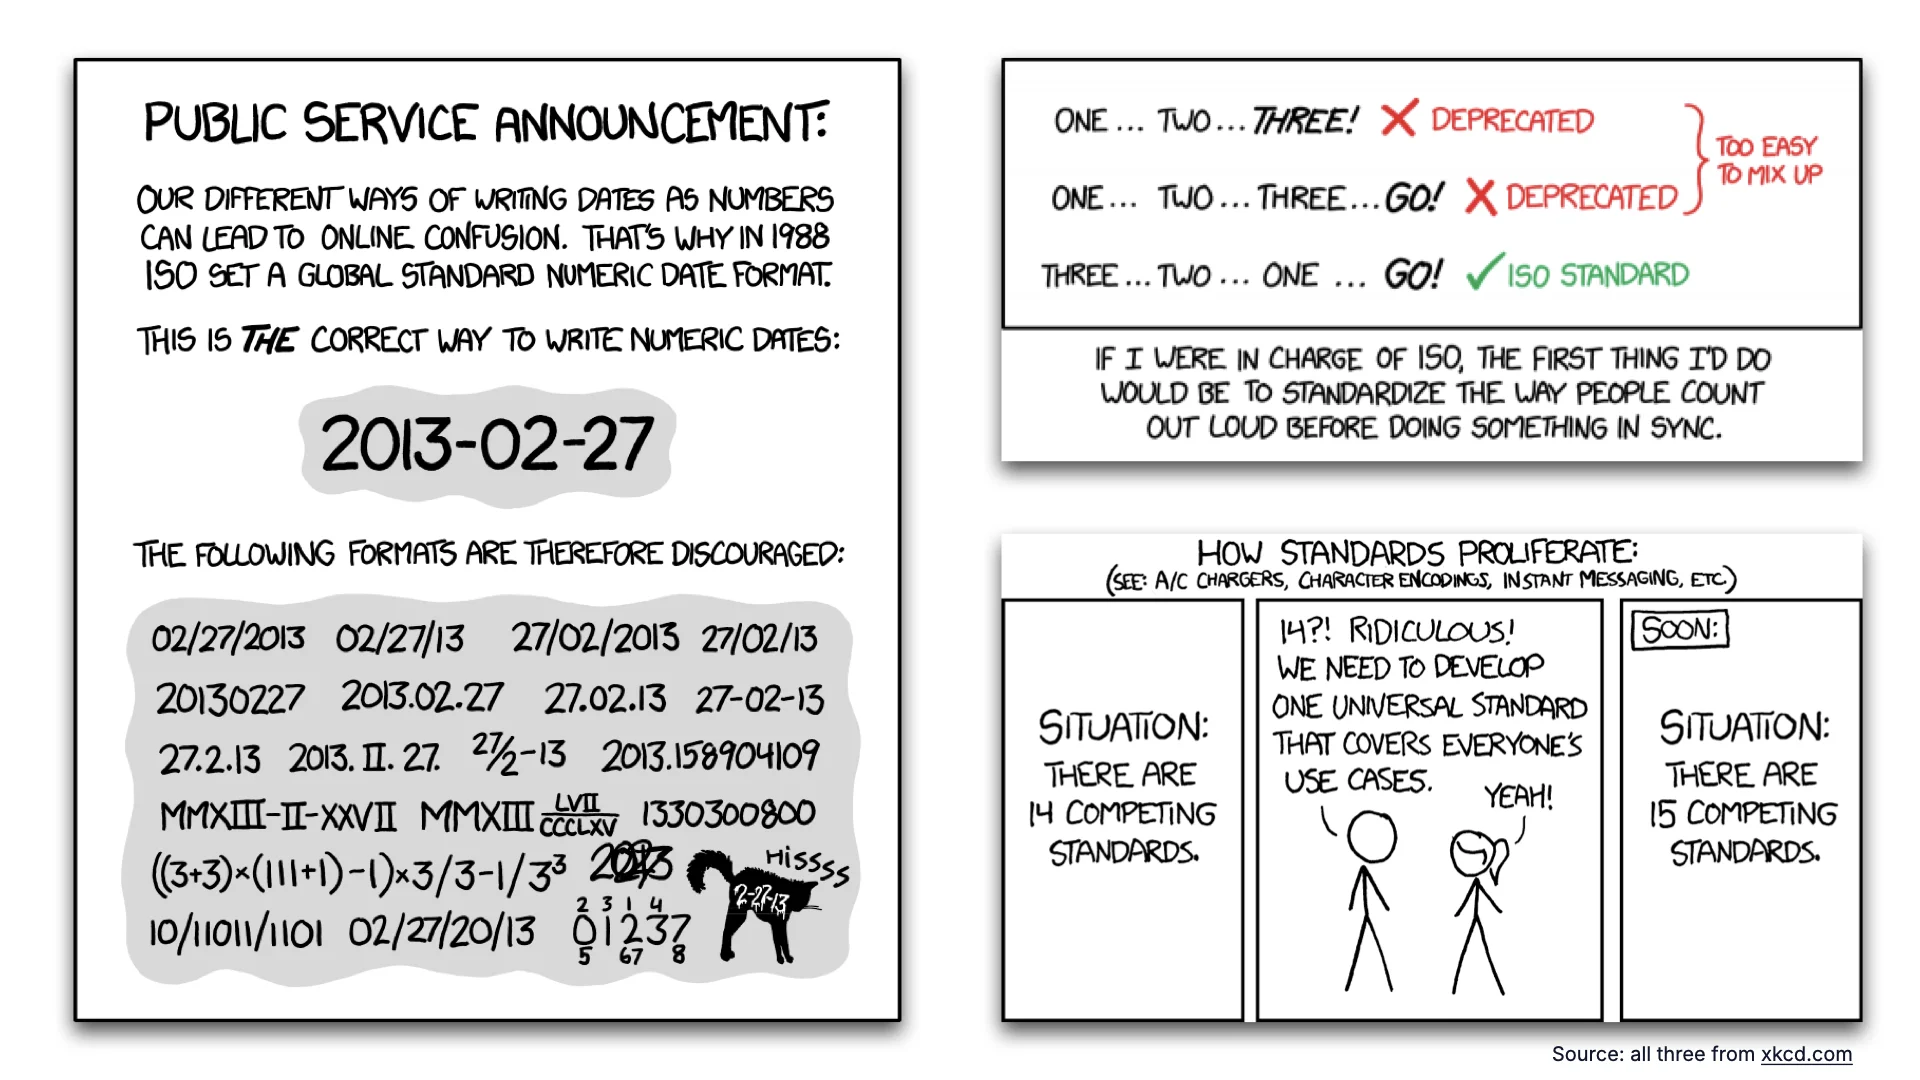
Plutôt que le dictionnaire, je préfère regarder XKCD. Les différentes façons d’écrire une date ont donné la norme ISO 8601 : tout le monde y gagne quand tout le monde l’utilise (sauf les États-Unis, comme le note XKCD). Les différentes façons de compter, « un, deux, trois, partez » contre « trois, deux, un, partez », créent la même confusion et le même coût. C’est pour cela que les standards font baisser les coûts. Et puis il y a le classique XKCD « How Standards Proliferate » : vous avez quatorze standards, vous en créez un nouveau, universel, pour tout couvrir, et vous en avez maintenant quinze. C’est le problème des standards, résumé.
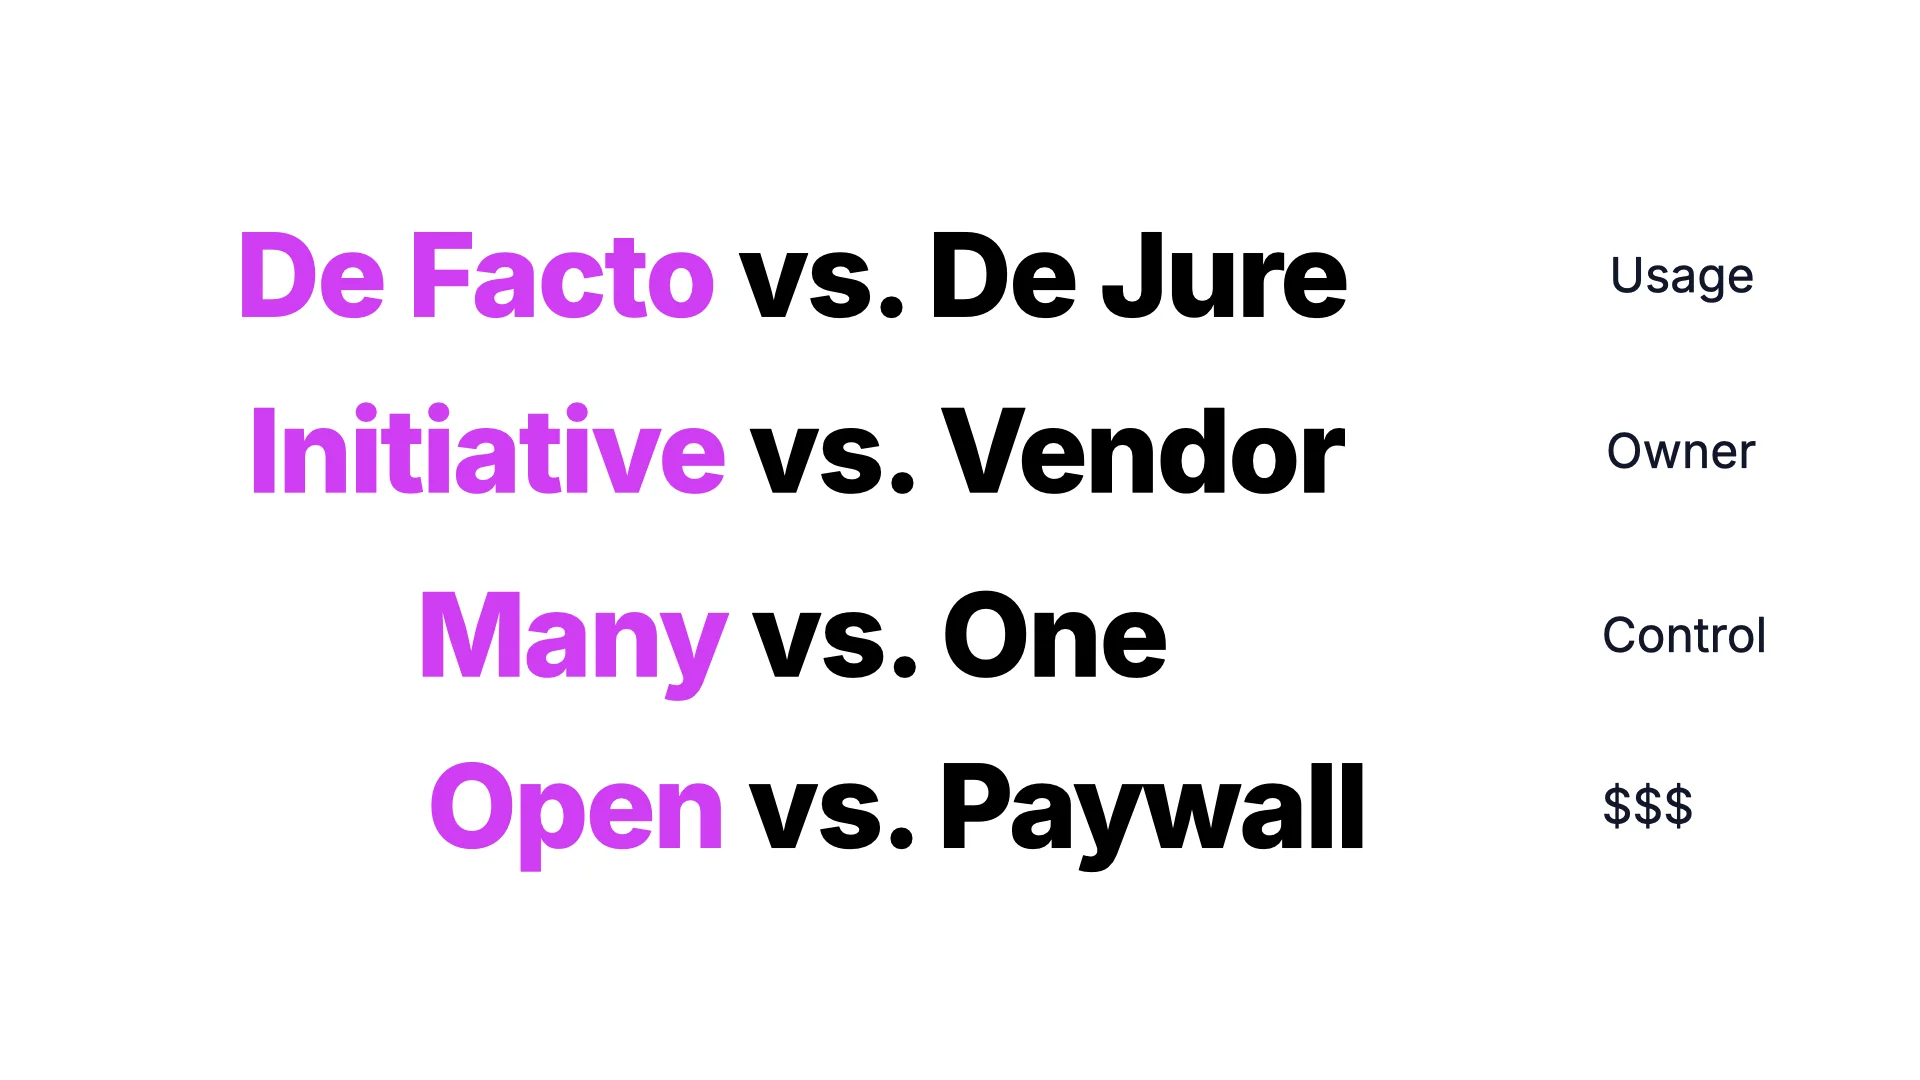
Précisons de quoi je parle aujourd’hui. Les standards qui m’intéressent sont :
- De facto, pas de jure : portés par un usage réel dans une masse critique d’entreprises, pas par la loi.
- Une initiative, pas un éditeur : portés par une initiative ouverte, pas contrôlés par une seule entreprise. Si un éditeur dicte les règles, ce n’est pas un standard.
- Beaucoup de contributeurs, pas un seul : il s’agit de répartir le pouvoir et le contrôle.
- Ouverts, pas derrière un paywall : librement utilisables. (Nous sommes certifiés ISO 27001, et payer 130 francs suisses pour un PDF de 10 pages, c’est exactement le genre de friction qu’évitent les standards ouverts.)
La standardisation pourrait intervenir presque partout dans un Data Mesh : supervision, catalogues, requêtes, stockage, politiques, analytique, relations. Je vais me concentrer sur les trois qui comptent le plus en ce moment.
Qu’est-ce qu’un Data Contract ?
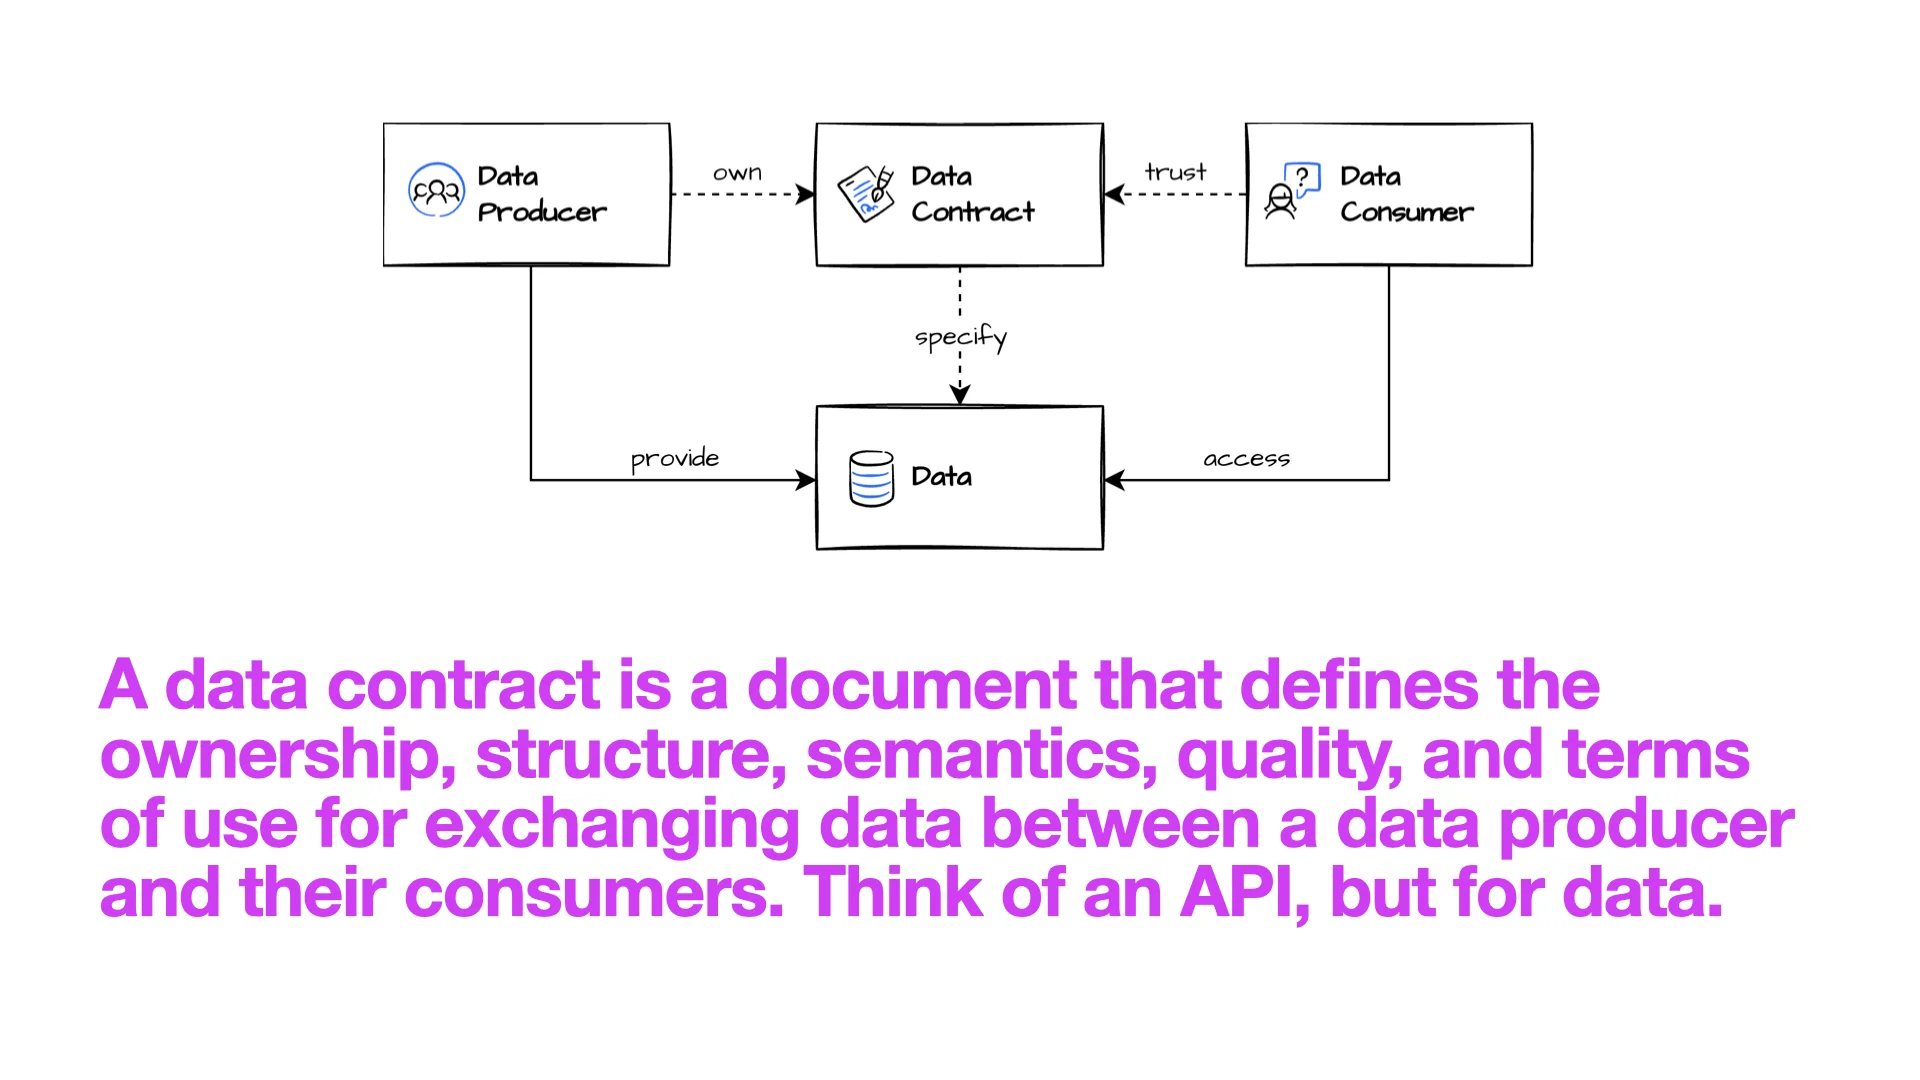
Un Data Contract est un document qui définit la propriété, la structure, la sémantique, la qualité et les conditions d’utilisation pour l’échange de données entre un producteur et ses consommateurs. Pensez à une API, mais pour les données.
C’est le contrat qui crée la confiance. Le Data Producer en est propriétaire, le Data Consumer le lit et s’y fie ; ensemble, ils s’accordent sur les données qui circuleront entre eux.
« Le contrat est par définition correct. Quand les données et le contrat divergent, ce sont les données qui ont tort. Voilà la force de cette couche de confiance, conceptuellement. »
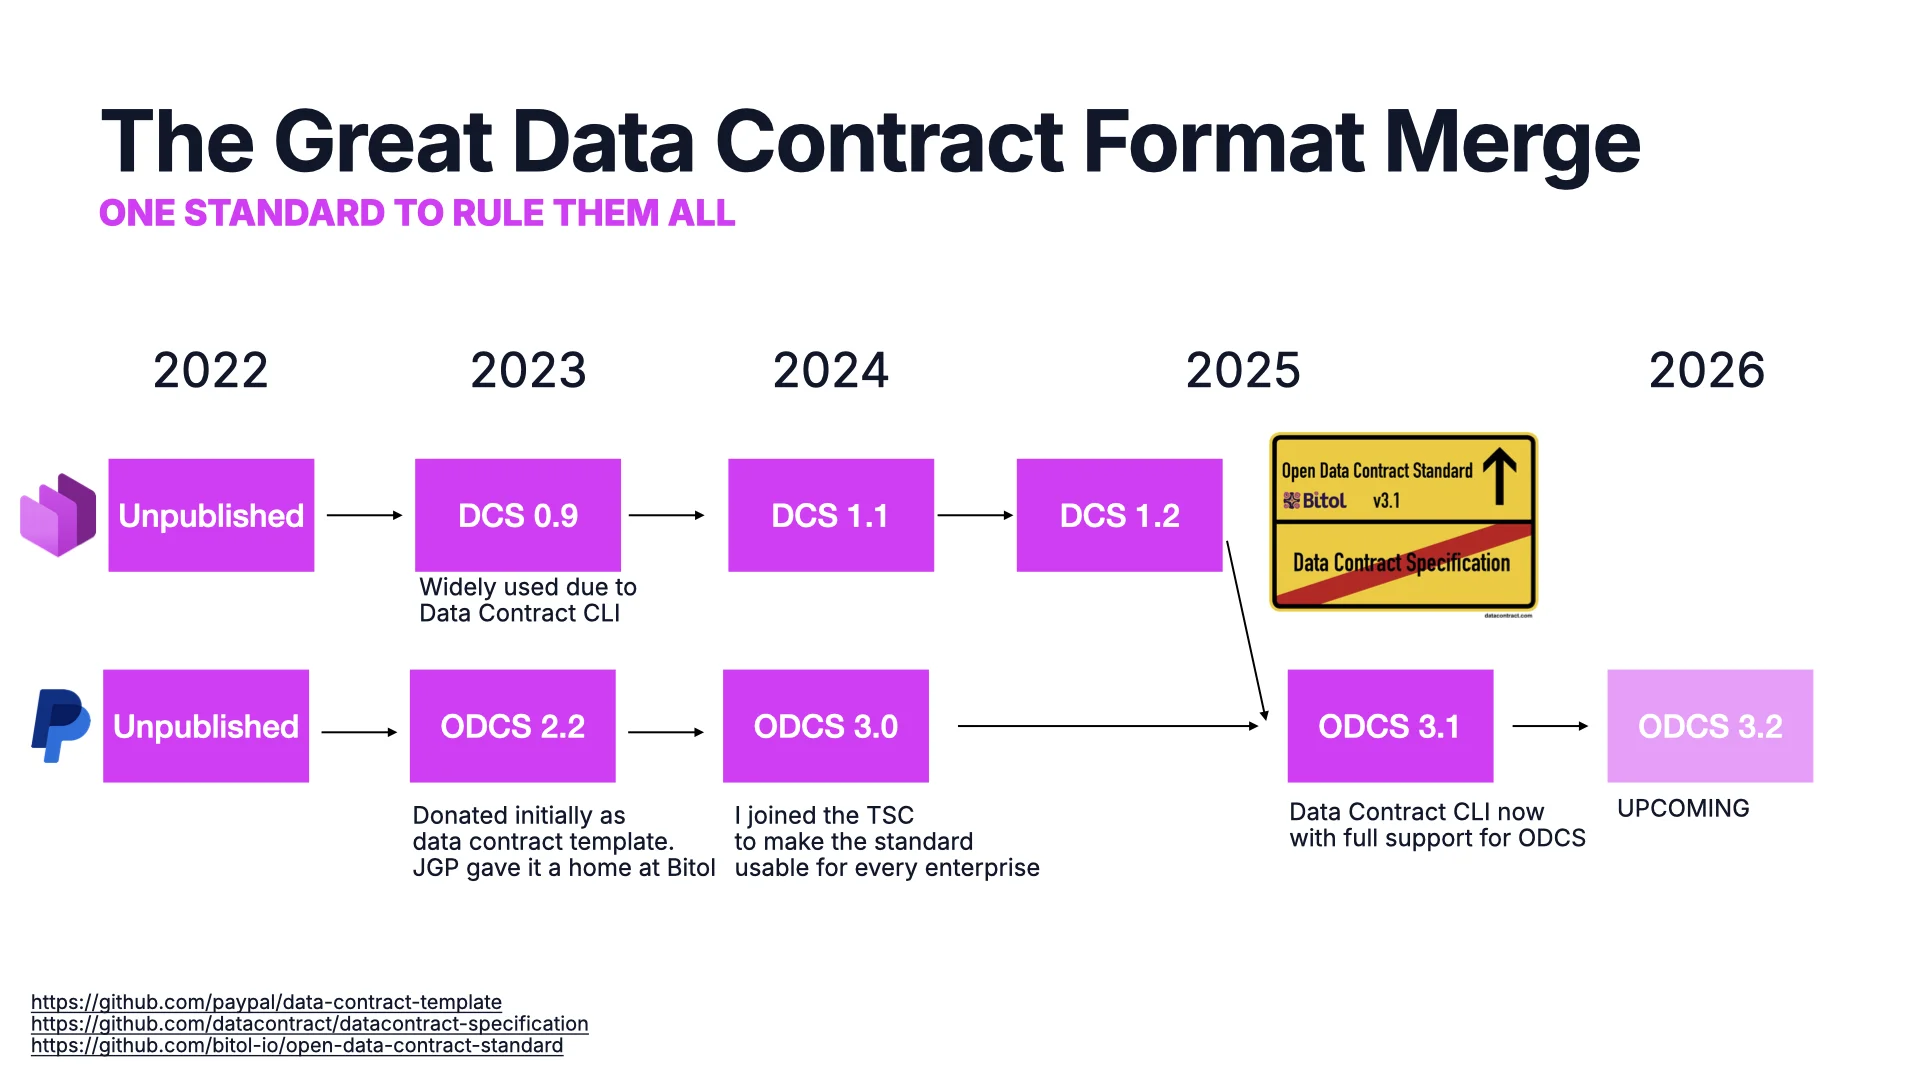
La grande fusion des formats de Data Contract
Comme ce besoin est apparu avec l’essor du Data Mesh et de la donnée décentralisée, chaque entreprise a d’abord inventé son propre format. PayPal a créé son modèle interne, l’a publié en open source, puis en a fait don à la Linux Foundation sous le nom d’ODCS 2.2. En parallèle, nous avions construit à peu près au même moment notre propre Data Contract Specification (DCS), qui a été largement adoptée grâce à l’outillage autour d’elle, la Data Contract CLI.
J’aime ce qui est ouvert, alors j’ai rejoint le TSC et nous avons publié ODCS 3.0, en retirant les spécificités PayPal pour le rendre utilisable par n’importe quelle entreprise : des PayPal, il n’y en a qu’un. L’an dernier, nous avons déprécié notre propre Data Contract Specification au profit d’ODCS et y avons basculé toutes nos ressources. La question du contrôle est centrale : n’être qu’un membre parmi d’autres dans un comité où utilisateurs finaux, consultants et éditeurs sont à parité, c’est un équilibre bien plus sain qu’un projet porté par un seul éditeur, aussi ouvert soit-il. ODCS 3.2 arrive ; nous venons d’approuver quelques ajouts lors de la réunion du TSC d’aujourd’hui.
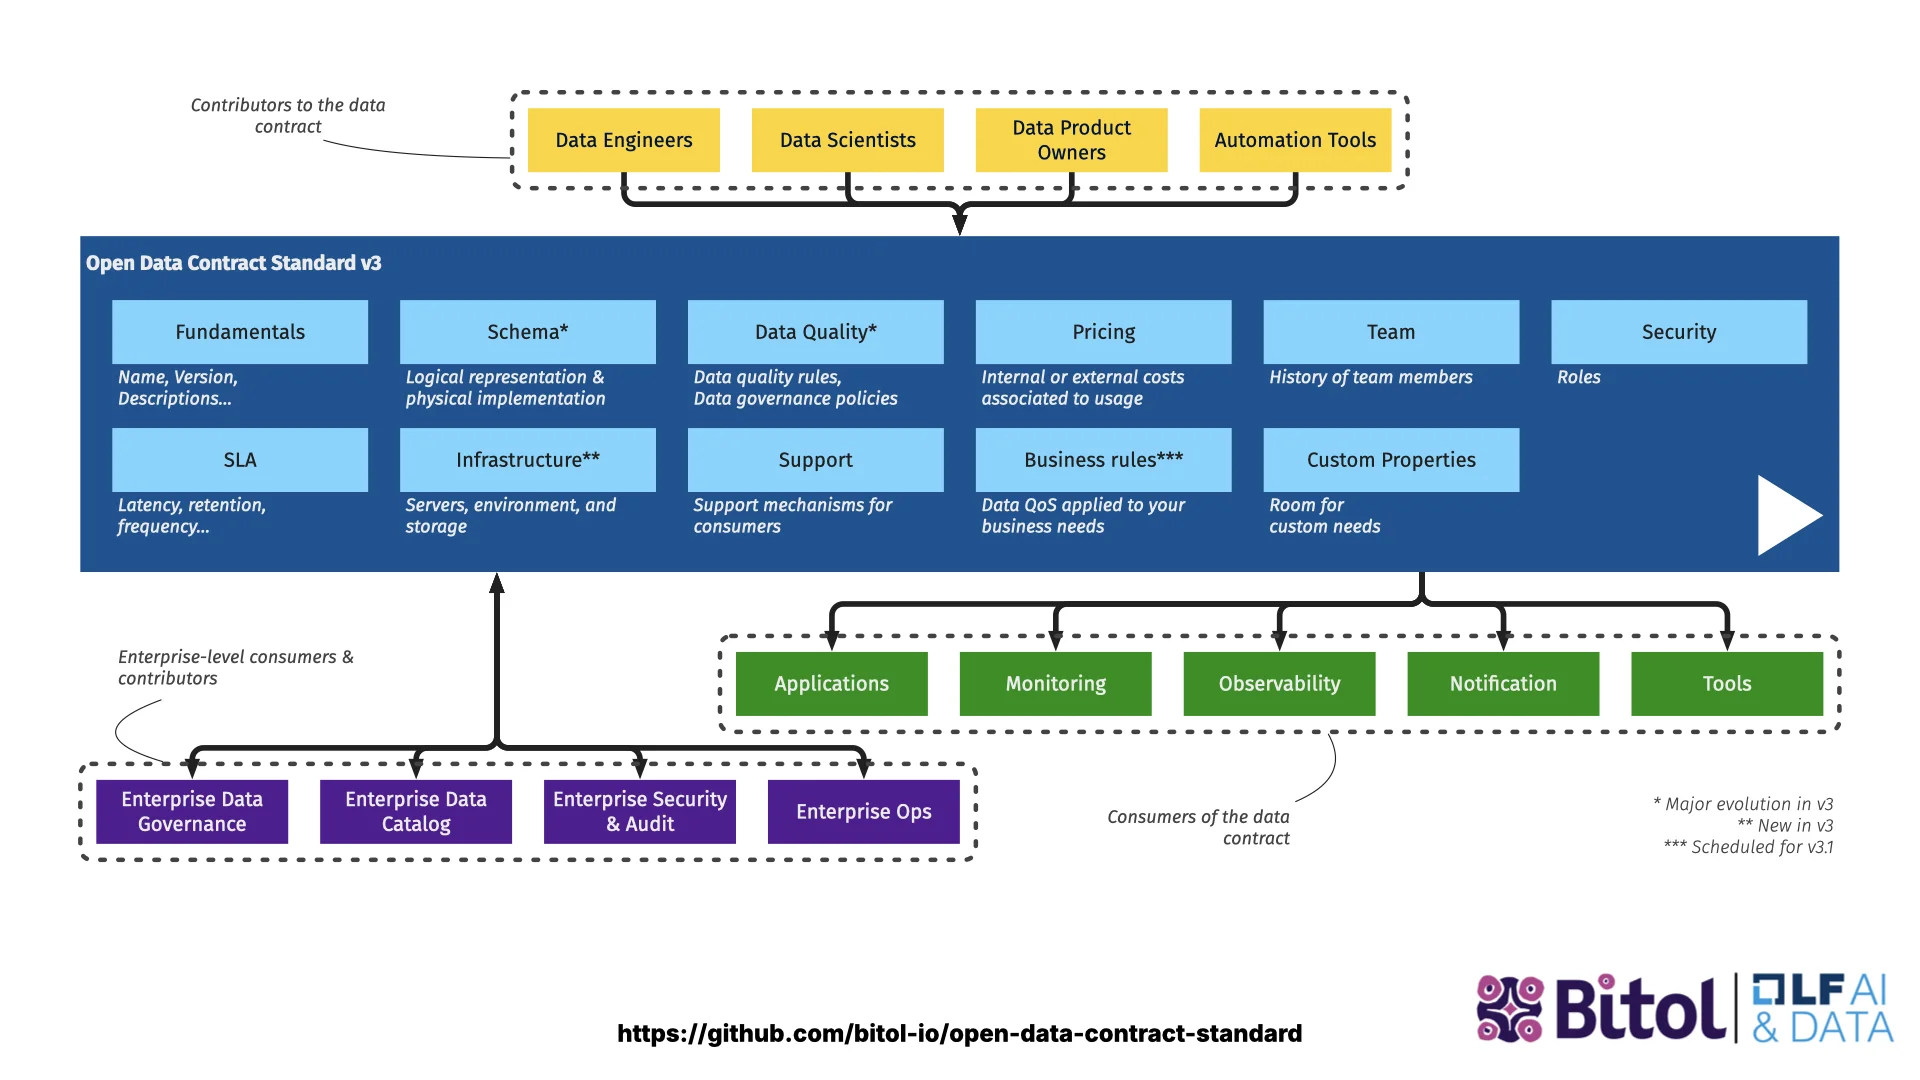
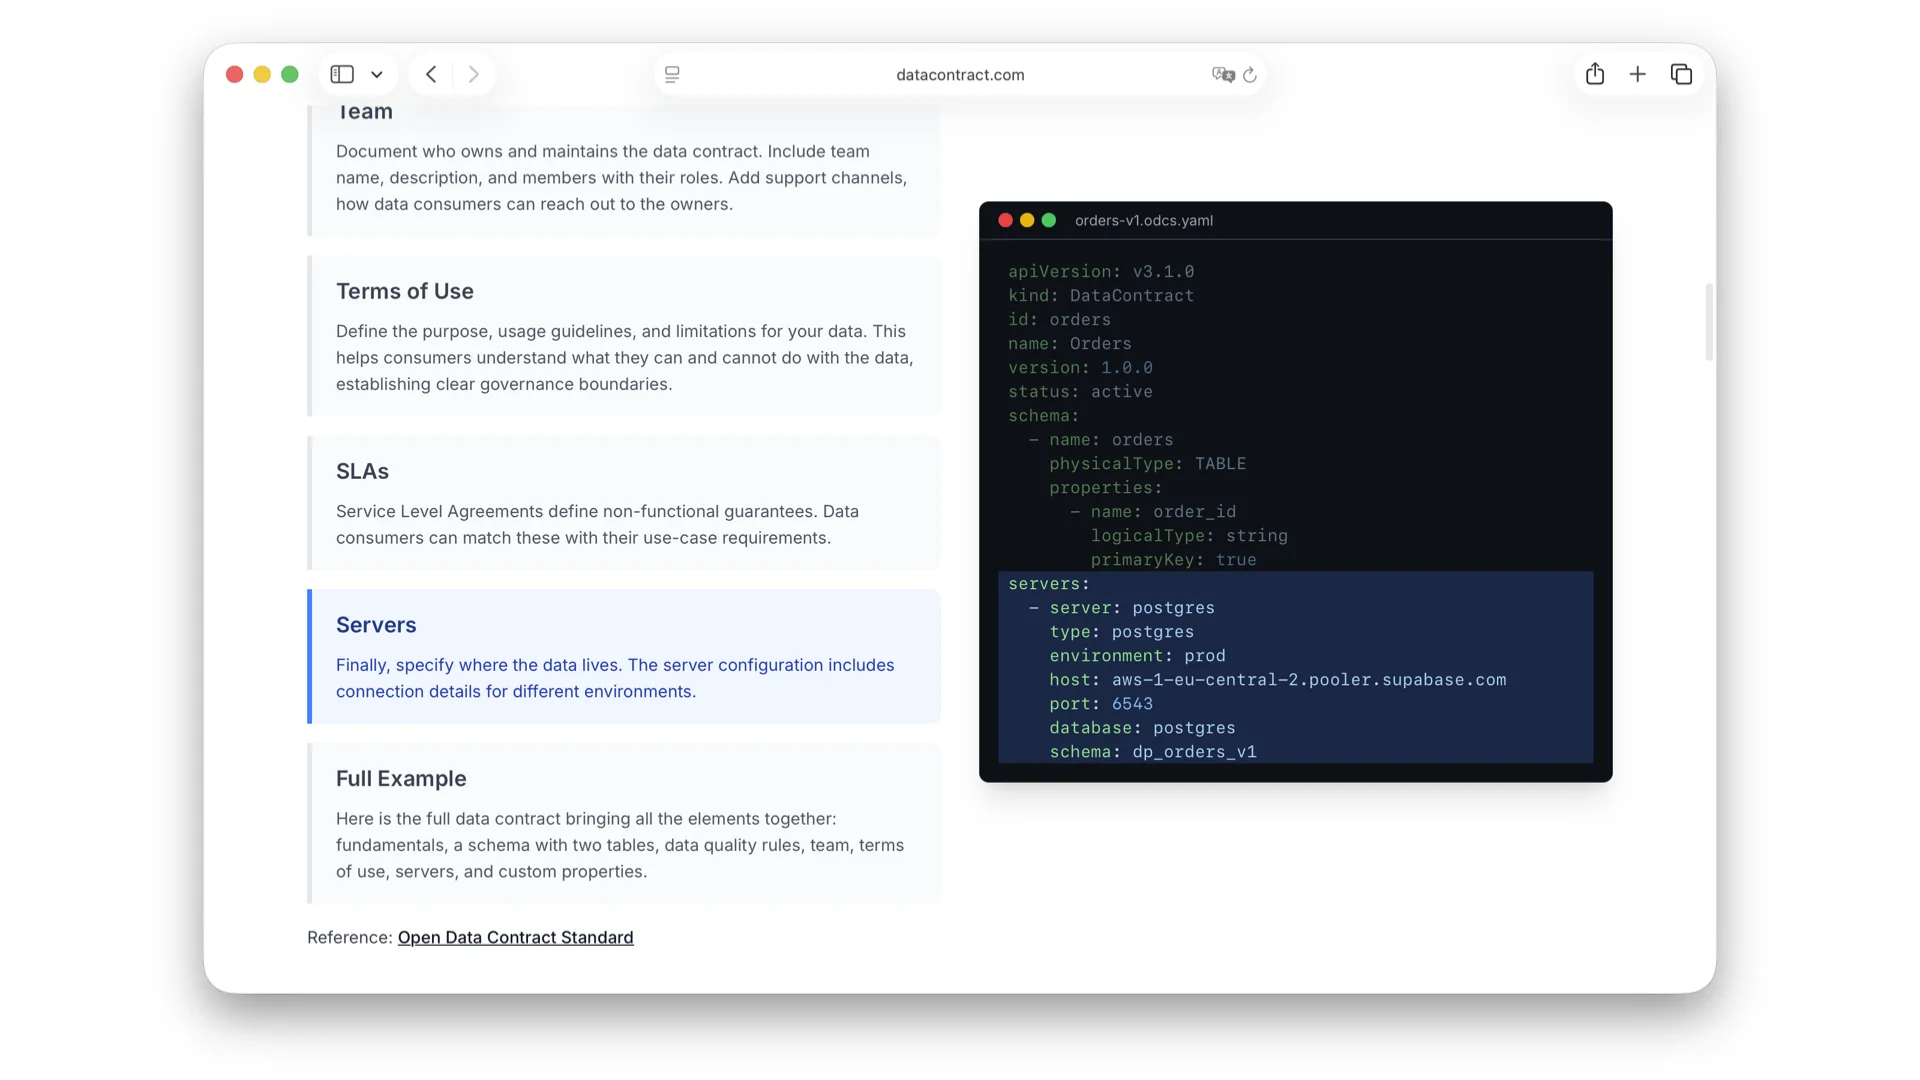
Ce que contient un contrat ODCS
ODCS offre de nombreuses briques pour qu’un producteur décrive son offre. Un seul fichier YAML contient :
- Les fondamentaux : identifiant, nom, version, statut pour introduire ou retirer une offre.
- Le schéma : tables et colonnes avec leurs types, clés primaires et étrangères, noms métier, classifications, marqueurs PII. Même si vos données sont du JSON sur S3 ou du CSV sur SFTP, vous pouvez déclarer les relations : techniquement, elles existent bel et bien.
- La qualité des données : des énumérations comme order_status ∈ {pending, shipped, cancelled}, ou des contrôles SQL libres du type « le nombre de lignes doit dépasser 100 000 ».
- L’équipe et le support : comment joindre les owners, canaux Slack, systèmes de tickets.
- Les conditions d’utilisation : ce que les consommateurs ont le droit de faire, ou non, avec les données.
- Les SLA : fraîcheur, rétention, disponibilité, le tout suivi par les outils.
- Les serveurs : l’endroit où vivent réellement les données, pour que les consommateurs qui ont l’accès aillent directement au bon endroit.
Le standard définit la structure YAML et ce que vous pouvez exprimer. Tout le reste se construit par-dessus.
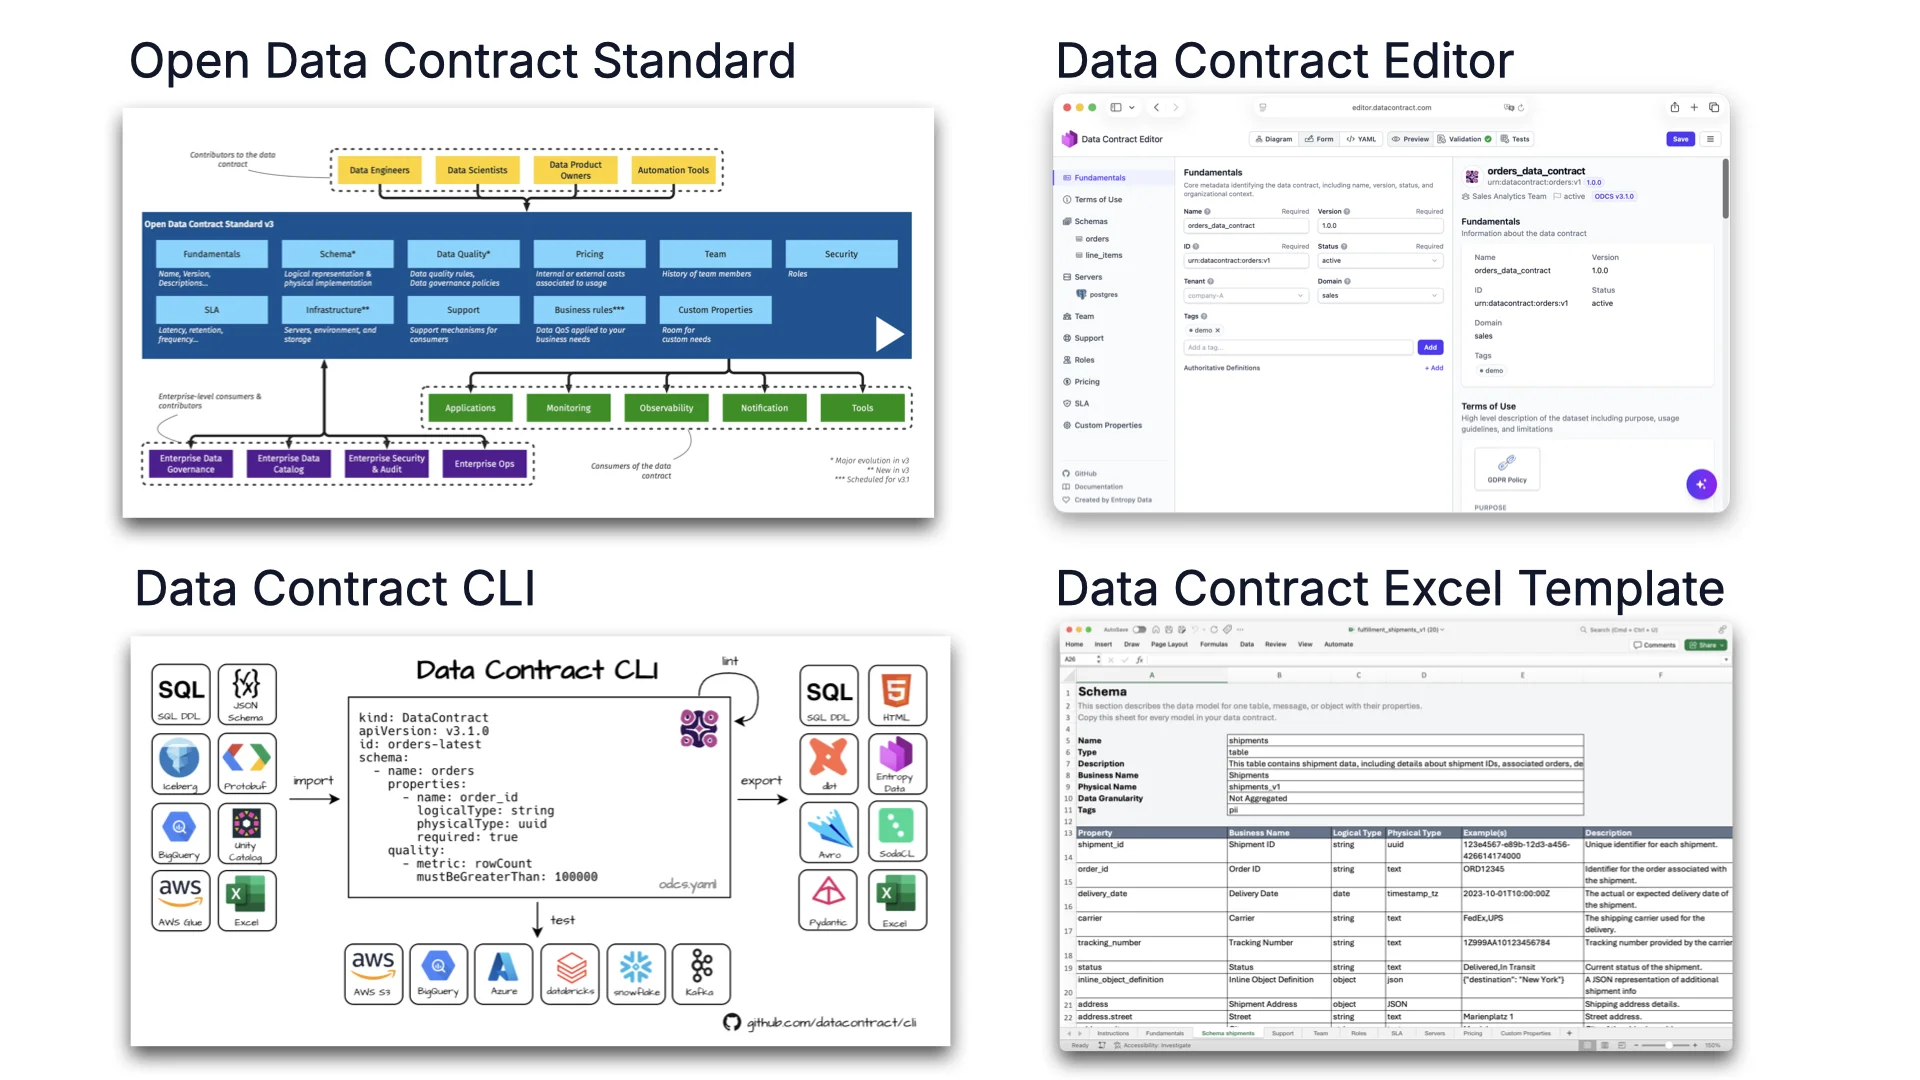
Tout automatiser
Une fois le YAML en main, vous pouvez automatiser : comparer le contrat aux données réelles, détecter les changements cassants dans une PR, surveiller la production en continu, générer du Java, du Pydantic, des modèles dbt, du DDL SQL, et pousser les métadonnées vers des metastores, des catalogues comme Collibra, des marketplaces comme Entropy Data ou des catalogues applicatifs comme LeanIX. La Data Contract CLI fait tout cela, en se connectant à Snowflake, Databricks, BigQuery ou autre, et produit un rapport sur le degré de conformité des données aux garanties annoncées. Sous le capot, nous utilisons Soda Core pour exécuter les contrôles de qualité, un projet open source lui aussi issu d’une entreprise belge, ce qui tombe plutôt bien ici à Louvain.
Et si vous regardez l’historique des étoiles sur GitHub, la Data Contract CLI est plus populaire que la spécification ODCS elle-même. La leçon est là : l’outillage compte plus que le standard. Le standard existe parce qu’il vous donne l’outillage gratuitement, parce qu’il évite l’enfermement propriétaire dès lors que plusieurs éditeurs prennent en charge le même format, et parce qu’il nous fait nous entraider plutôt que réinventer dix fois la même chose.
Un contrat, c’est aussi la meilleure métadonnée que vous puissiez donner à une IA. Si vous combinez l’IA avec ce type de métadonnées structurées, en particulier avec les modèles modernes de la classe Opus, plus rien ne vous arrête.
Des éditeurs pour les humains (et pour le métier)
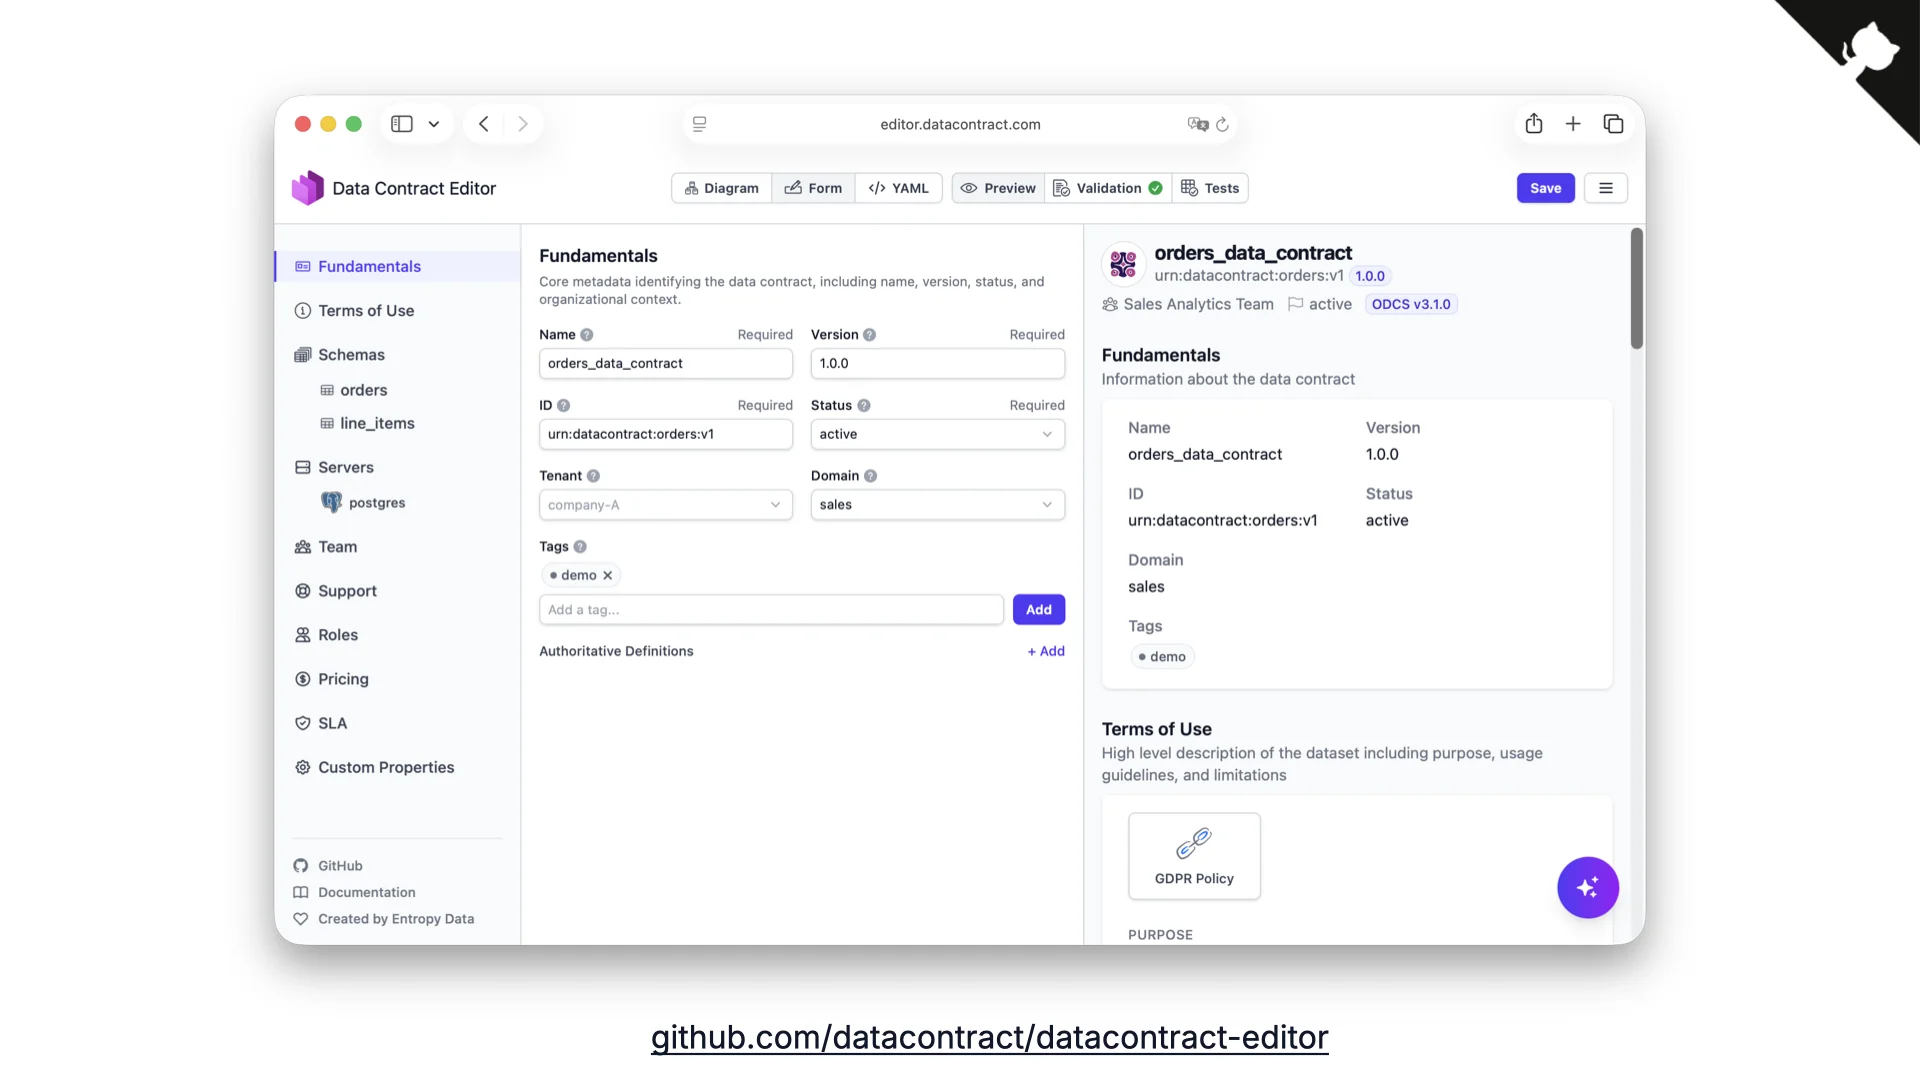
Écrire du YAML à la main demande beaucoup de travail, alors nous avons construit le Data Contract Editor. Il permet de remplir un contrat via une vue formulaire, une vue diagramme ou le YAML brut, avec aperçu et validations intégrés. Point essentiel : c’est là que le métier et la technique se rejoignent. Le métier raisonne en colonnes et comprend les données, la technique complète les détails physiques manquants. Souvent, le métier commence et la technique termine.
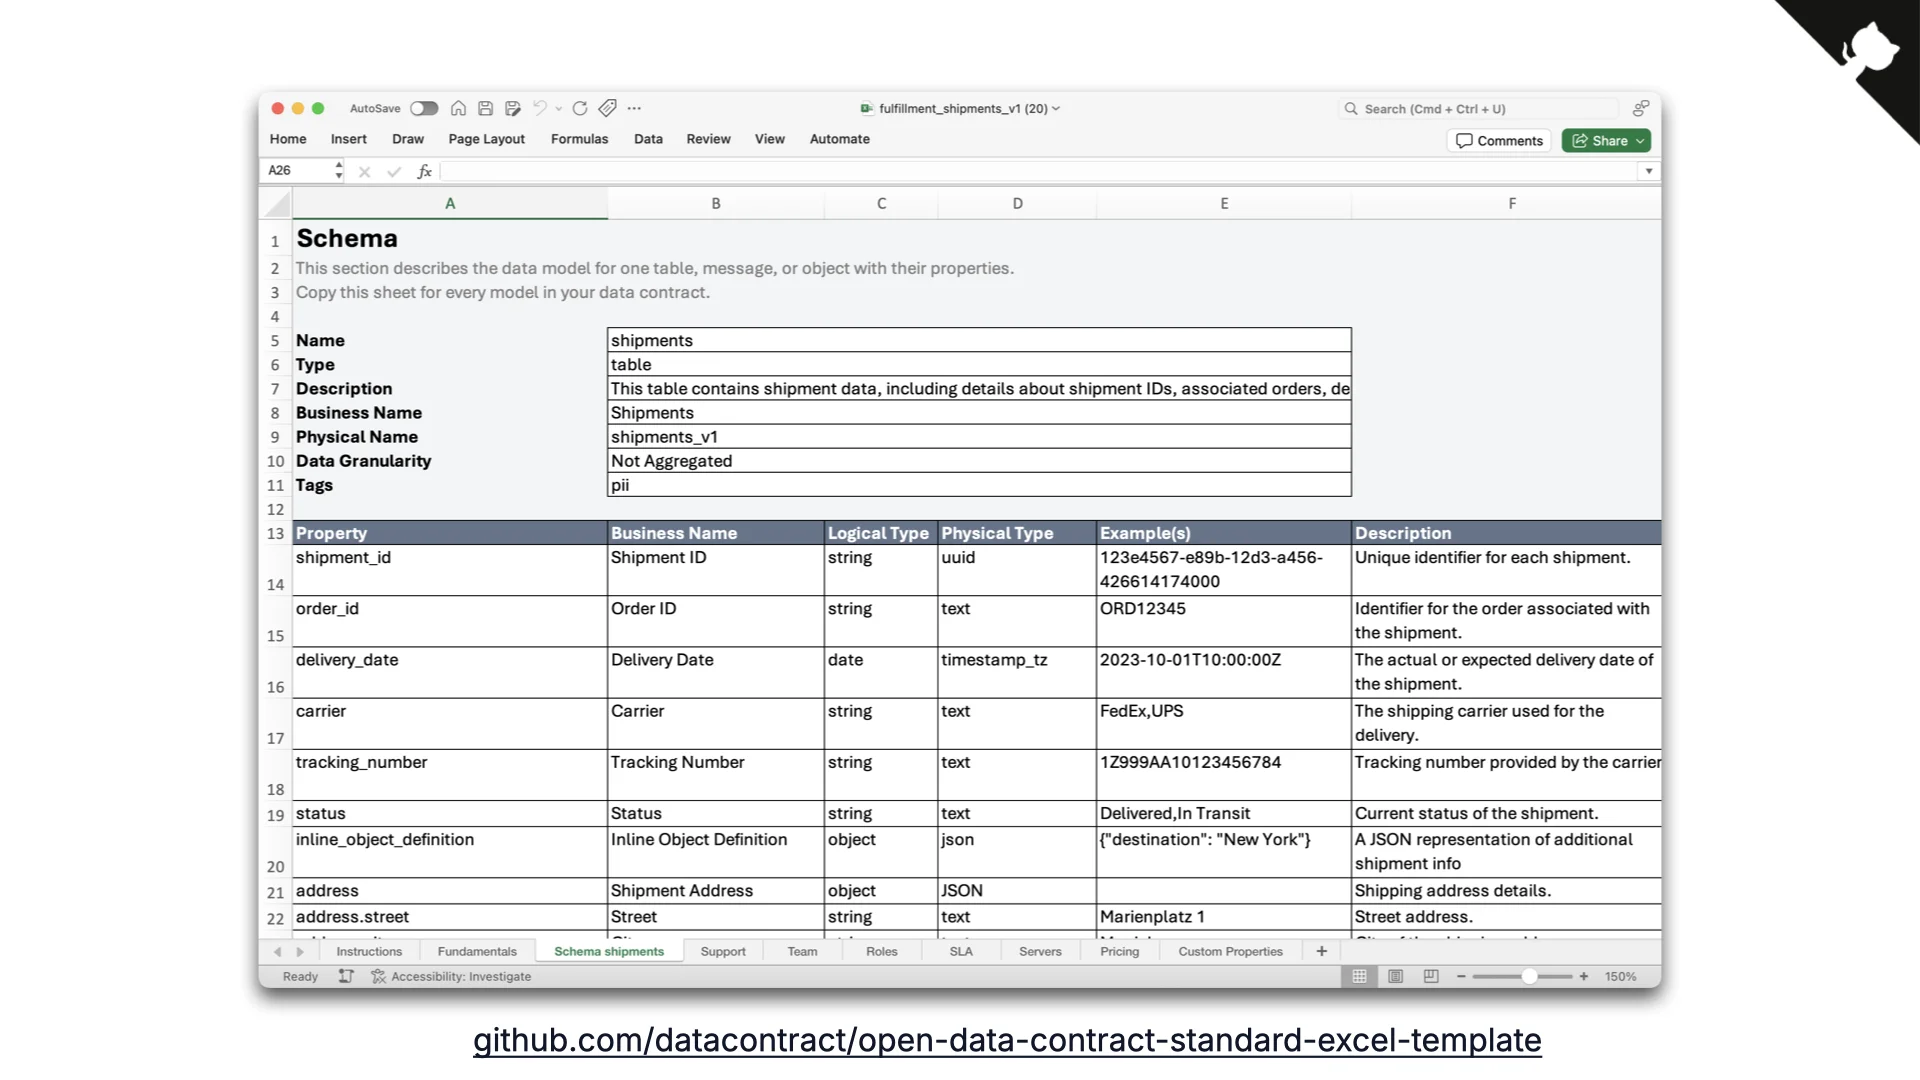
Pour les profils encore plus métier, nous avons créé un modèle Excel pour ODCS. Il rencontre un succès étonnant. La CLI le convertit en YAML conforme et poursuit le traitement.
Un standard ouvert, un éditeur open source, un outillage d’automatisation et un modèle Excel : vous avez tout ce paquet gratuitement, sans paywall. Servez-vous.
L’Open Data Product Standard (ODPS)
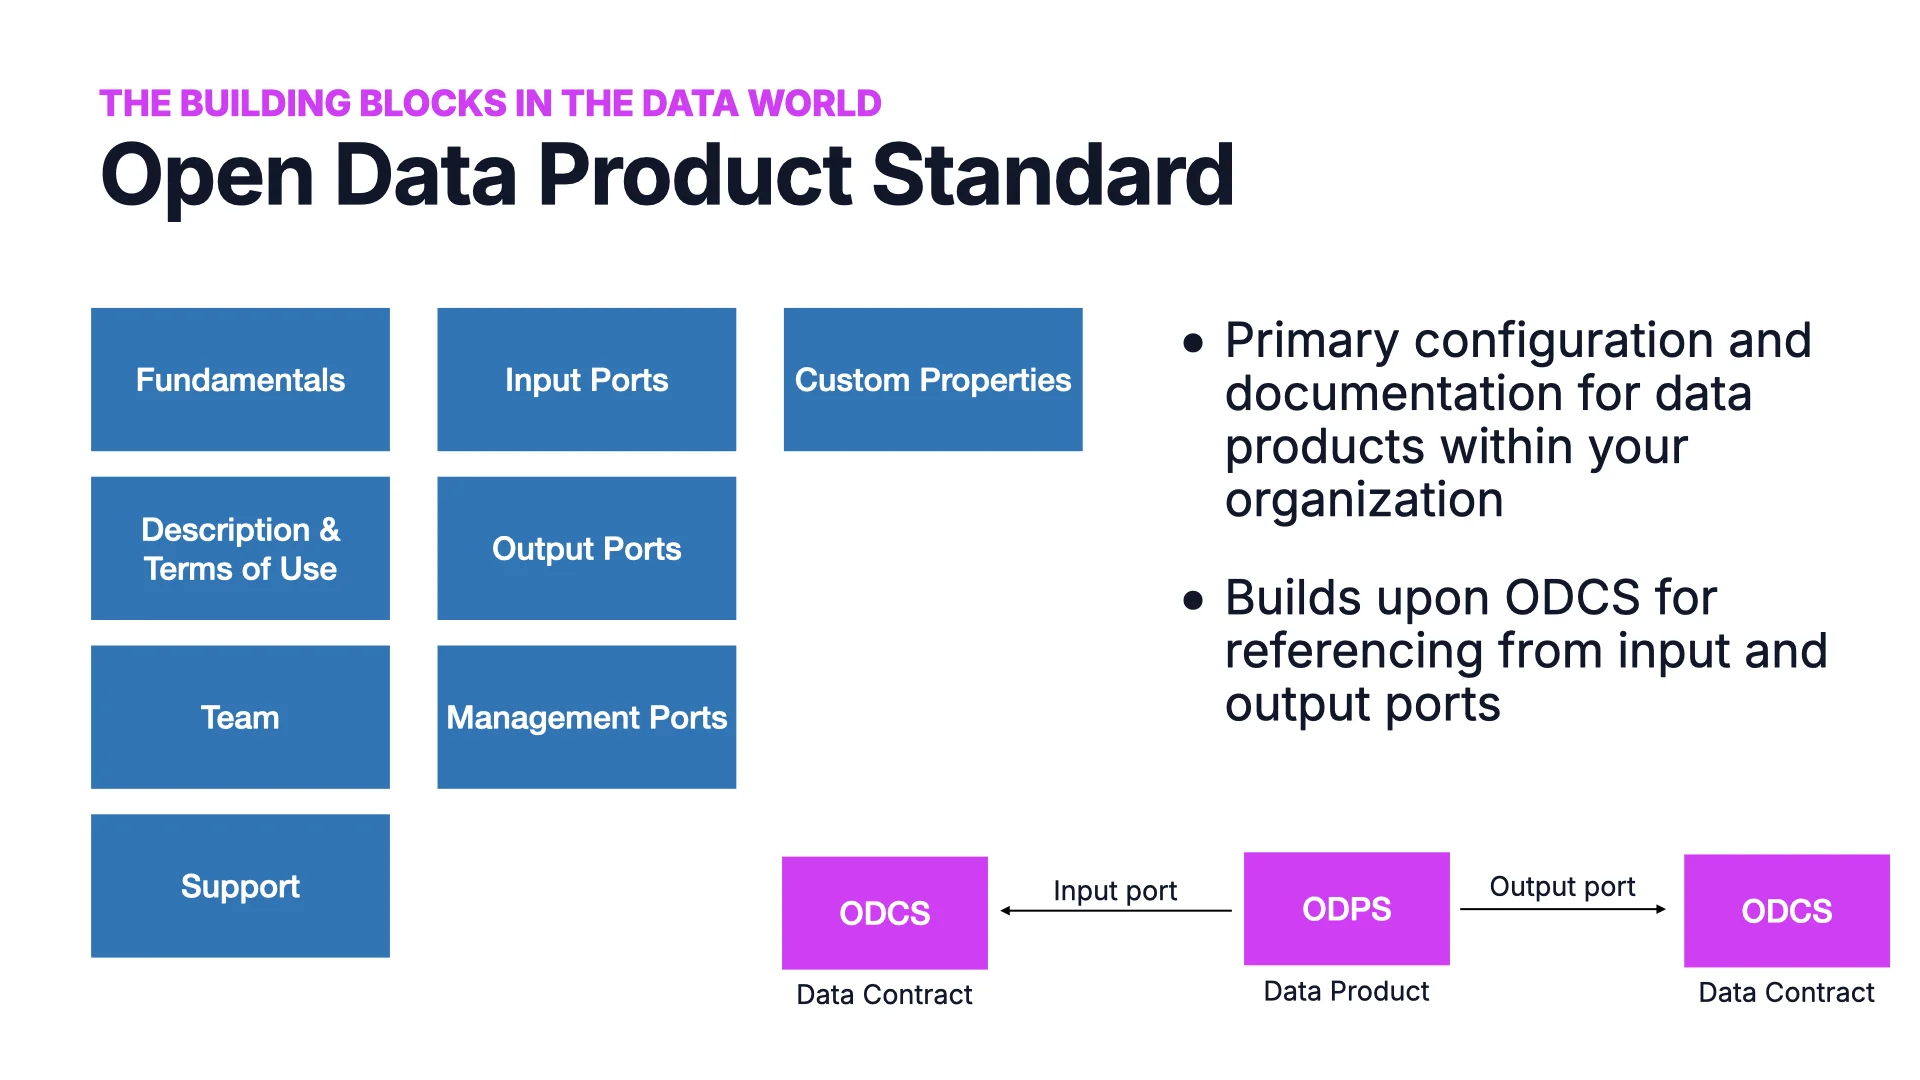
Les contrats sont un pilier. Les produits de données sont l’autre. L’Open Data Product Standard (ODPS), porté par le projet BITOL, reprend ODCS sur les fondamentaux, les conditions d’utilisation, l’équipe, le support et les propriétés personnalisées. La différence essentielle : les Input Ports, les Output Ports et les management ports. Chaque port renvoie à un Data Contract ODCS.
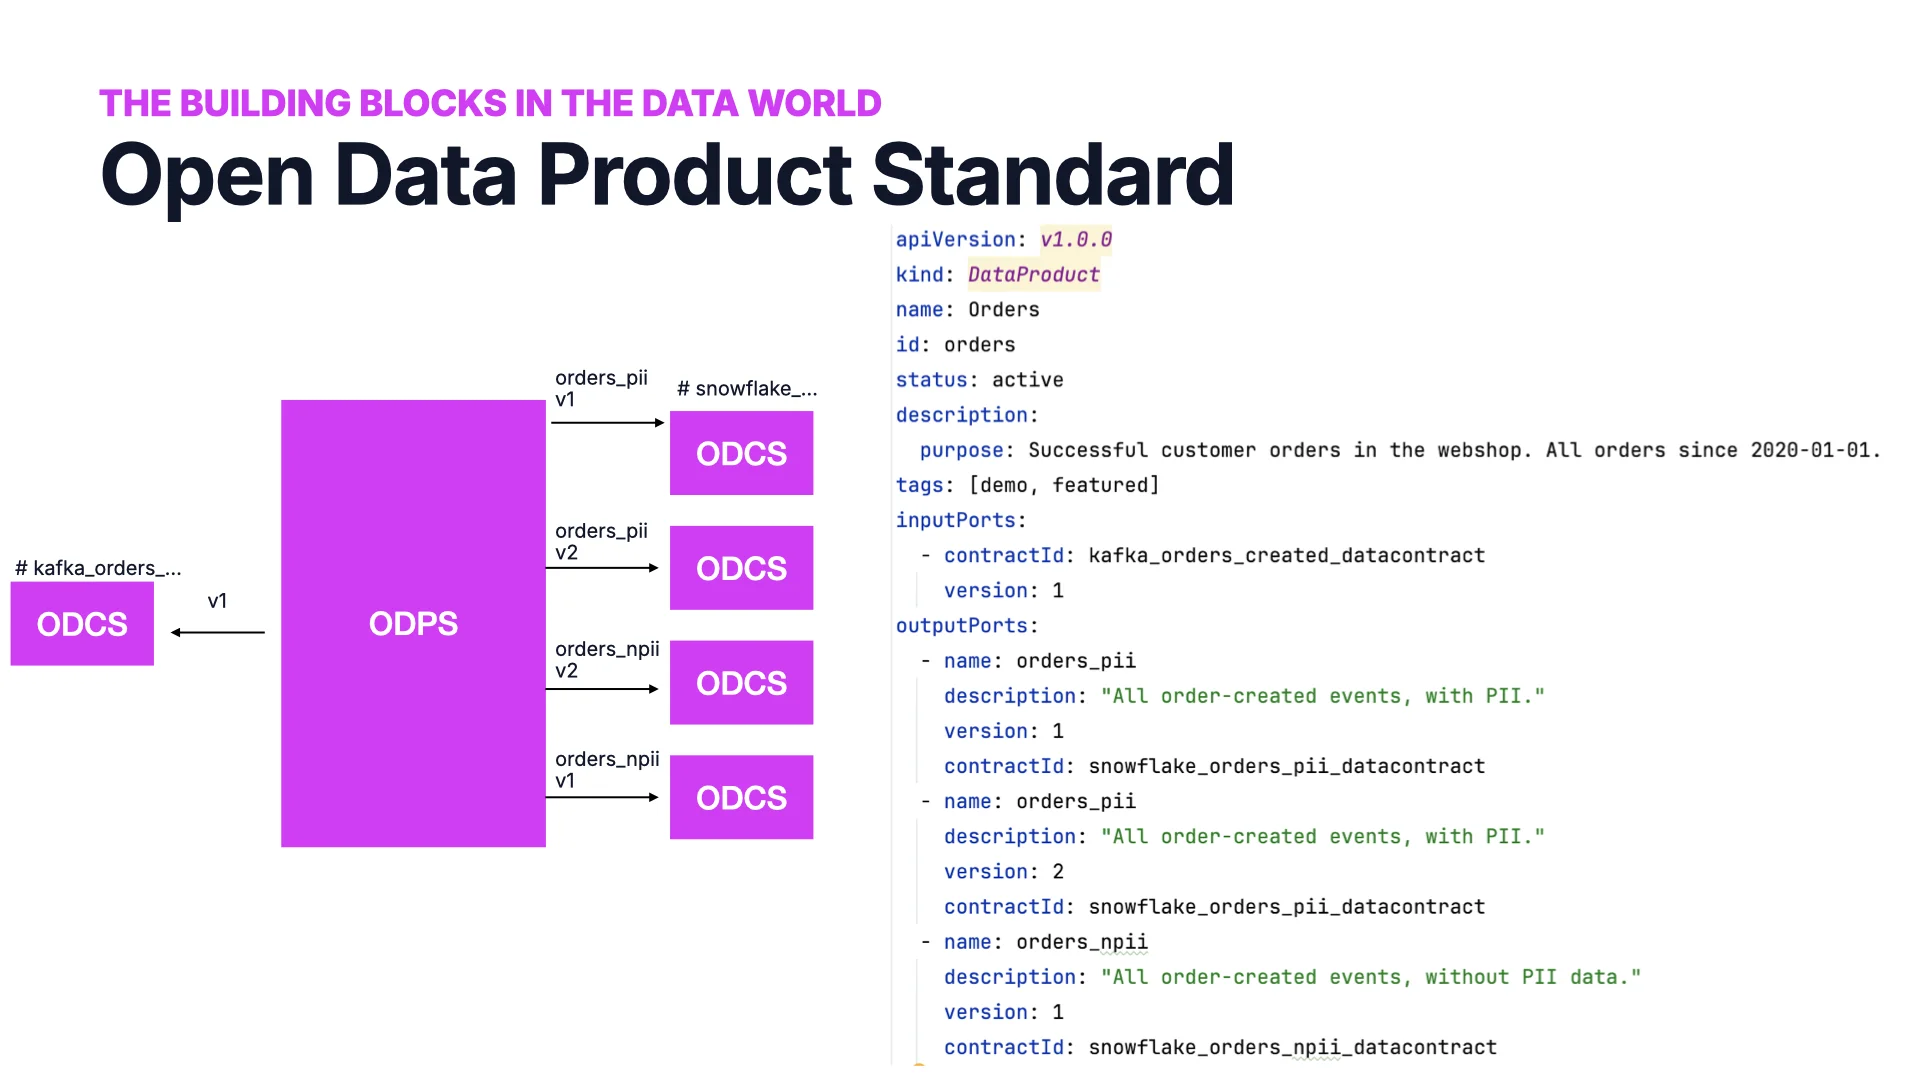
Comme ODPS s’appuie sur ODCS, si vous avez déjà des contrats, le fichier du produit de données est très court. Un fichier typique comporte un nom, une description, une version et quelques ports : par exemple un Input Port Kafka en v1 et quatre Output Ports Snowflake pour PII et non-PII en v1 et v2. C’est tout. Mis ensemble, ils forment le graphe de votre Data Mesh.
Du YAML à un graphe de mesh vivant
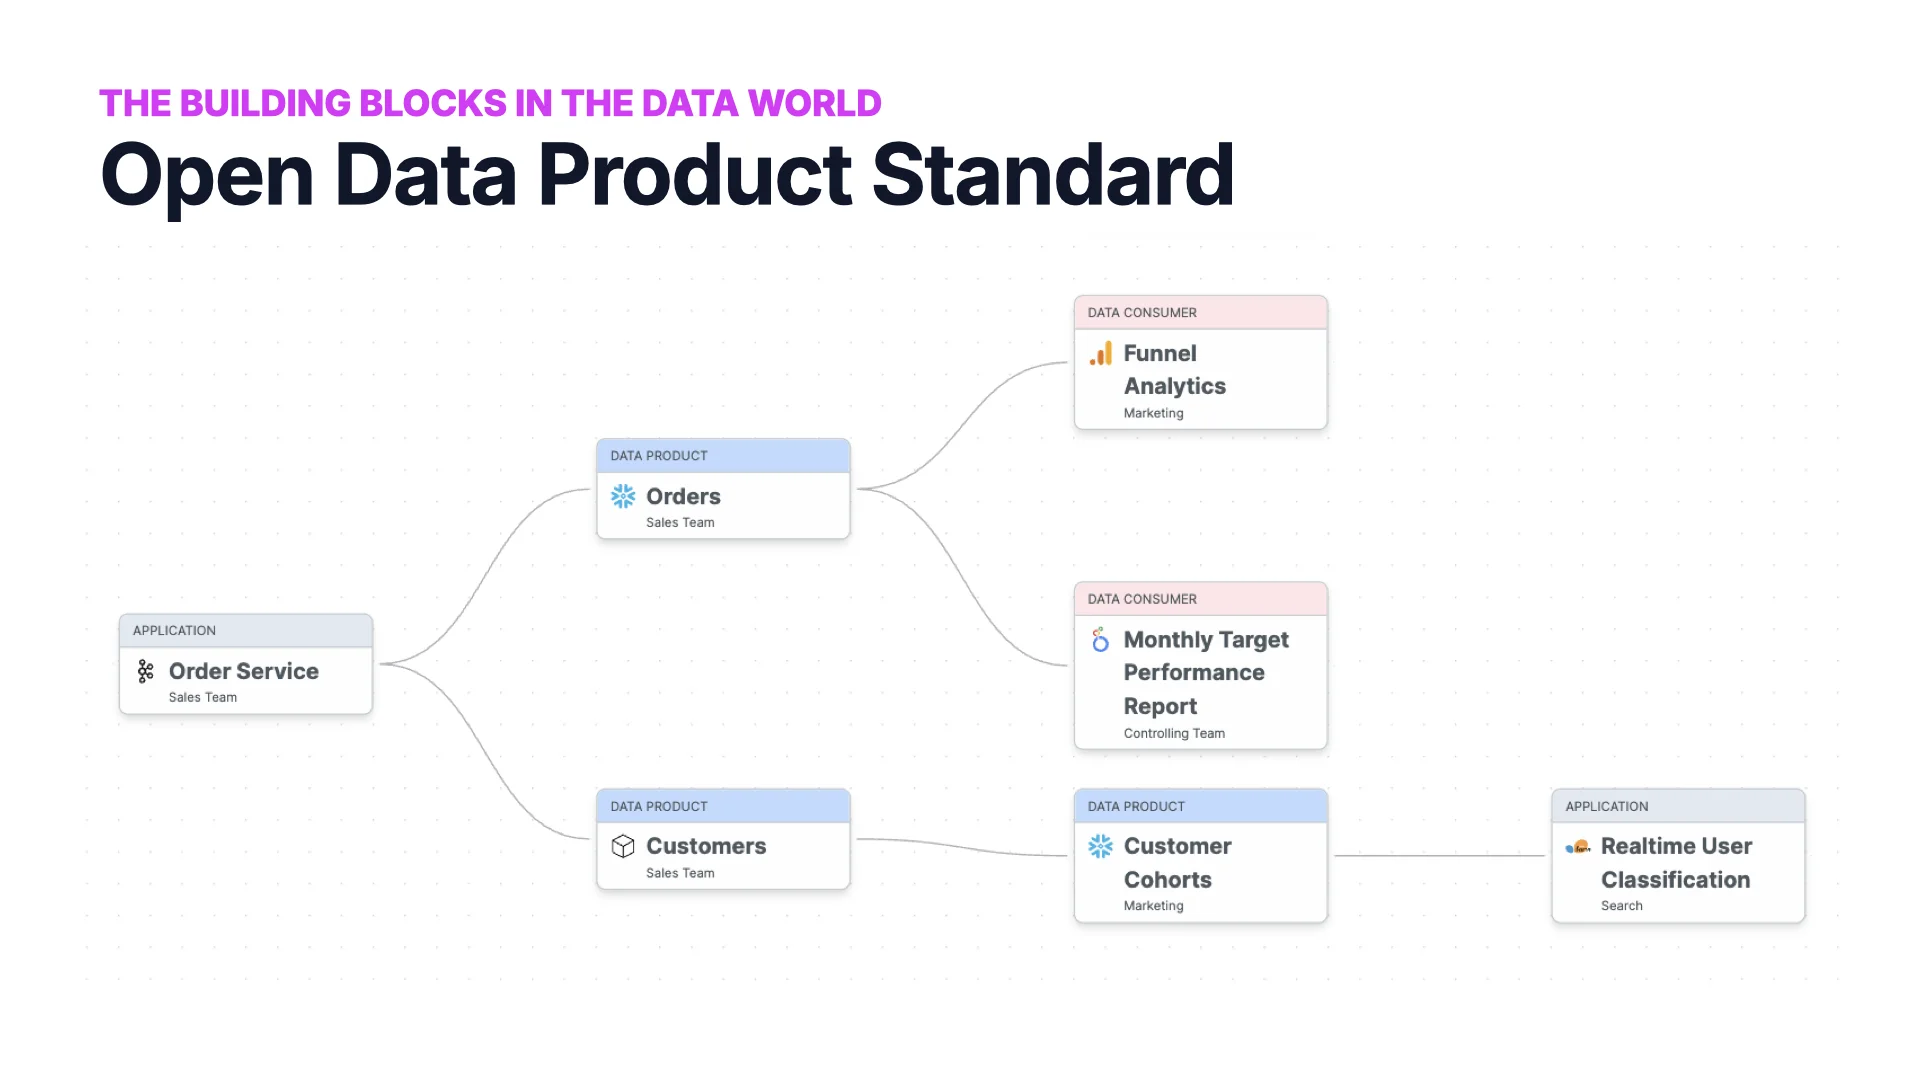
Comme chaque produit de données déclare ses Input Ports et ses Output Ports dans ODPS, et que chaque port référence un contrat ODCS, vous obtenez gratuitement un graphe de dépendances complet. Les applications sources alimentent les produits de données ; les produits de données alimentent d’autres produits de données ou directement des cas d’usage côté consommateur, comme l’analyse de tunnel de conversion, les rapports d’objectifs mensuels ou la classification d’utilisateurs en temps réel.
Tout est là : c’est le standard qui permet au graphe d’exister. Visualisez-le et vous avez la carte de votre Data Mesh, entièrement dérivée des fichiers YAML de contrats et de produits, et non dessinée à la main.
Attention quand vous demandez à Claude
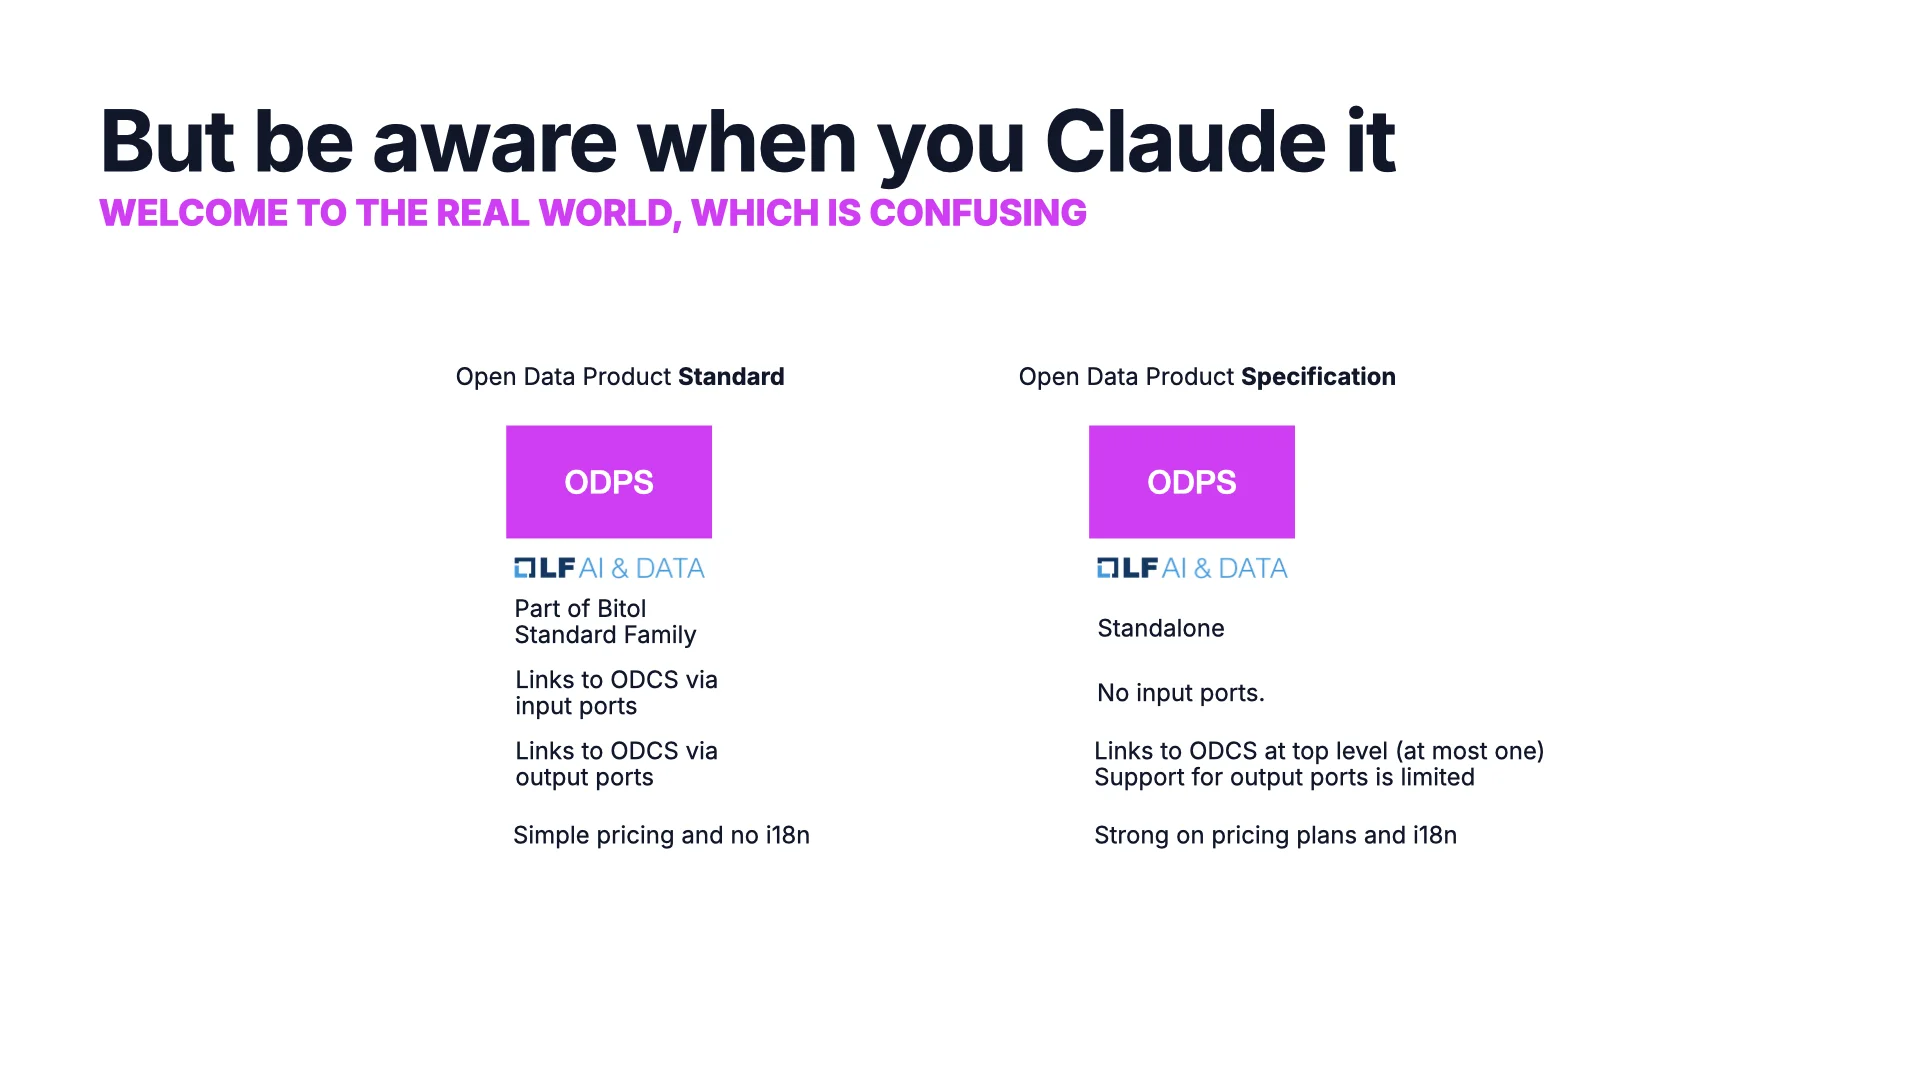
Il y a ici une vraie source de confusion. Deux projets différents de la Linux Foundation partagent le même acronyme : ODPS désigne à la fois « Open Data Product Standard » (celui que je viens de décrire, qui fait partie de BITOL) et « Open Data Product Specification » (un projet indépendant). Quand vous faites une recherche, ou quand vous interrogez Claude, il faut savoir lequel des deux vous avez sous les yeux.
Les modèles mentaux diffèrent. Le Standard de BITOL modélise les produits de données avec plusieurs Input Ports, plusieurs Output Ports et des liens vers de nombreux contrats ODCS : il est conçu comme une famille de standards composables. La Specification, elle, ne connaît pas la notion d’Input Port et n’autorise au plus qu’un seul contrat lié au niveau racine ; en revanche elle est très solide sur les grilles tarifaires et l’internationalisation, ce qui la rend plus adaptée si vous opérez une marketplace externe avec des conditions commerciales complexes.
Aucun des deux n’a tort, ils résolvent simplement des problèmes différents sous le même nom. Je suis dans le camp BITOL parce que la composition d’une famille de standards me tient à cœur. C’est mon biais, le vôtre peut être différent.
La suite pour la famille BITOL
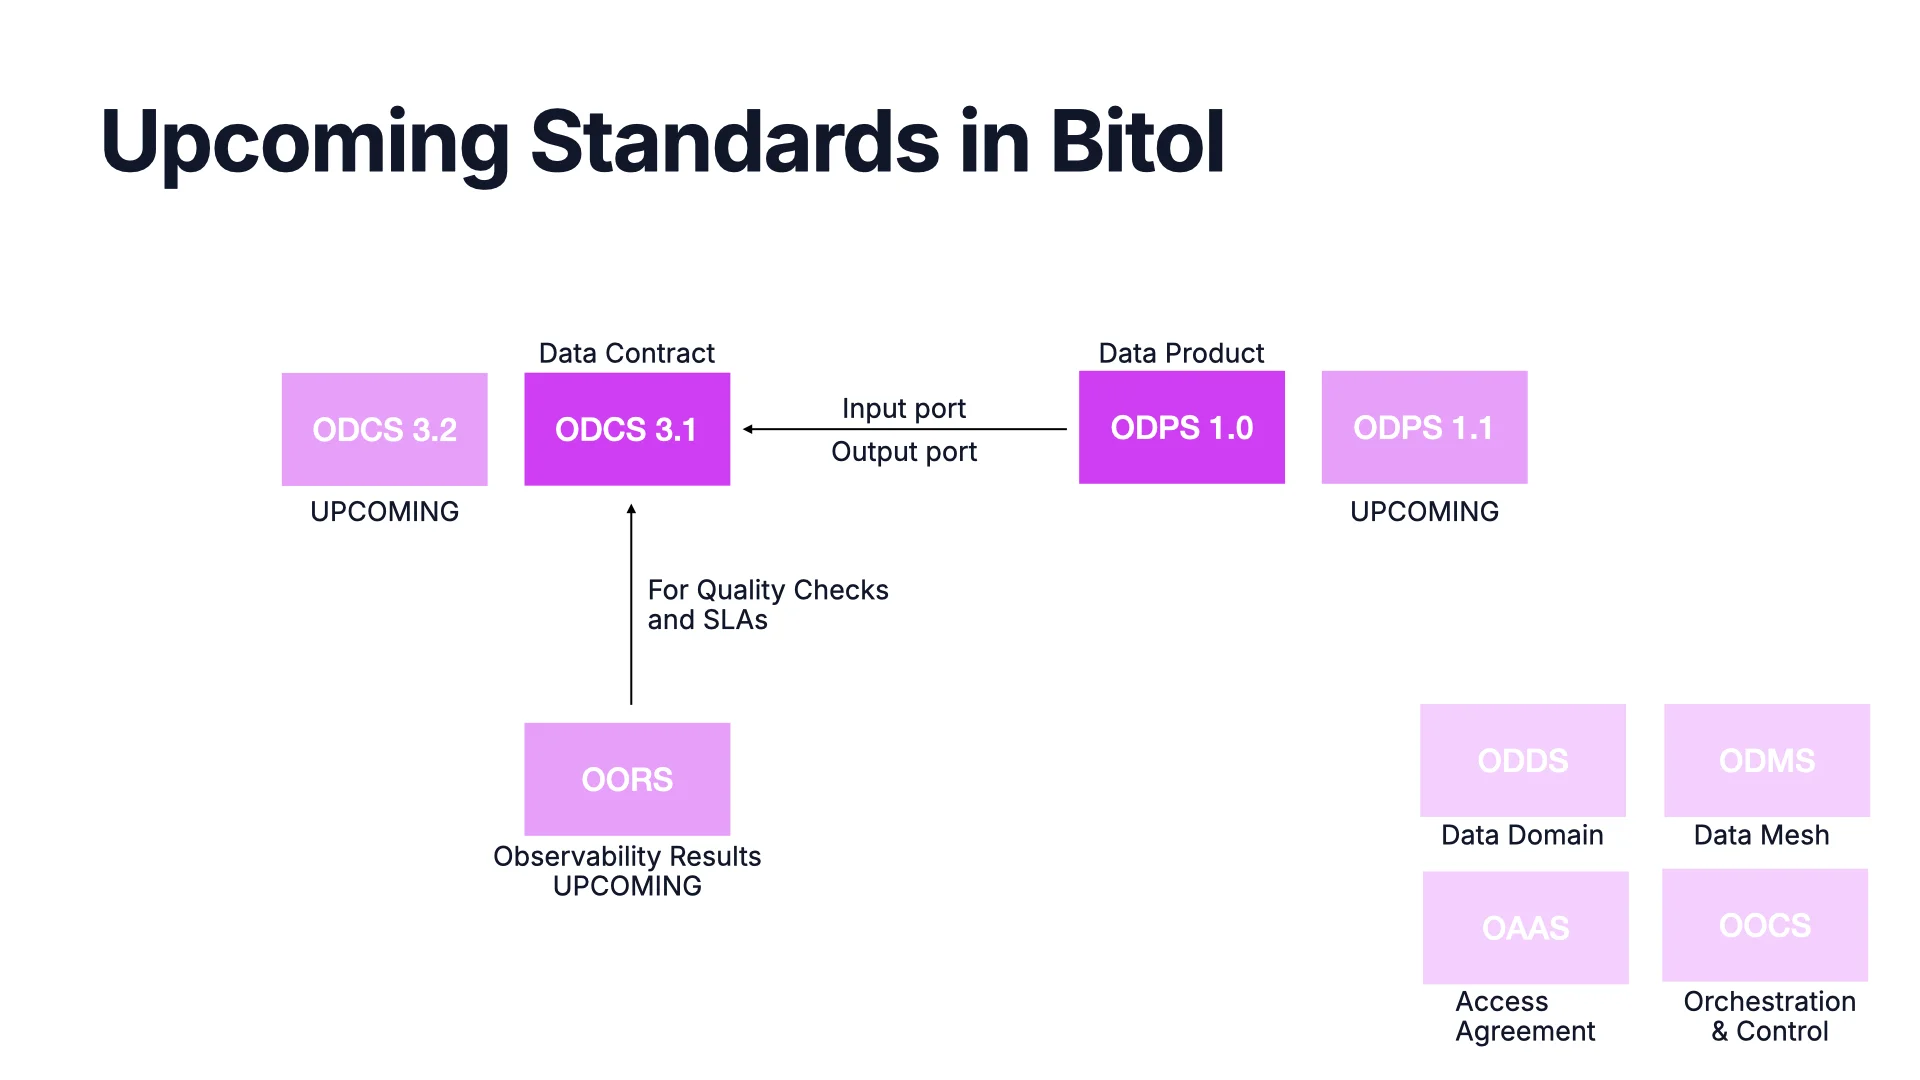
ODCS 3.1 et ODPS 1.0 sont aujourd’hui les standards du noyau. Les versions mineures prévues cette année portent surtout sur l’ajout de contexte pour l’IA, c’est-à-dire des métadonnées que les agents peuvent exploiter pour découvrir les données et générer des requêtes.
Autour de ce noyau, nous rédigeons des standards auxiliaires : OORS pour les résultats d’observabilité (à quoi ressemble le résultat d’un contrôle de qualité ?), OAAS pour les accords d’accès et les workflows de demande d’accès, ODDS pour les domaines de données, ODMS pour le Data Mesh et OOCS pour l’orchestration et le contrôle. Le noyau reste le noyau ; les auxiliaires couvrent les cas de bord que toute marketplace doit bien encoder d’une manière ou d’une autre.
Open Semantic Interchange (OSI)
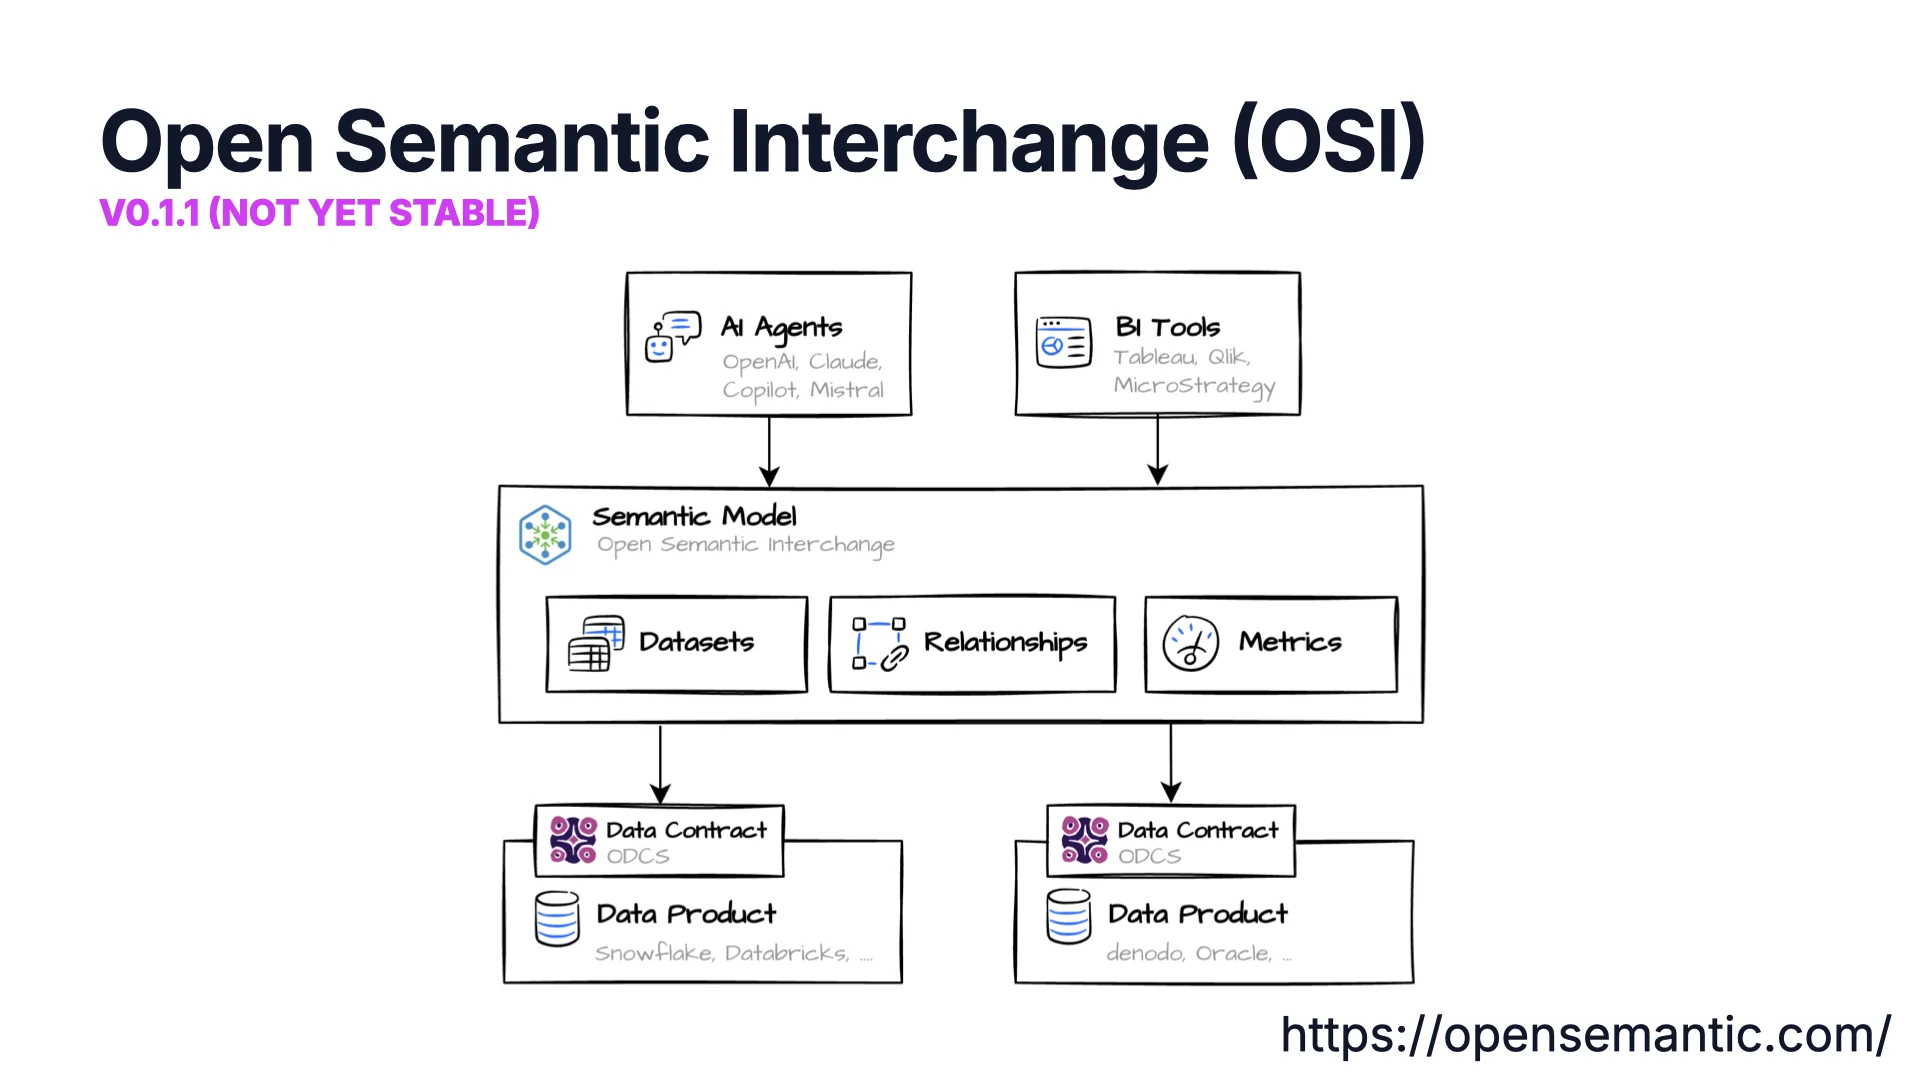
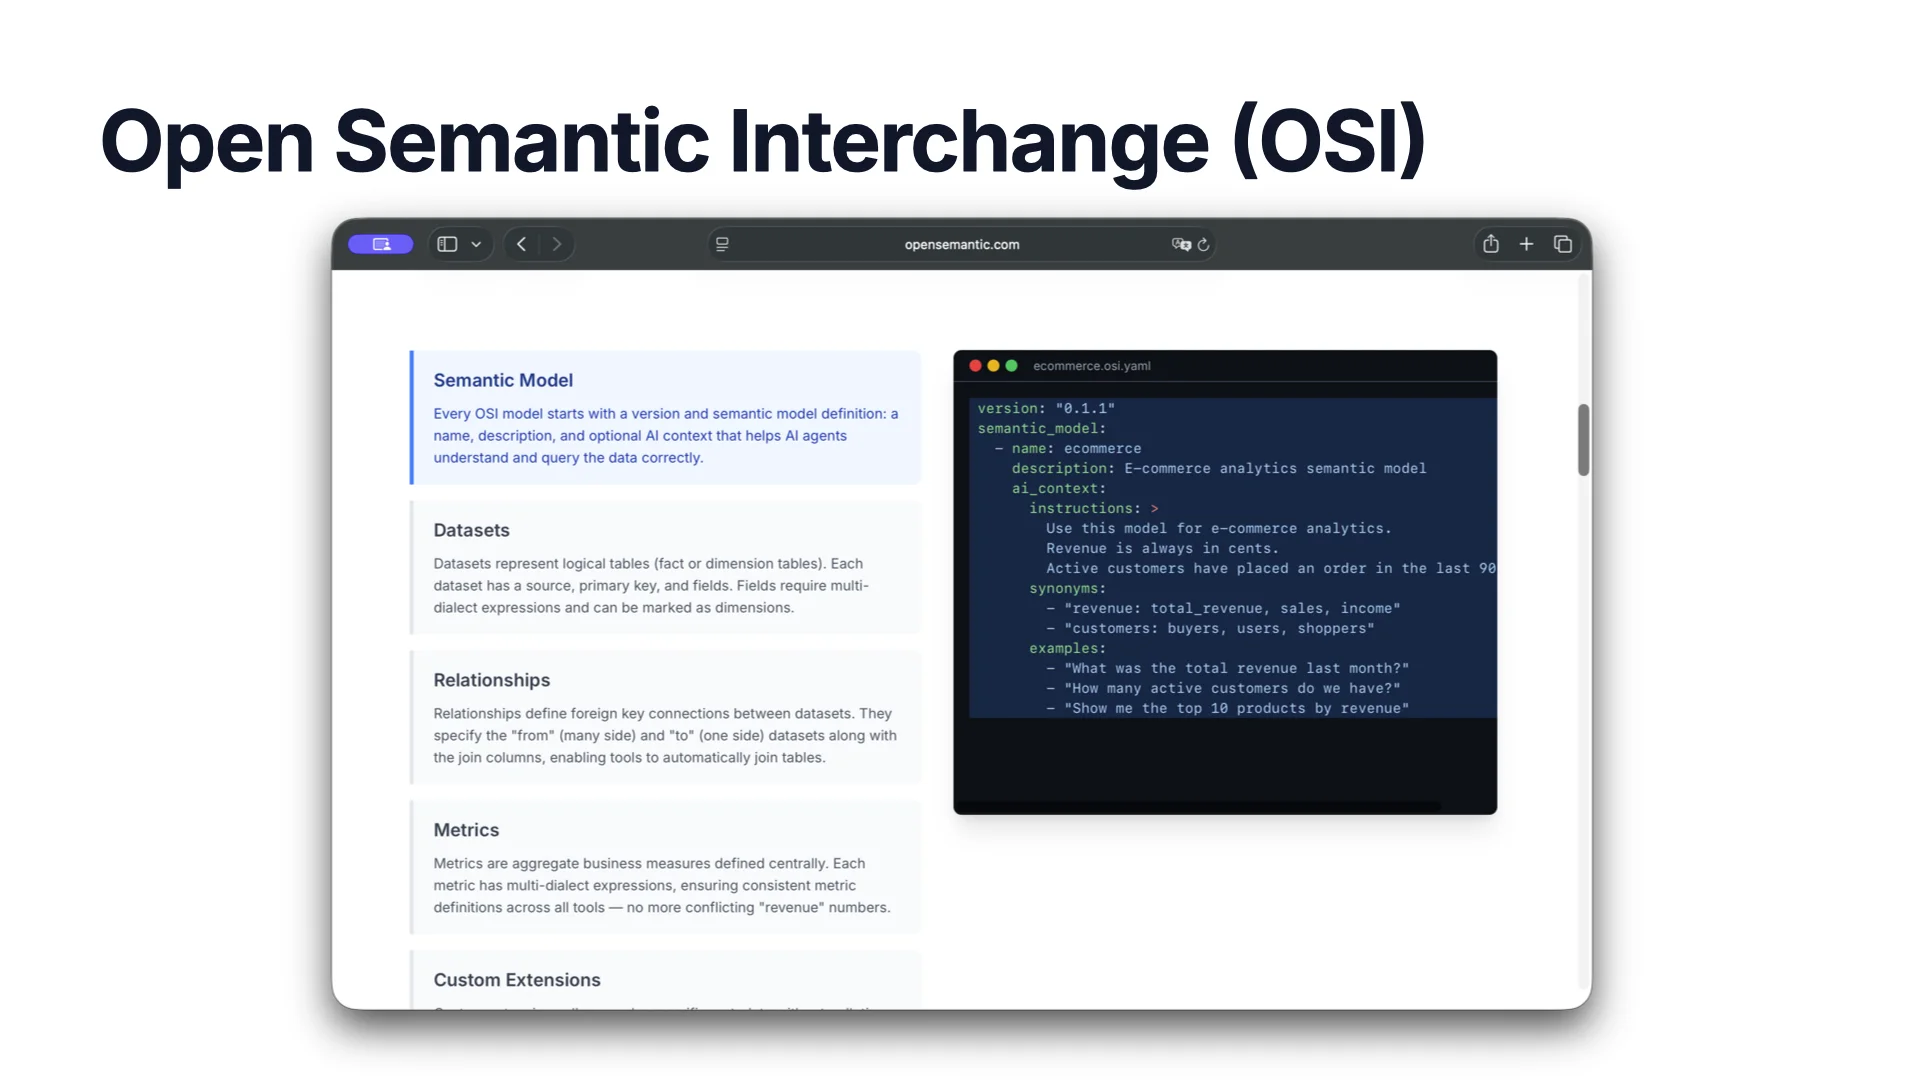
Nouvelle collision d’acronymes : OSI, c’est aussi le modèle en couches réseau appris en cours d’informatique. Ici, il s’agit de l’Open Semantic Interchange, une initiative portée par Snowflake avec beaucoup d’autres entreprises. On en est à la version 0.1.1, explicitement pas encore stable, mais les groupes de travail sont très actifs.
L’idée centrale : par-dessus vos produits de données et vos contrats, vous construisez un modèle sémantique avec des jeux de données, des relations et des métriques, un peu comme le modèle sémantique de Power BI. OSI y ajoute ensuite une couche pensée pour l’IA : instructions, synonymes et exemples, pour que les agents IA et les outils BI manipulent correctement les données.
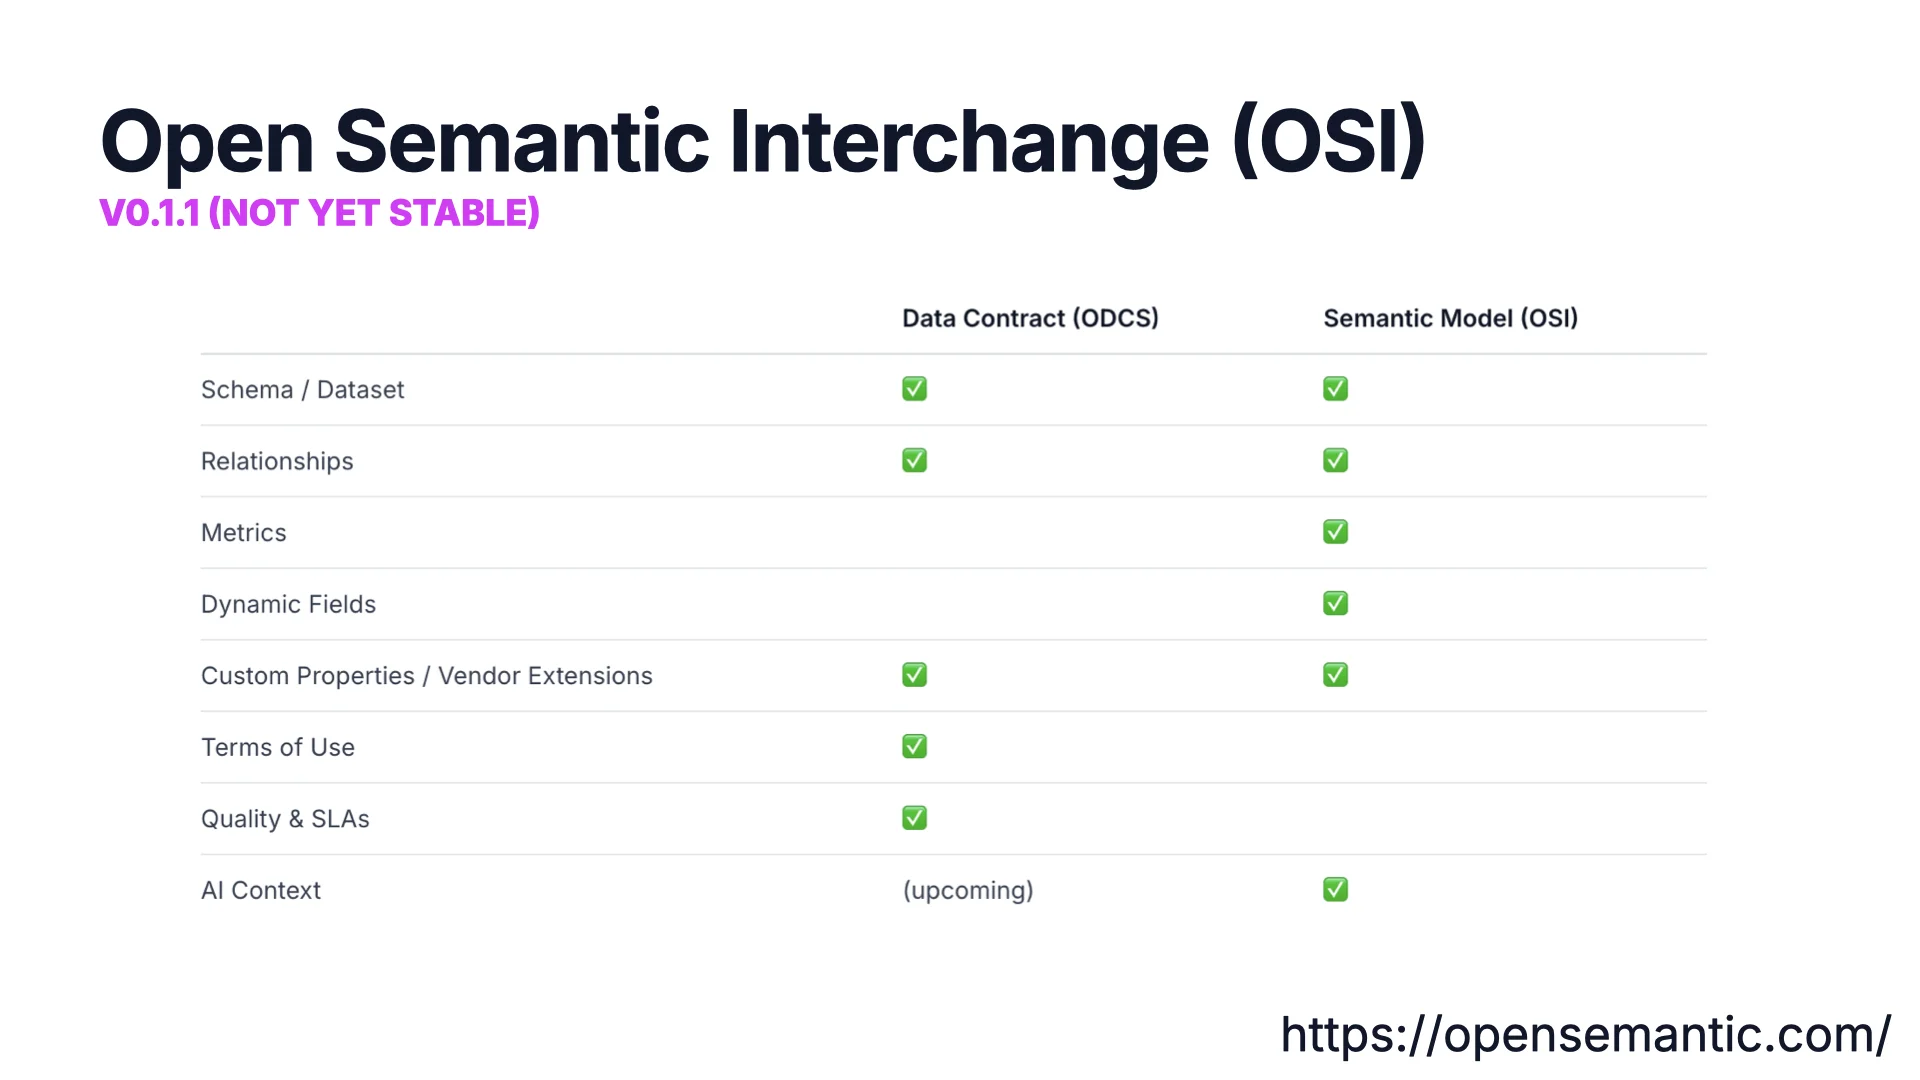
Par rapport à ODCS, les deux se recoupent sur les jeux de données, les relations et les extensions personnalisées. OSI ajoute les métriques (par exemple total_revenue = SUM(order_total)) et les champs dynamiques (par exemple full_name = first_name + " " + last_name). ODCS, lui, apporte ce qui manque encore à OSI : les conditions d’utilisation, les contrôles de qualité et les SLA. Le recoupement intéressant, c’est le contexte pour l’IA : tout le monde en veut, et c’est là que les deux évoluent.
Les groupes de travail sur l’ontologie, la composabilité et l’outillage sont tous actifs. Mon collègue et Co-Founder Jung y est lui aussi très impliqué. C’est un sujet à suivre.
Un éditeur pour les modèles sémantiques
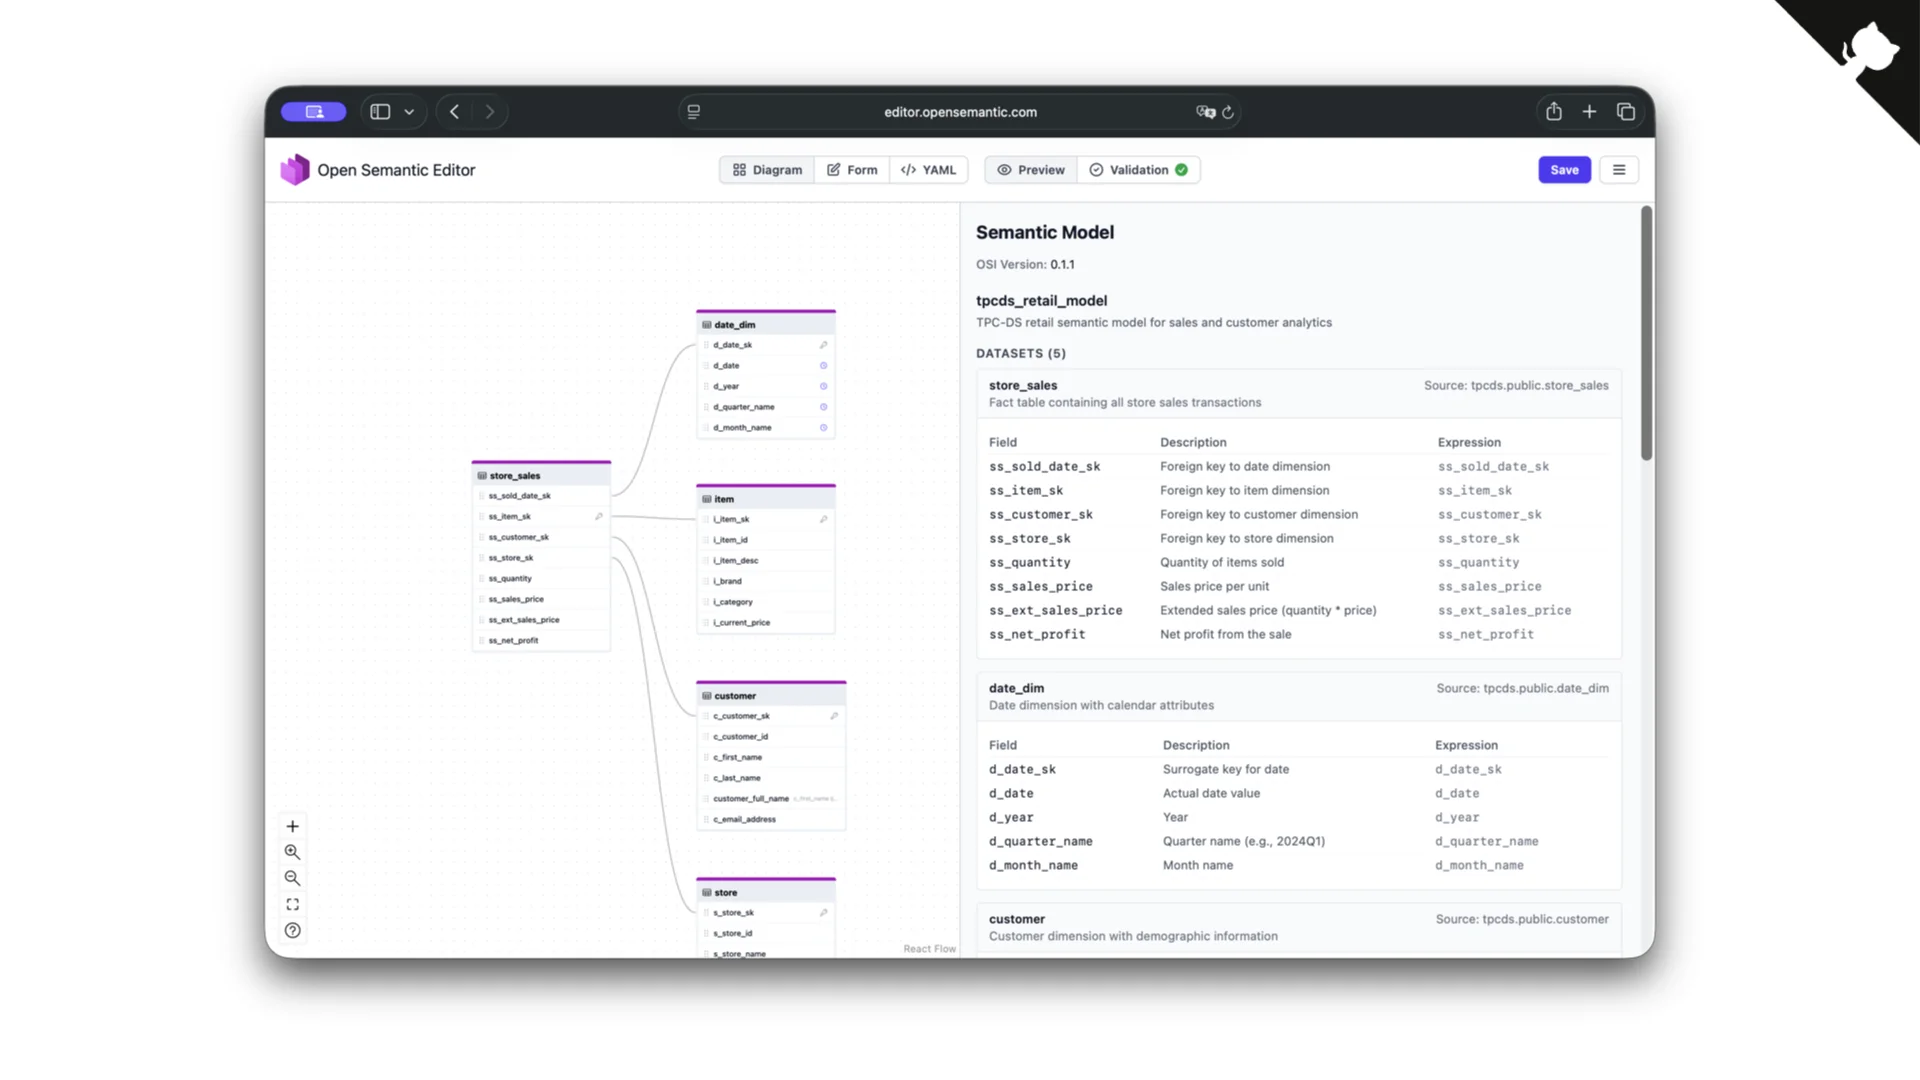
Comme un modèle OSI ressemble beaucoup à un contrat, avec ses tables, ses clés étrangères et ses relations, nous lui avons aussi construit un petit éditeur open source, disponible sur editor.opensemantic.com (le code est sur GitHub). Même principe que le Data Contract Editor : vues diagramme, formulaire et YAML, avec aperçu et validation.
Pour être honnête, c’est Claude Code qui en a construit l’essentiel en un après-midi. Et c’est possible précisément parce que le format sous-jacent est un standard ouvert que le modèle connaît déjà.
Et beaucoup de poids derrière
OSI en est encore à la 0.1.1, mais les groupes de travail derrière sont sérieux :
- Advanced Metrics & Expression Language : pour aller au-delà des bases que vous venez de voir.
- Composability : comment les modèles OSI se référencent et se composent entre eux.
- Catalog Integration : le raccordement à la couche catalogue de données de l’entreprise.
- Ontology Representation : concepts et propriétés sous forme de graphe. Mon Co-Founder Jochen Christ y est très impliqué.
- Model converters & developer tools : là où se construit vraiment l’histoire de l’écosystème.
Quand on regarde la liste des membres, Snowflake, Databricks, Tableau, MicroStrategy et bien d’autres, on voit qu’il y a beaucoup de poids derrière. Cela vaut la peine de suivre.
Un paysage bien plus vaste
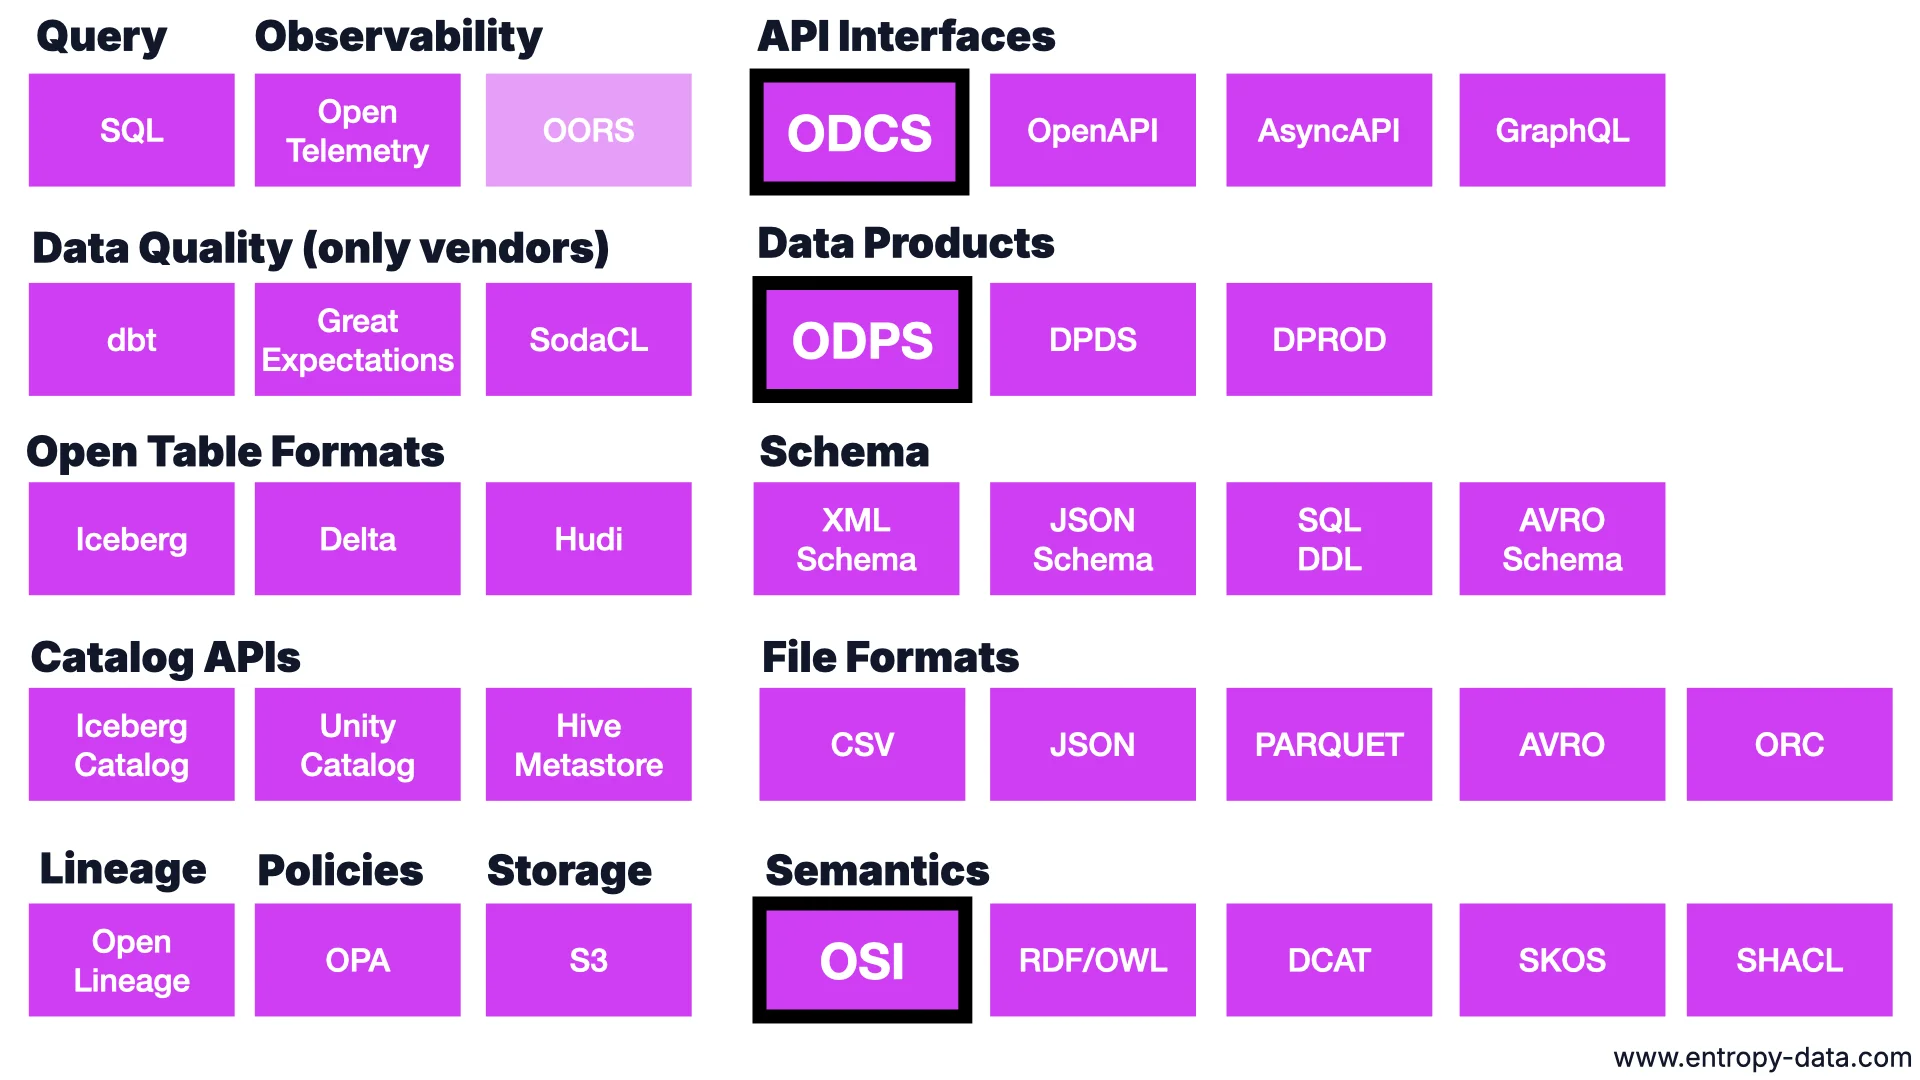
Aujourd’hui, j’ai parlé d’ODCS, d’ODPS et d’OSI, mais la carte est bien plus vaste : interfaces d’API (OpenAPI, AsyncAPI, GraphQL), schémas (XML, JSON, SQL DDL, Avro), formats de fichiers (CSV, JSON, Parquet, Avro, ORC), formats de tables ouverts (Iceberg, Delta, Hudi), API de catalogue (Iceberg Catalog, Unity Catalog, Hive Metastore), data lineage (OpenLineage), politiques (OPA), observabilité (OpenTelemetry, OORS), qualité des données (dbt, Great Expectations, SodaCL) et sémantique (OSI, plus RDF/OWL, DCAT, SKOS, SHACL).
Ce qui rassemble ceux que j’ai mis en avant : ils sont ouverts, ne sont contrôlés par aucune entreprise unique, sont portés par un comité et disposent d’un outillage open source. Un Data Mesh repose sur de nombreux standards, et d’autres arrivent.
La prédiction
Swagger 1.0 est sorti en 2011. Aujourd’hui, OpenAPI est partout : toutes les API REST que vous croisez en ont une. 99 % d’adoption, de facto.
ODCS 3.0, la première version détachée des spécificités de PayPal, la première vraiment utilisable par n’importe quelle entreprise, est sortie en 2025. Je pense que cela ira beaucoup plus vite que pour OpenAPI, parce que le monde va bien plus vite aujourd’hui.
Ma prédiction : ODCS sera partout d’ici quatre ans. Préparez-vous.
Merci
Merci pour l’accueil chaleureux à Louvain, et merci à Tom De Wolf (ACA) et Emma Houben (AE) de m’avoir invité et d’avoir organisé une très belle soirée.
Si vous voulez poursuivre la discussion, vous me trouvez sur LinkedIn, sur simonharrer.com ou à l’adresse simon.harrer@entropy-data.com. Essayez la marketplace de produits de données fondée sur les contrats : www.entropy-data.com. Et si datacontract-cli vous rend service, mettez-lui une étoile sur GitHub.
Q&A
Une sélection de questions posées par le public après la conférence.
Q : Si vous avez de nombreux Data Contracts issus de la même source et que vous devez maintenir et modifier les mêmes contrôles de qualité dans tous, comment faites-vous ?
La meilleure approche consiste à remonter le contrôle de qualité le plus en amont possible, au plus près du système source, pour attraper les erreurs tôt et éviter de rejouer les mêmes contrôles coûteux tout au long du graphe. Si ce n’est pas possible, une réponse est l’IA : avec des agents comme Claude Code, il devient assez peu coûteux de garder des contrôles cohérents entre contrats, et ce n’est pas aussi effronté que ça en a l’air. Au-delà, le motif que nous utilisons habituellement, c’est de relier le contrat à un modèle sémantique. Vous définissez order_id une seule fois, avec sa description, son type et son format (« commence par 053 »), et vous en héritez partout. Bonus : comme deux contrats pointent vers le même concept order_id, l’IA sait que ces tables peuvent être jointes. C’est la même chose, pas simplement quelque chose de similaire.
Q : Quel est le rapport entre OSI et DCAT ?
Aujourd’hui, aucun. DCAT vit dans le monde RDF et du web sémantique, comme vocabulaire de catalogue, inspiré des bibliothèques et des offres de jeux de données. Un groupe de travail d’OSI planche sur l’ajout de sémantique, avec des concepts et des propriétés, c’est-à-dire un graphe encodé en YAML, ce qui rapprochera les deux. Mais je ne crois pas qu’ils s’emboîteront jamais parfaitement. DCAT se compose naturellement en RDF avec d’autres vocabulaires, DPROD de l’OMG par exemple. Les formats YAML comme OSI sont plus stricts. Le choix du format a des conséquences.
Q : Vous avez parlé d’automatiser les transformations à partir du Data Contract. Avez-vous un exemple ? J’avais compris que le contrat ne portait pas la logique de transformation.
C’est exact : le contrat s’adresse au consommateur, pas à l’implémentation. Il porte quelques indices de transformation (d’où vient une colonne, une courte description), mais il reste volontairement limité. Vous pouvez toujours utiliser les propriétés personnalisées d’ODCS pour encoder ce dont vous avez besoin. Ce qui fonctionne très bien en pratique : donner à Claude Code les contrats d’entrée et de sortie, plus une skill du type « voilà comment nous construisons généralement un produit de données sur Databricks », et le laisser combler les trous. Ajoutez des liens sémantiques pointant vers les mêmes concepts d’un contrat à l’autre, et l’IA déduit aussi les jointures. Pour les détails de data lineage à l’exécution, c’est-à-dire le fonctionnement réel de la pipeline, utilisez les traces OpenLineage. C’est cela qui capture le lineage au niveau colonne, pas le contrat.
Articles associés
Open Data Contract Standard (ODCS)
Découvrez l'Open Data Contract Standard (ODCS), une spécification YAML ouverte pour les Data Contracts, gouvernée par Bitol. Structure, schema, qualité des données et exemples.
Open Standards for Data Products
Conférence annotée de Dr. Simon Harrer (Entropy Data) au TDWI München 2026 sur les standards ouverts des produits de données (ODCS, ODPS et OSI), l'outillage open source qui les accompagne et une démo live d'un agent de code qui construit un produit de données à partir d'un Data Contract.
Qu'est-ce qu'un produit de données ?
Un produit de données est une unité logique qui regroupe tous les composants nécessaires pour traiter et stocker les données d'un domaine métier, au service de cas d'usage analytiques, et les met à disposition des autres équipes via des Output Ports.