Charla · data2day 2026
Agentic Analytics: From Hype to Real Value
Fabian Biberger (Founding Engineer, Entropy Data) ·
La charla de Fabian Biberger en data2day 2026, en Colonia, impartida en alemán con el título Agentic Analytics: Wie aus Hype echter Mehrwert wird. Recorre el camino de Entropy Data: de un servidor MCP a un chatbot con gobernanza, qué contexto necesita un agente para trabajar de forma fiable sobre los datos, y Apache Ossie para ontologías y modelos semánticos.
Un resumen editado de la charla, traducido del alemán.
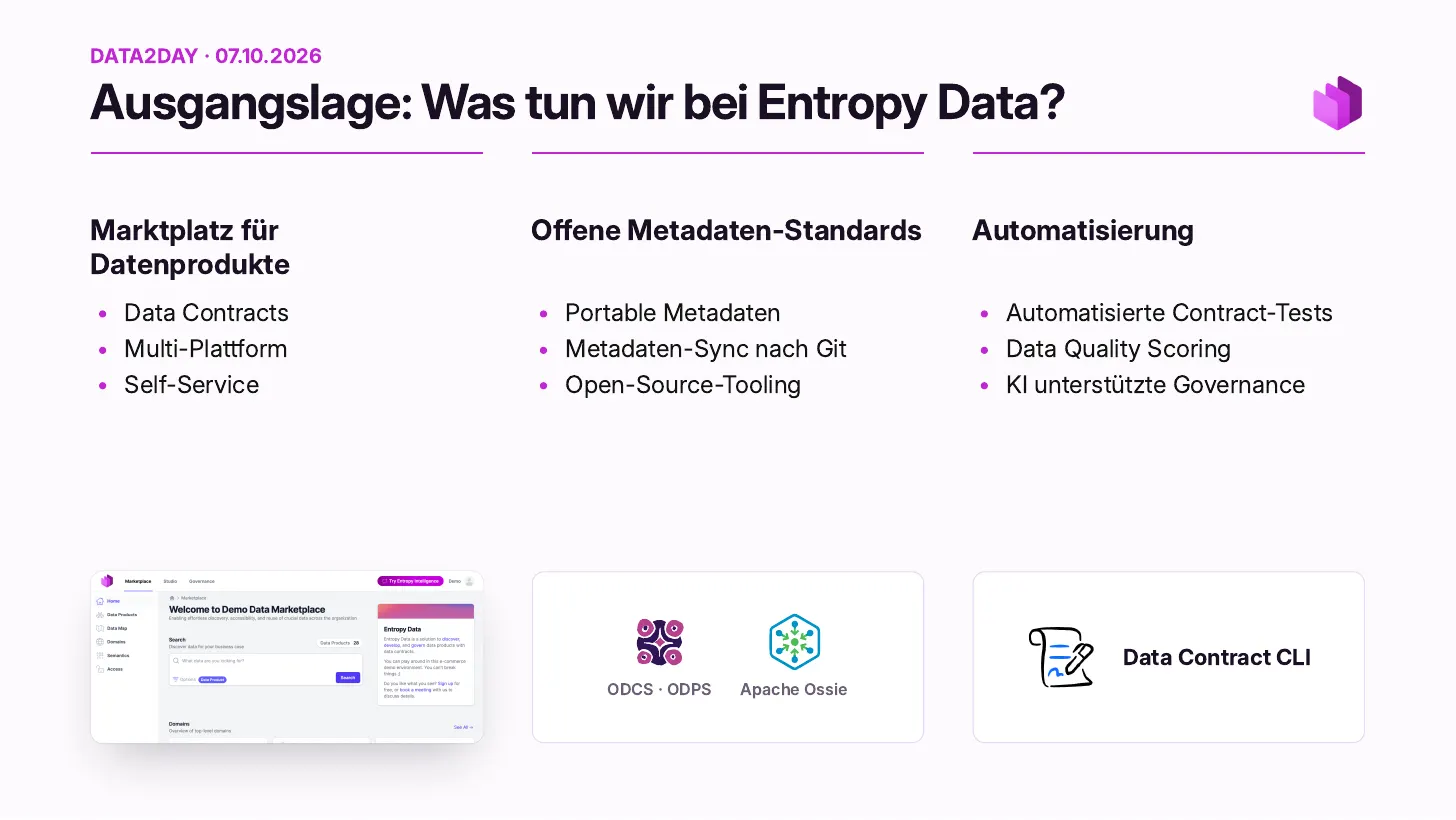
El punto de partida de Entropy Data
- Un marketplace de productos de datos con Data Contracts, multiplataforma y self-service.
- Estándares abiertos: ODCS, ODPS y Apache Ossie.
- Automatización: pruebas de contrato con la Data Contract CLI, scoring de calidad de datos, gobernanza asistida por IA.
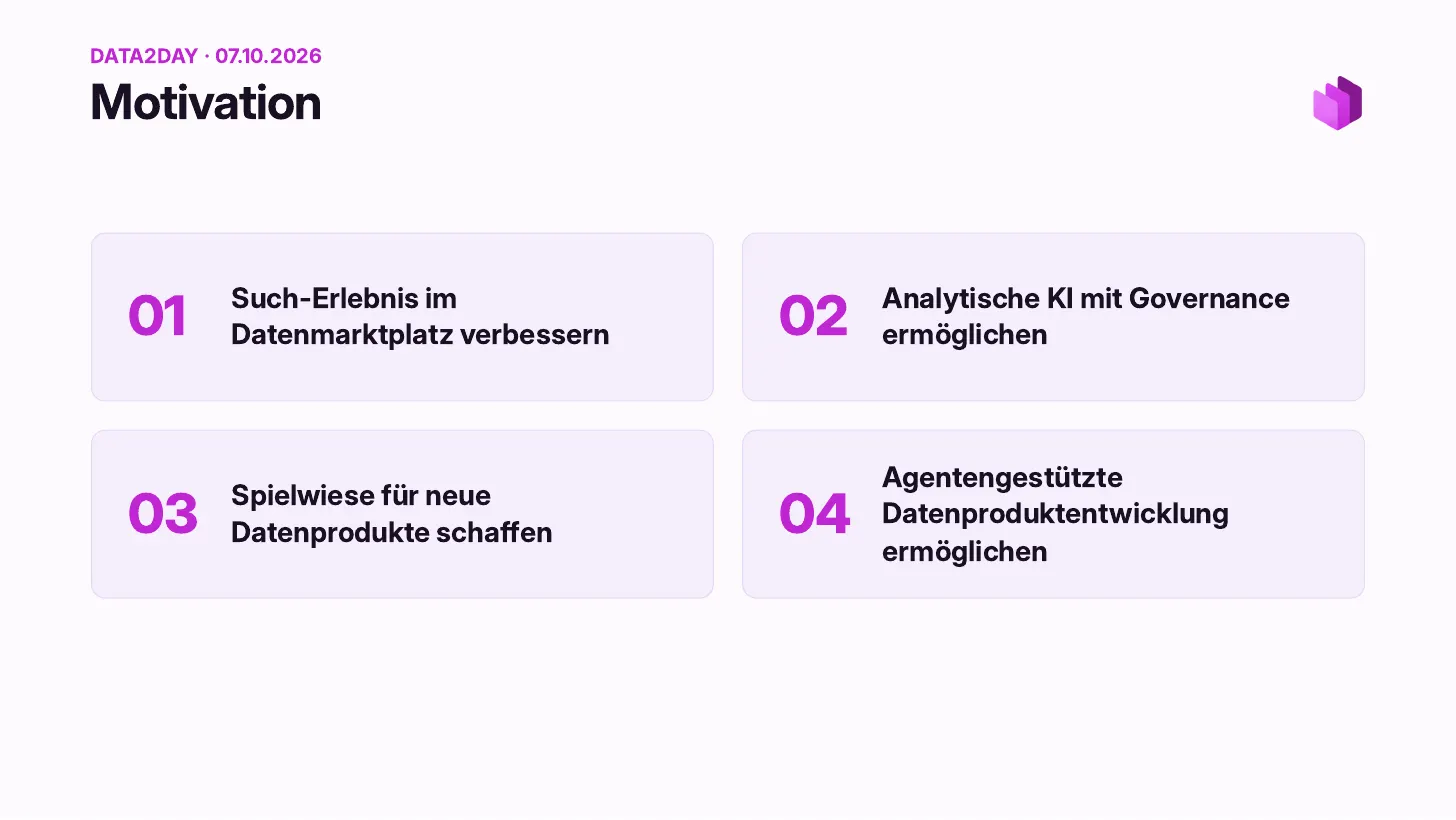
Cuatro razones para ir a lo agéntico
- Mejor búsqueda en el marketplace de datos.
- IA analítica con gobernanza.
- Un entorno de pruebas para nuevos productos de datos.
- Desarrollo de productos de datos asistido por agentes.
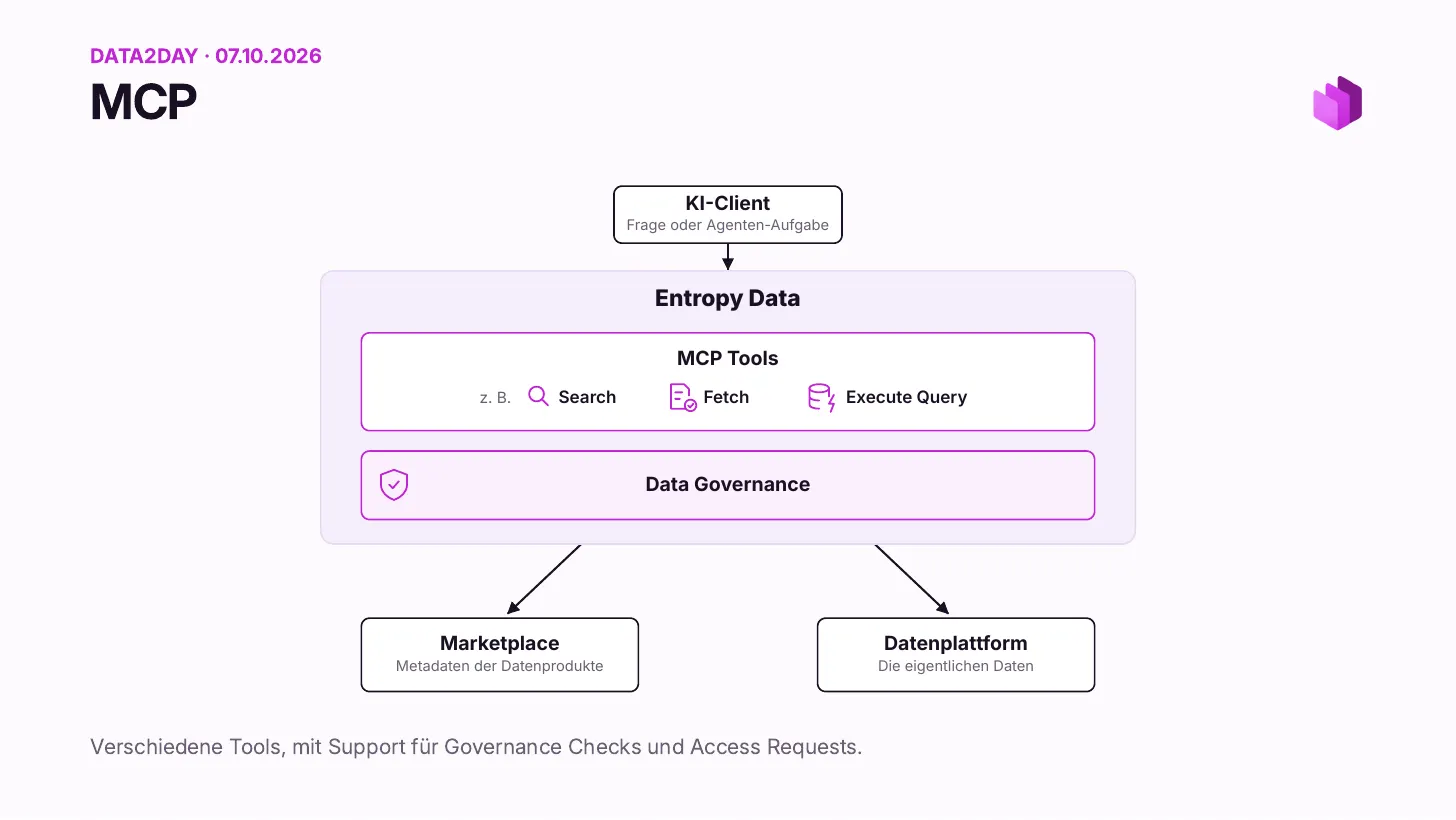
Primer paso: un servidor MCP
- Los clientes de IA como Claude o ChatGPT se conectan al marketplace mediante MCP.
- Herramientas: buscar productos de datos, recuperar Data Contracts, ejecutar consultas.
- Entre medias están las comprobaciones de gobernanza y las solicitudes de acceso.
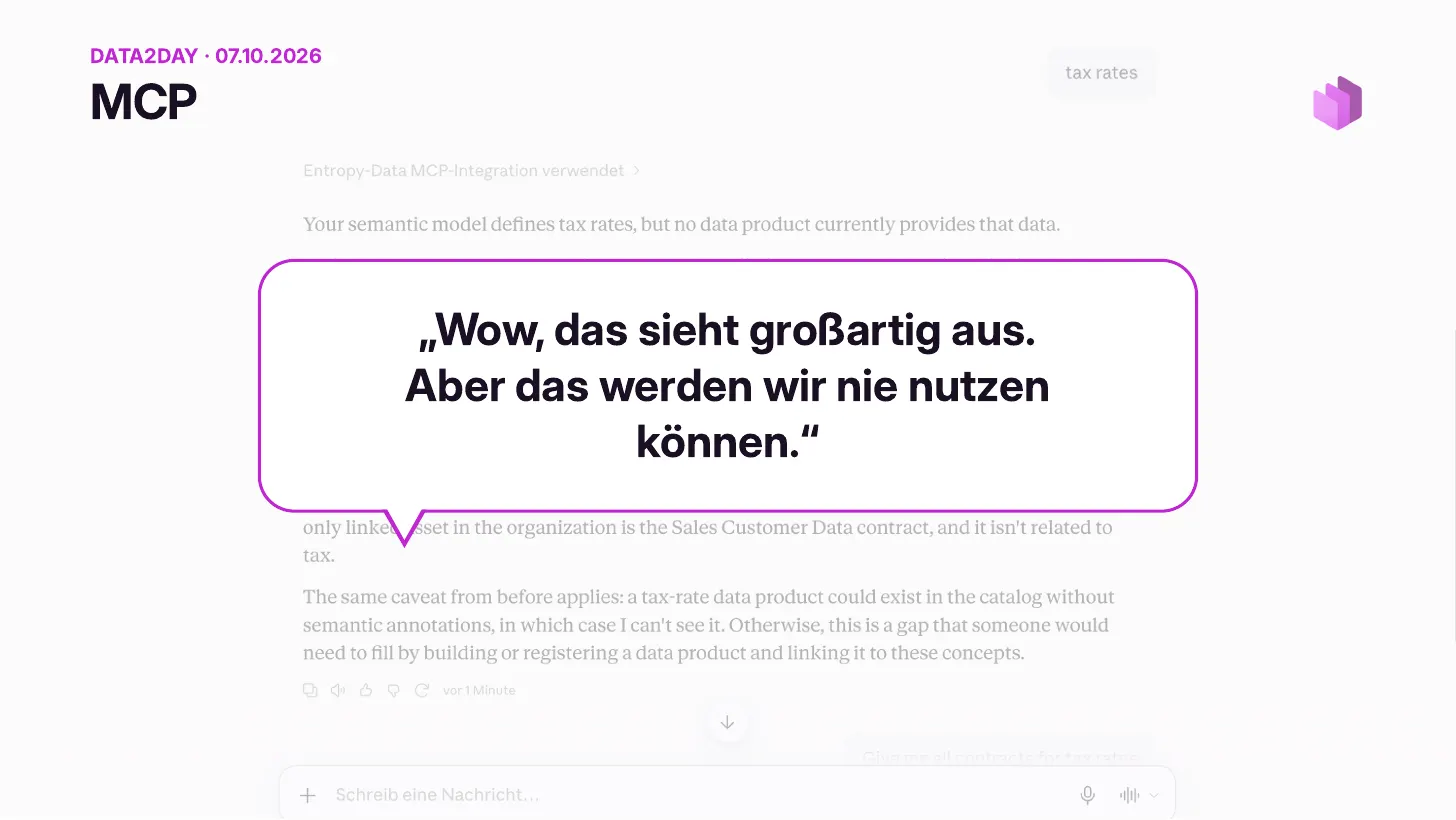
«Qué buena pinta. Pero nunca podremos usarlo.»
- Gobernanza: MCP reúne los datos en un equipo personal, fuera de la gobernanza.
- Disponibilidad: muchas empresas no tienen ningún cliente de chat aprobado, o solo Copilot.
- Decisión: construir nuestro propio chatbot.
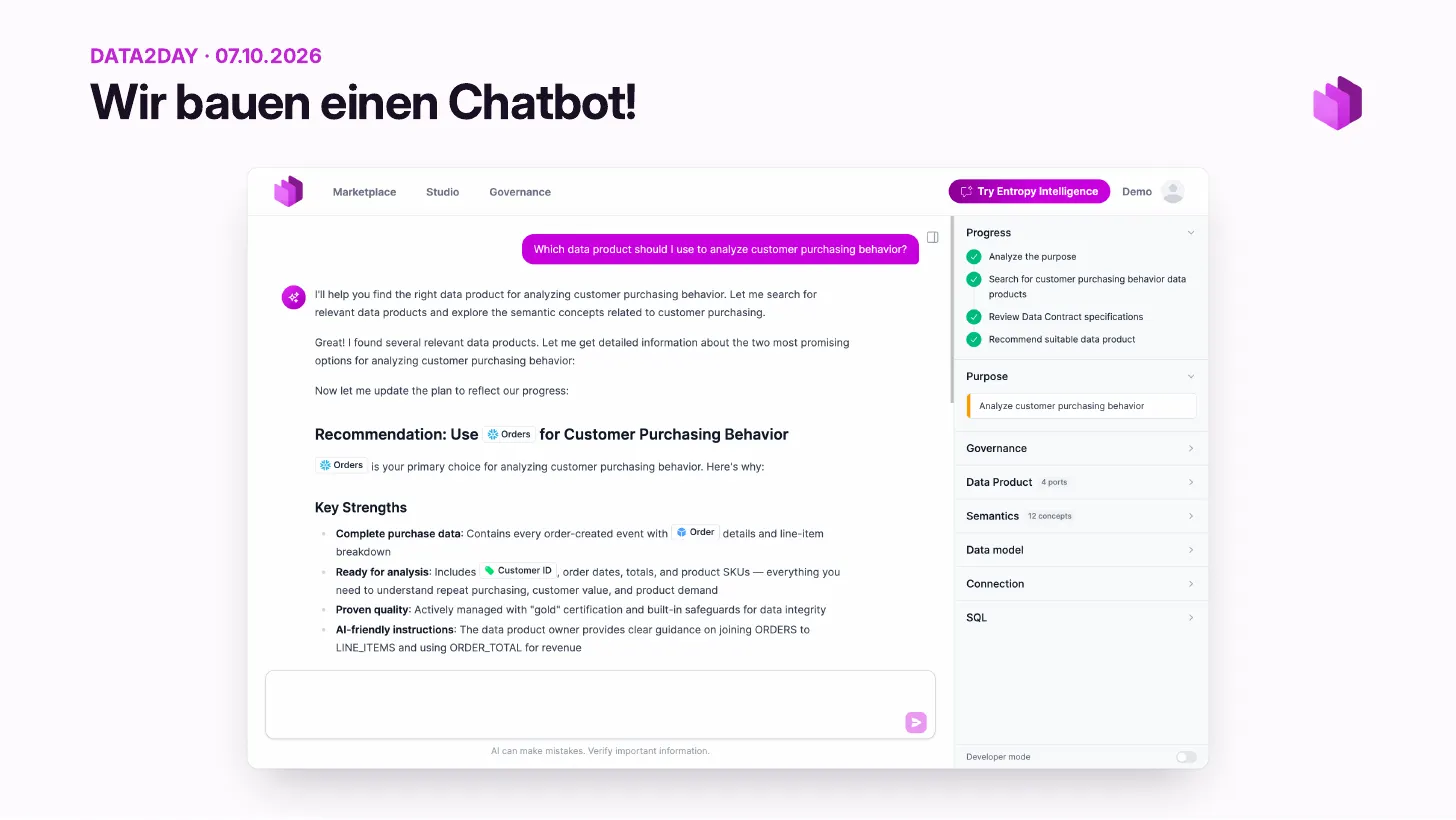
Así que construimos un chatbot
- Entropy Intelligence vive dentro del marketplace, bajo la gobernanza existente.
- El system prompt se ajusta a los casos de uso de Entropy Data.
- Las herramientas MCP están integradas directamente y la gobernanza no se puede eludir.
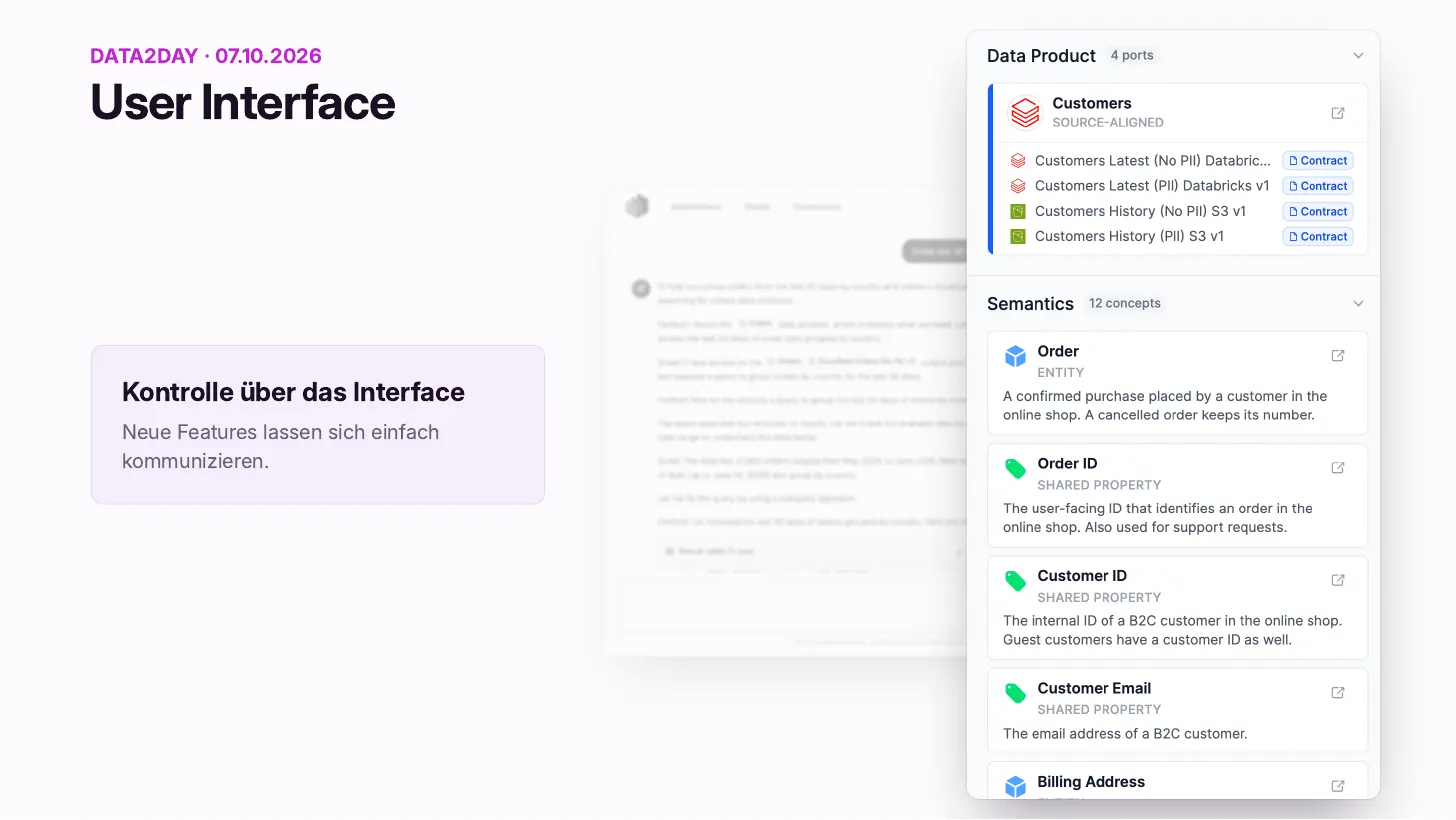
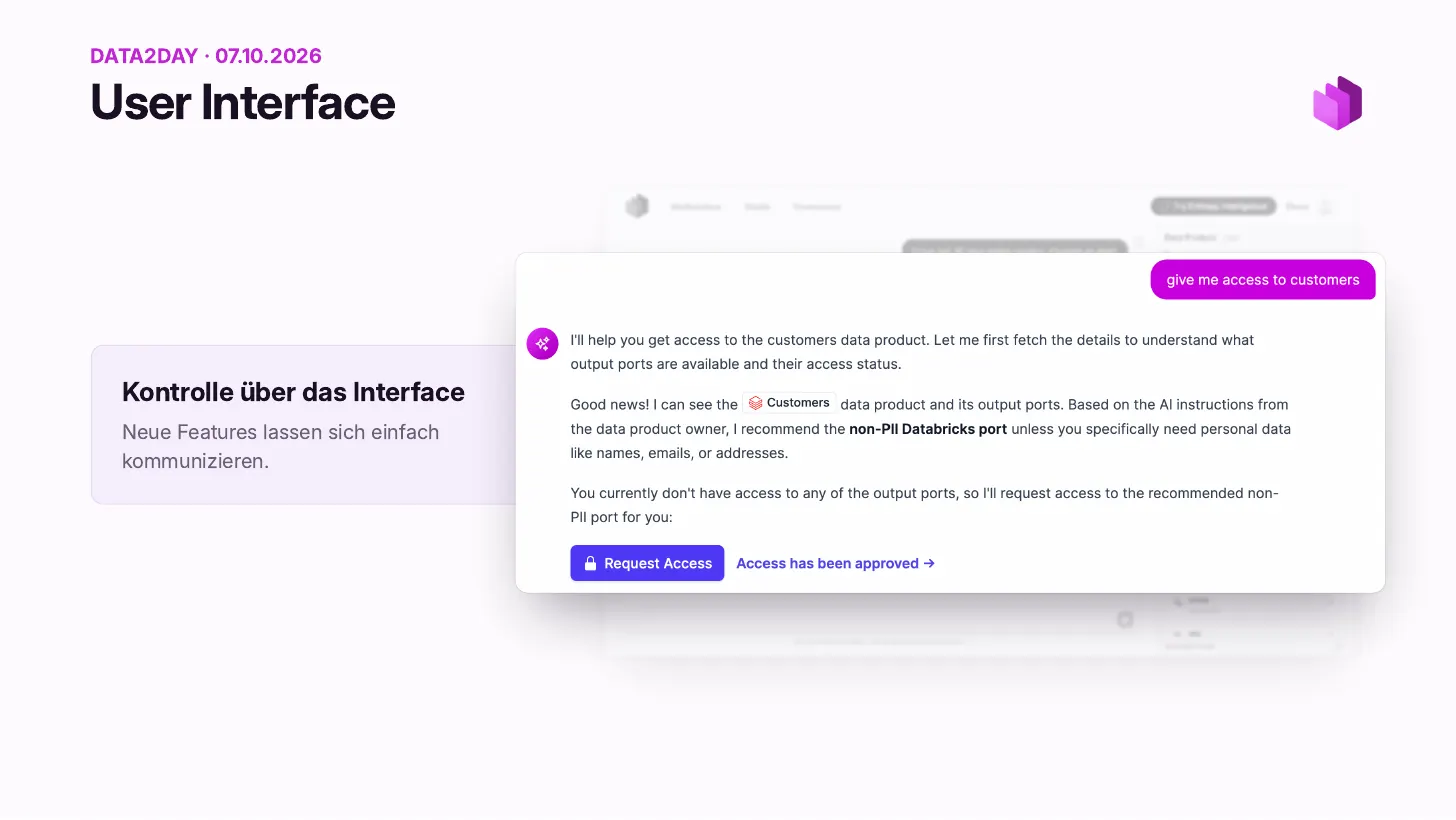
«Neue Features lassen sich einfach kommunizieren»: cuando controlas la interfaz, las nuevas funcionalidades son fáciles de comunicar.
Interfaz de usuario
- Mejor trazabilidad gracias al panel de contexto: producto de datos, Output Ports, conceptos semánticos y finalidad de un vistazo.
- Nuevas funcionalidades integradas directamente, por ejemplo un botón Request Access en plena conversación.
- Elementos de interfaz reutilizados, como los chips y los iconos del marketplace, ayudan a los usuarios a orientarse.
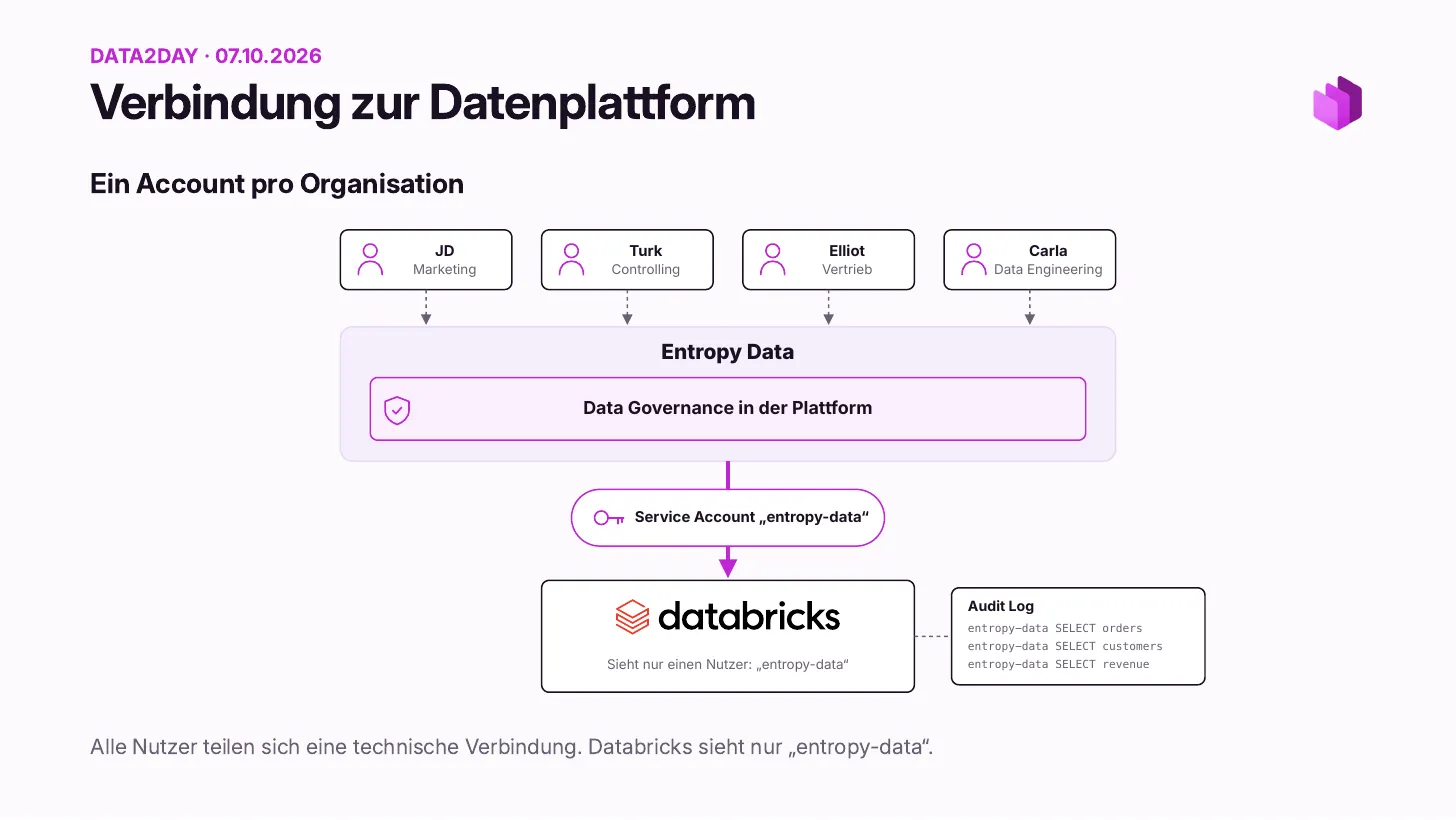
¿Quién consulta realmente los datos?
- Una sola cuenta de servicio para toda la organización.
- Databricks solo ve un usuario:
entropy-data. - El registro de auditoría ya no muestra quién accedió a qué.
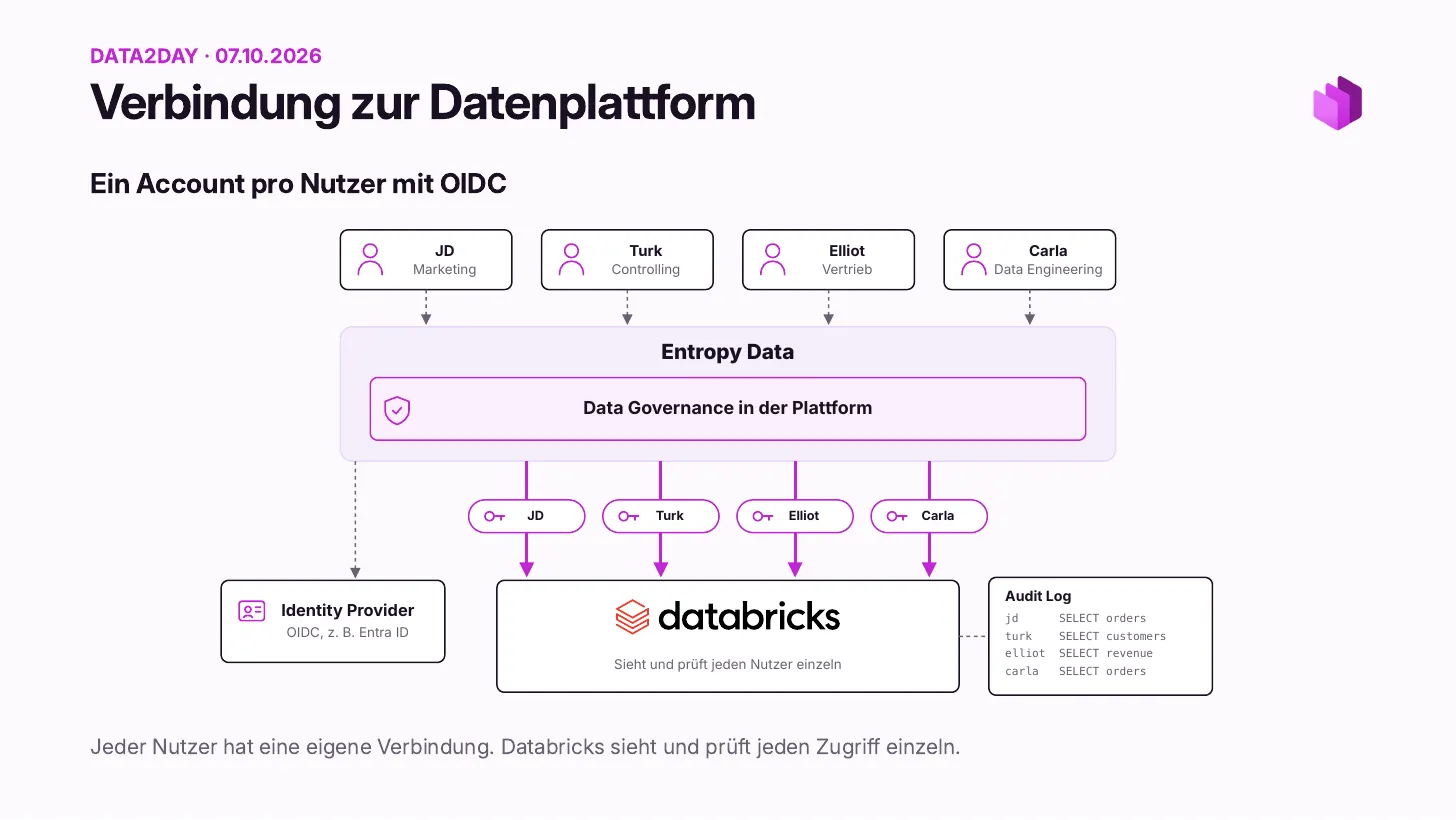
- OIDC: el proveedor de identidad, por ejemplo Entra ID, traslada cada identidad a la plataforma.
- Databricks comprueba cada acceso de forma individual y el registro de auditoría vuelve a ser útil.
- Principio: decide primero bajo qué identidad se ejecuta el acceso a los datos.
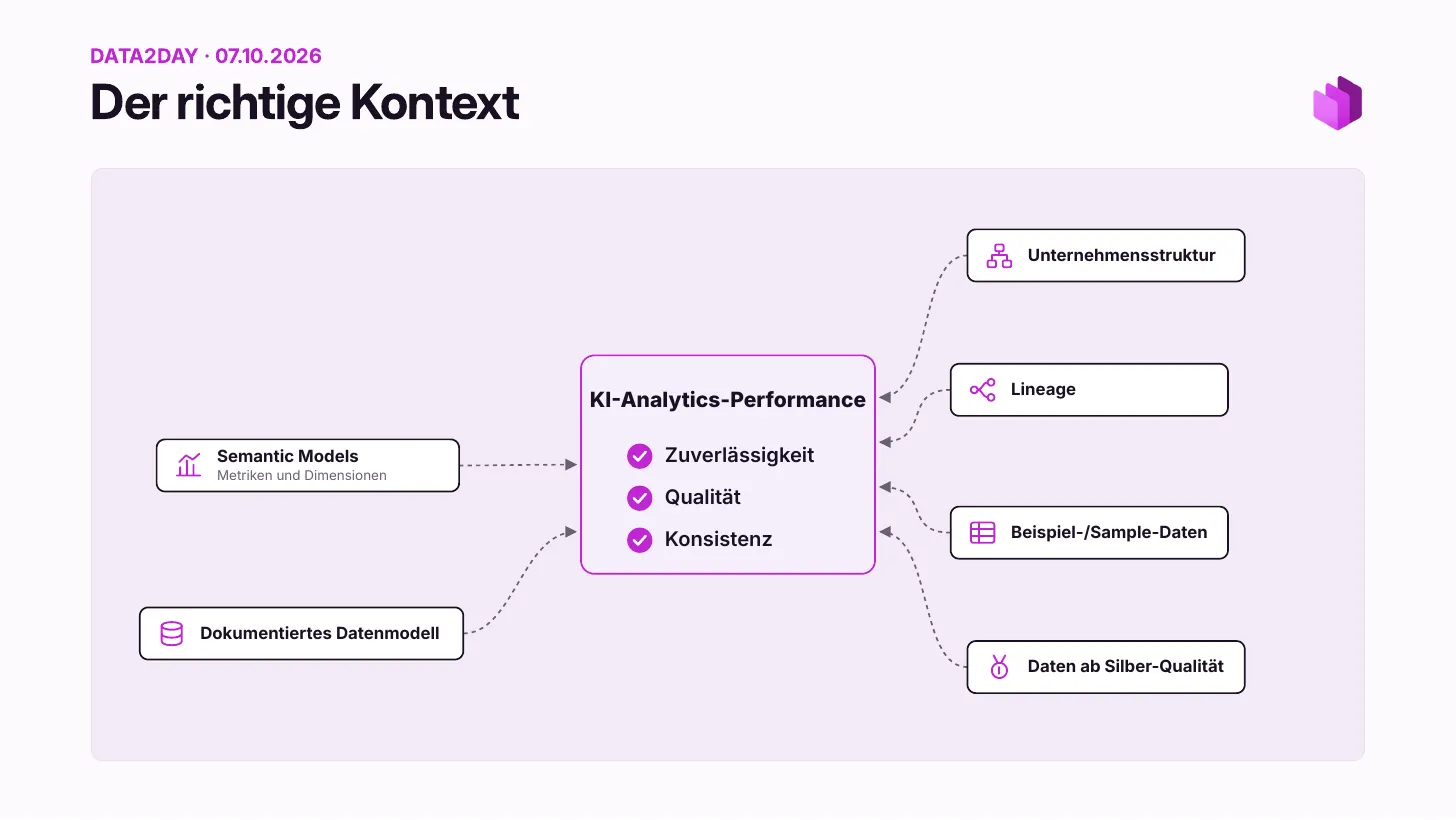
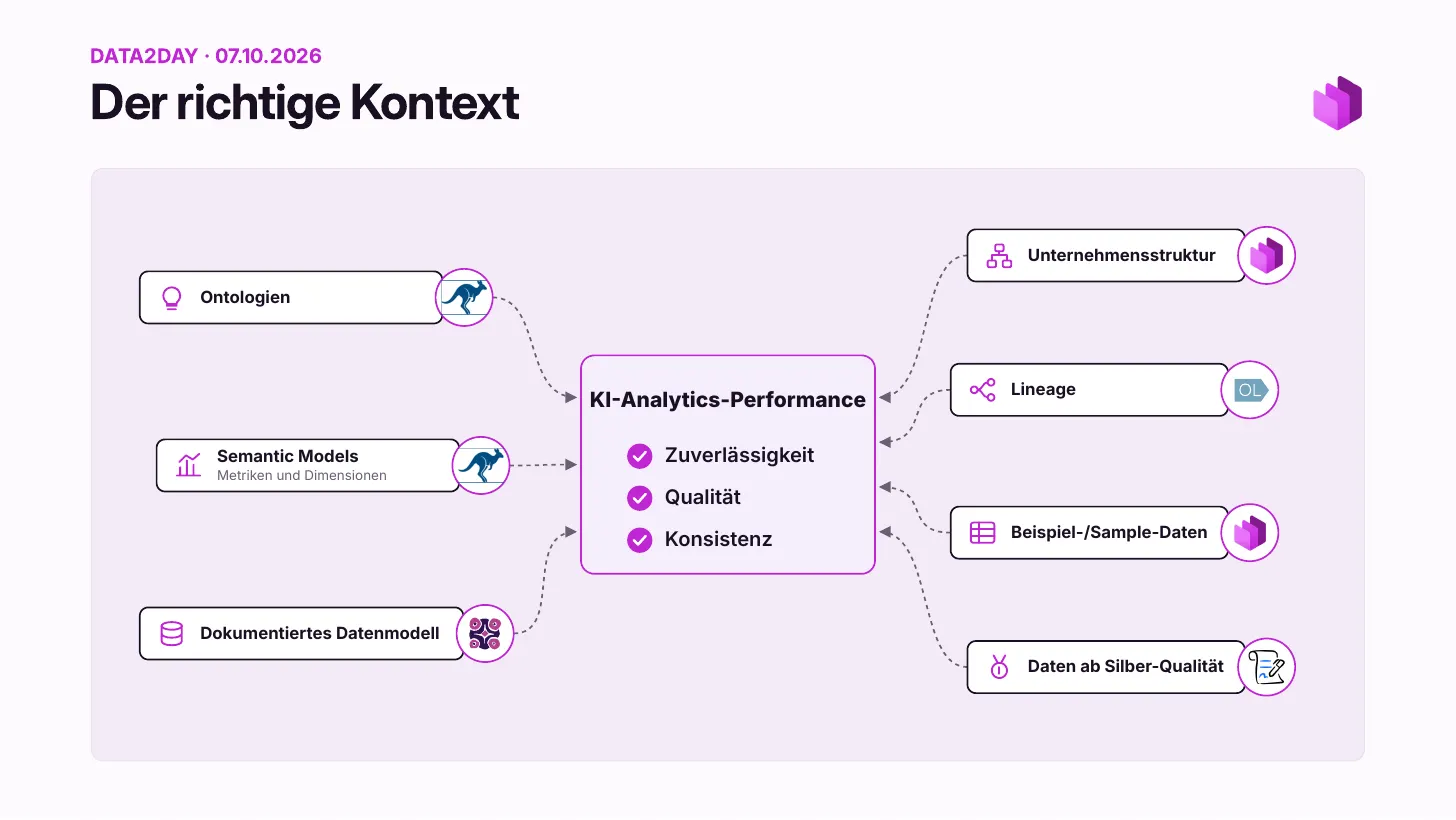
El contexto adecuado: siete factores
- Lo básico: datos con calidad silver como mínimo y un modelo de datos documentado.
- Los aceleradores: estructura de la empresa, data lineage y datos de ejemplo.
- La semántica: modelos semánticos (métricas, dimensiones) y ontologías (conceptos compartidos).
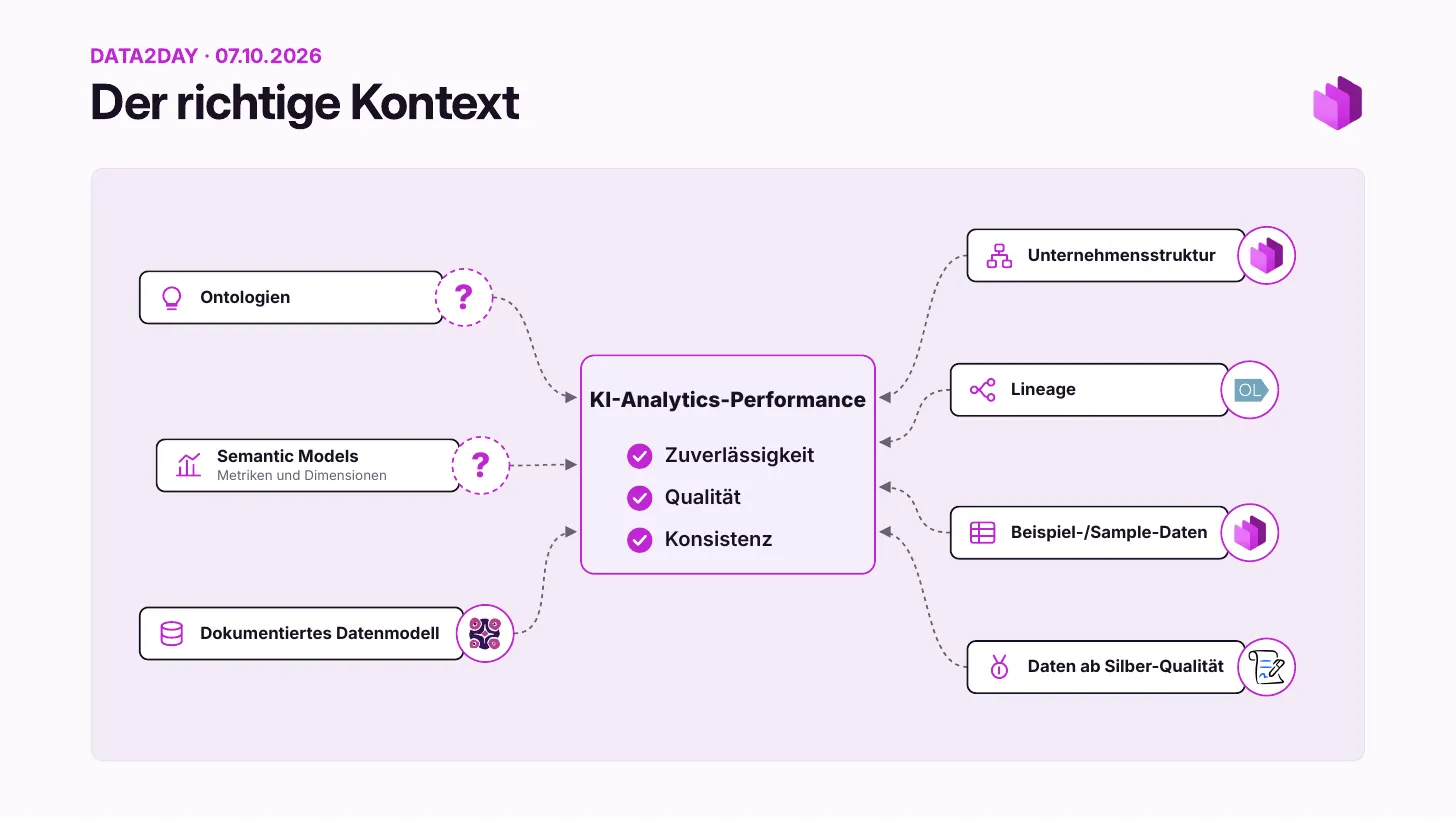
Cinco cubiertos, dos pendientes
- Modelo de datos y calidad silver: cubiertos por los Data Contracts y las pruebas de contrato.
- Data lineage mediante los enlaces entre productos de datos y OpenLineage, datos de ejemplo en parte dentro de los Data Contracts, estructura de la empresa como equipos y dominios.
- Todavía pendiente: los modelos semánticos y las ontologías.
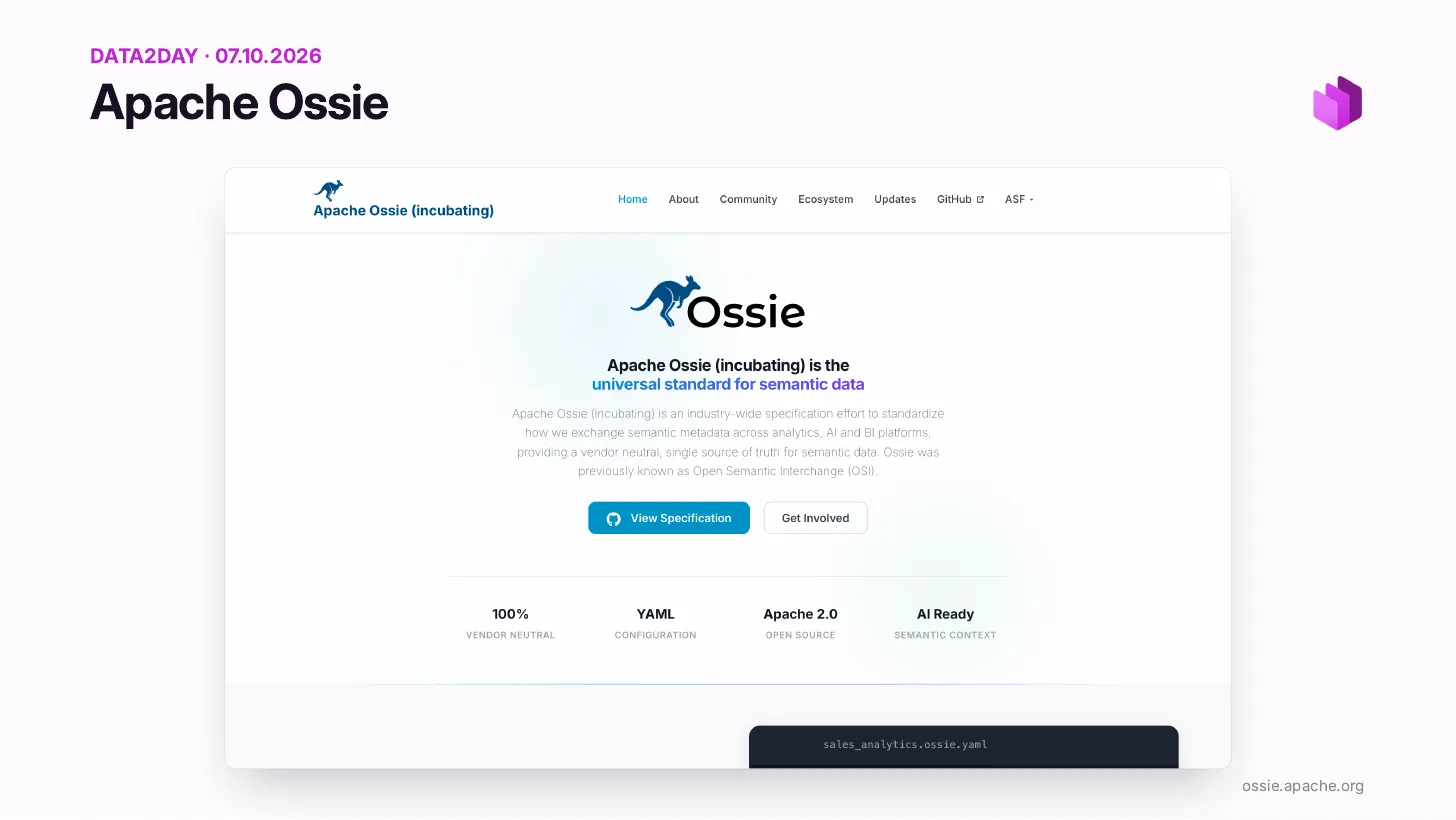
Apache Ossie
- Antes Open Semantic Interchange (OSI), ahora Apache Ossie.
- Un proyecto Apache en incubación para modelos semánticos y ontologías.
- Entropy Data lo soporta como formato para la semántica.
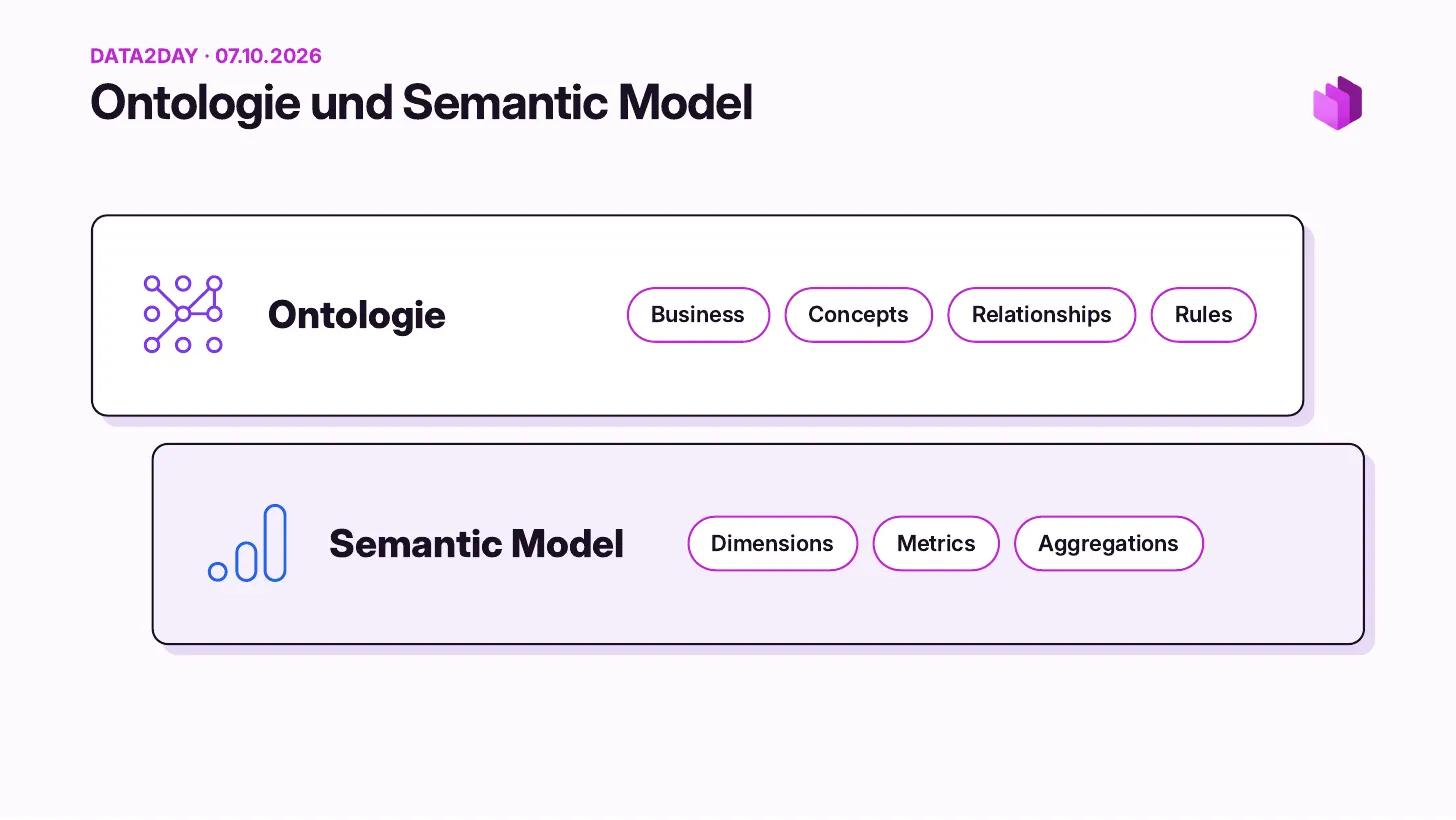
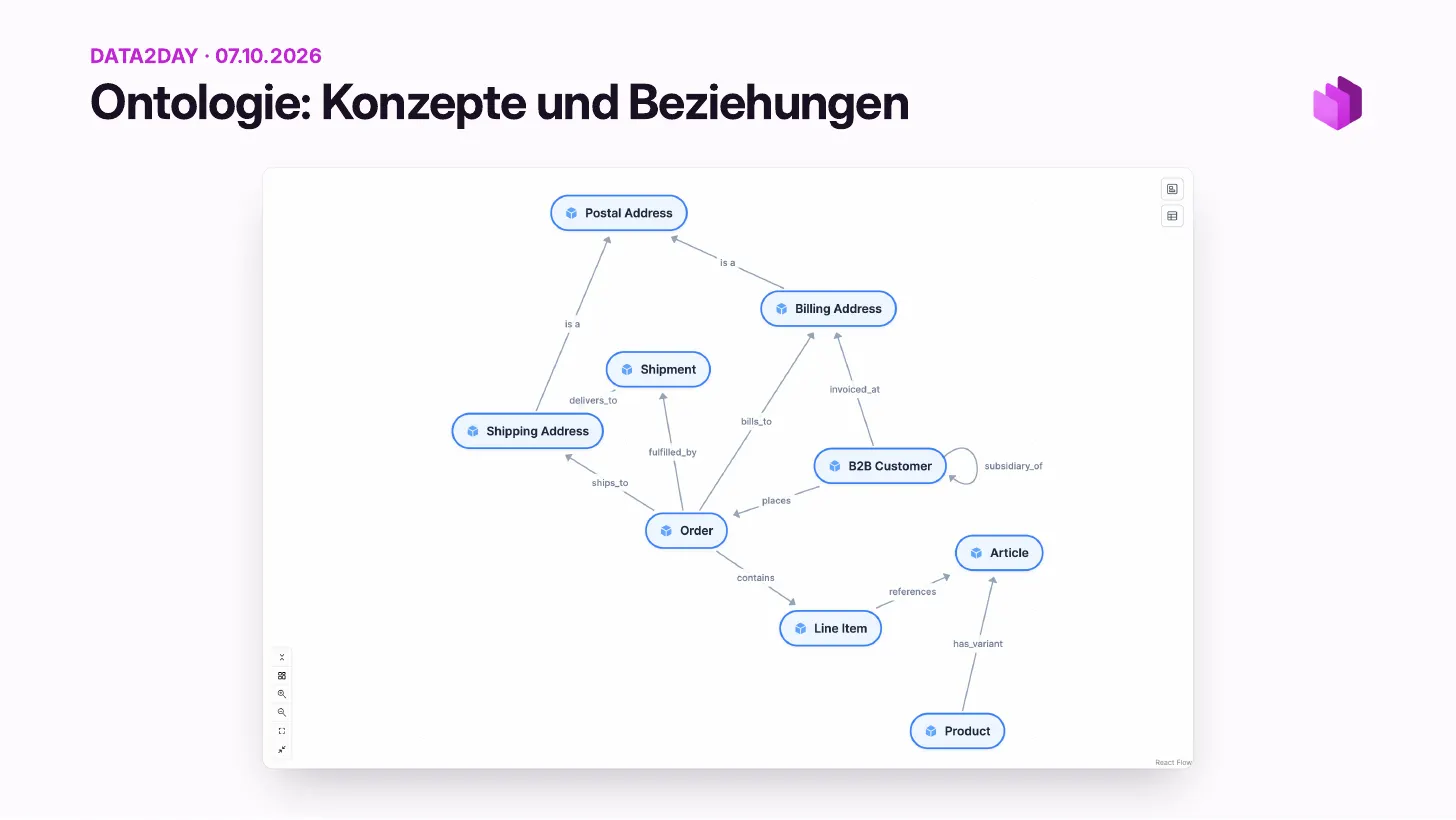
Ontología y modelo semántico
- Ontología: conceptos como Order, con sus propiedades.
- Las relaciones aportan significado: un pedido ships to una dirección de envío.
- Más significado significa más contexto para el agente.
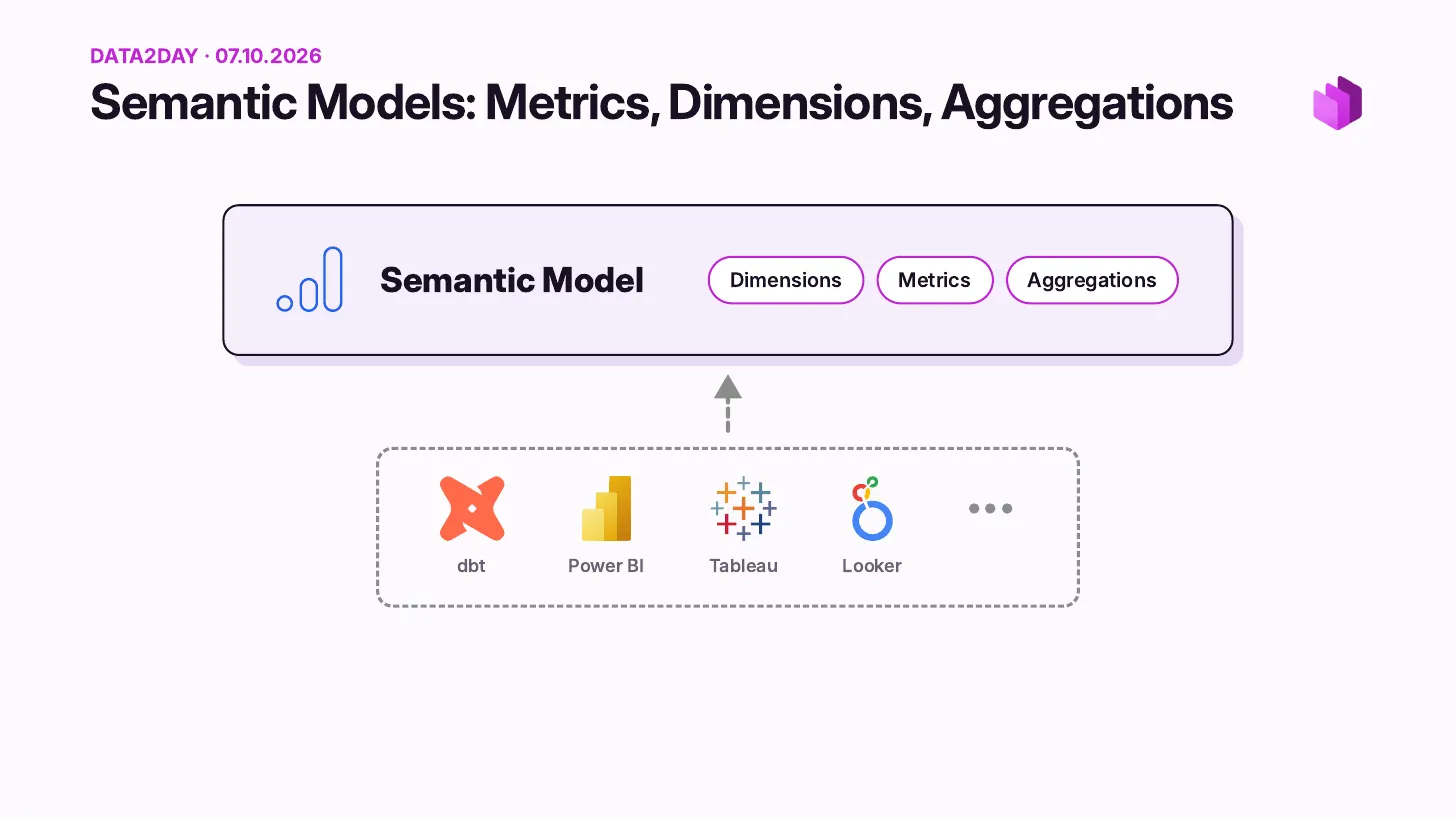
- Modelo semántico: métricas, dimensiones y agregaciones sobre los datos.
- Conocido de dbt MetricFlow, Power BI, Tableau y Looker.
- La lógica de cálculo, como el valor del pedido, se define en un solo lugar.
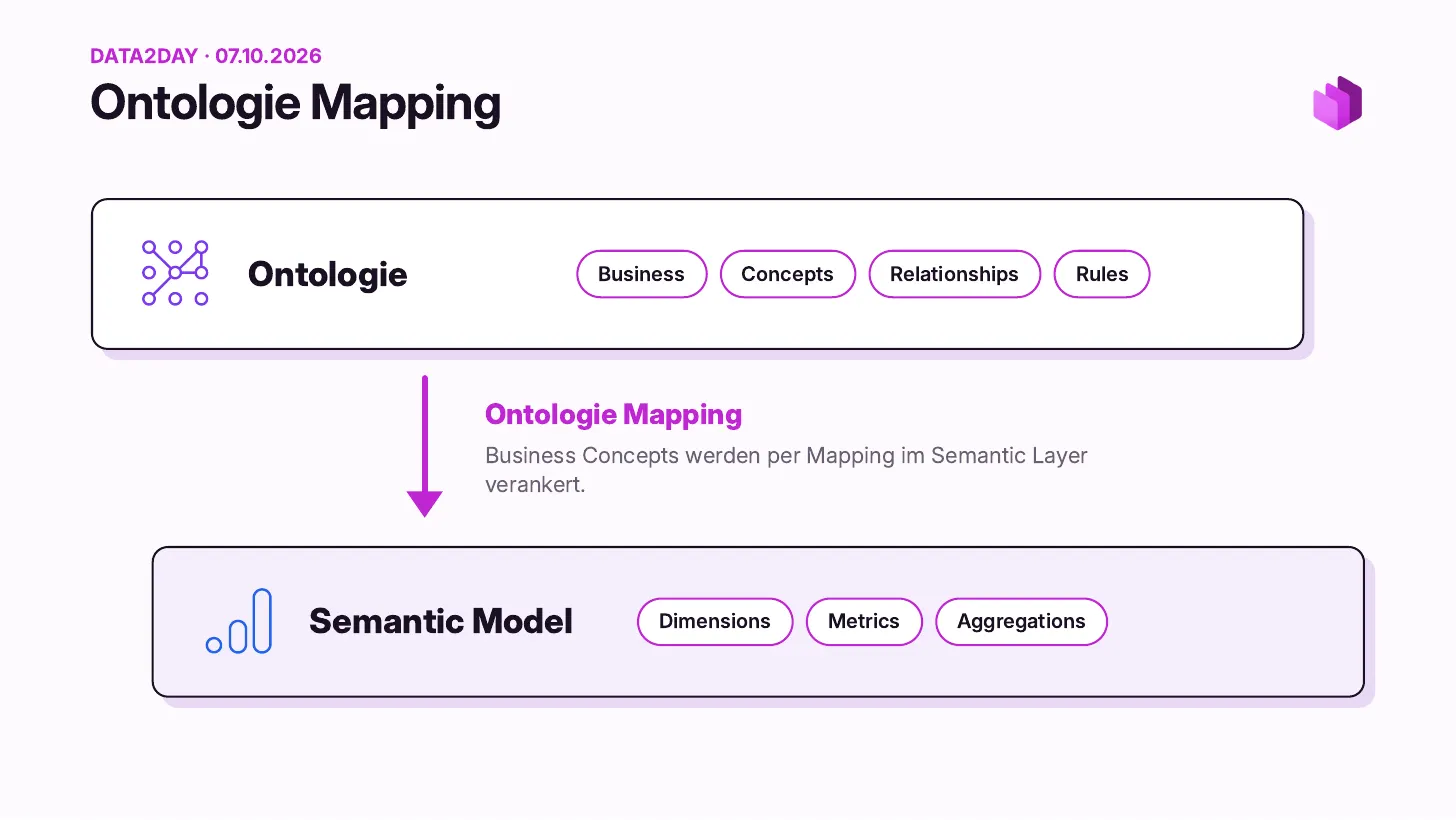
- Ossie ancla la ontología en los modelos semánticos.
- Una capa de mapeo vincula cada concepto con el lugar donde aparece.
- Con ese vínculo, el agente construye mejores consultas.
Por dónde empezar
- Empieza por lo básico: un modelo de datos documentado y datos con calidad silver.
- La estructura de la empresa, el data lineage y los datos de ejemplo llegan como refuerzo.
- Los modelos semánticos y las ontologías aportan mejores resultados y más trazabilidad.
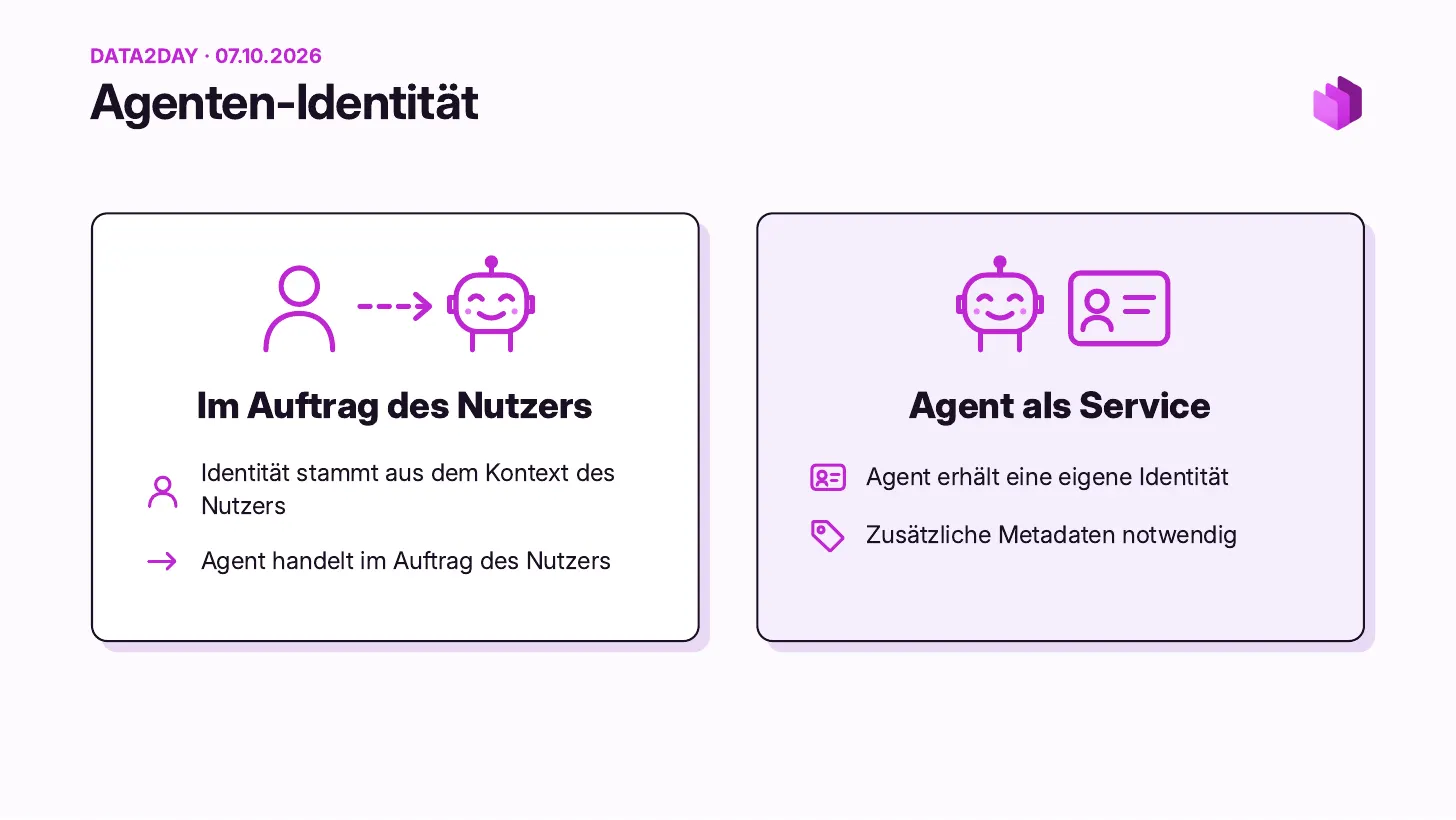
Los agentes están llegando
- Los agentes autónomos también necesitan una identidad.
- On behalf of the user: la identidad viene del usuario, como hoy en el chatbot.
- Agent as a service: una identidad propia, más metadatos como el operador.
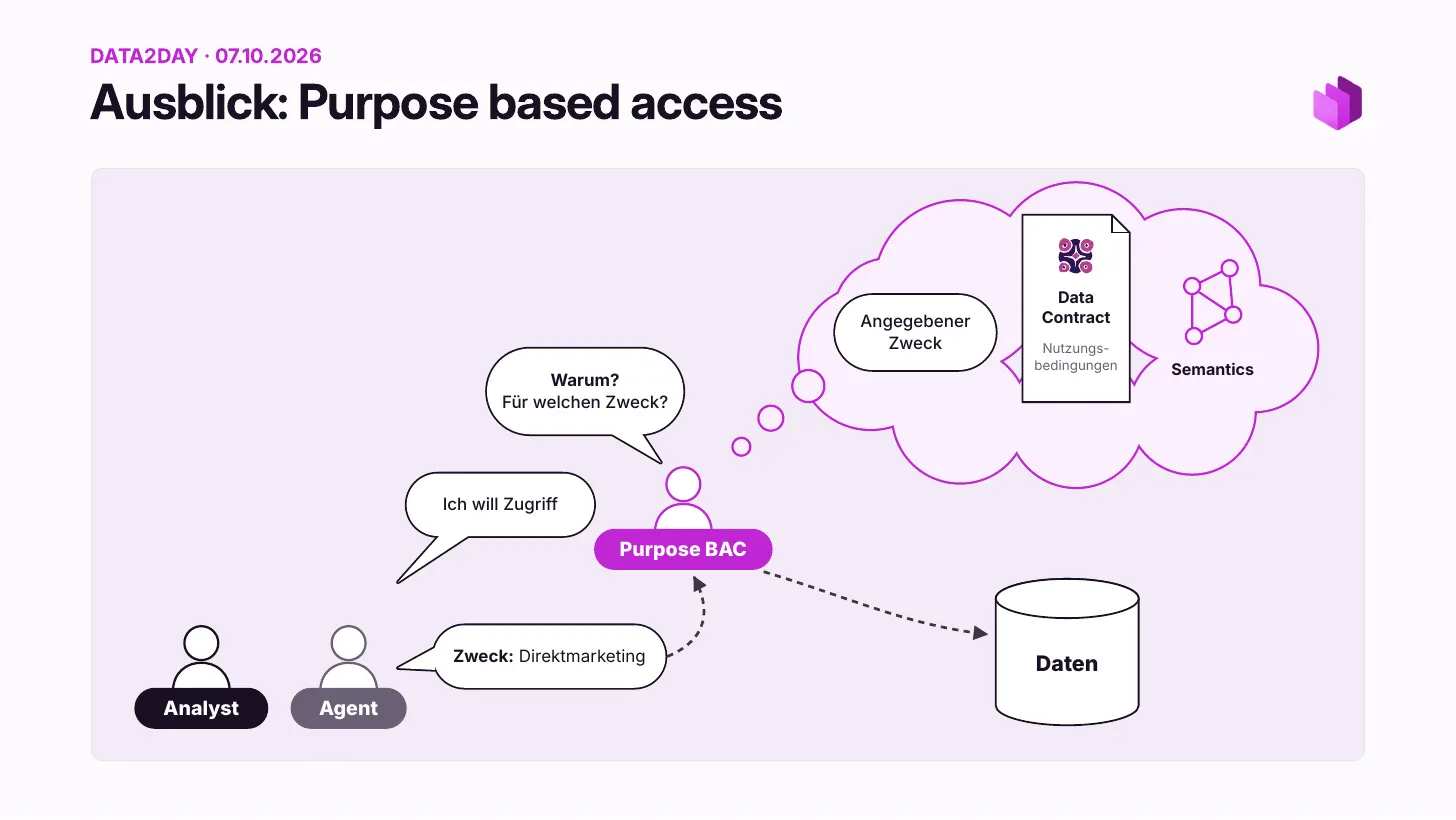
Perspectiva: Purpose-based Access
- Los analistas y los agentes deben indicar para qué necesitan los datos.
- La finalidad se comprueba contra las condiciones de uso del Data Contract y la semántica.
- Una idea surgida del turno de preguntas: limitar el acceso en el tiempo, por ejemplo a la sesión del agente.
Pruébalo tú mismo
- Lanza la demo de 1 clic en demo.entropy-data.com.
- Descubre Apache Ossie y MCP.
- Prueba tus Data Contracts con la Data Contract CLI.
Artículos relacionados
A Data Marketplace is What Your Agent Needs
Por qué los agentes de IA necesitan un marketplace de datos, para leer datos con herramientas gobernadas y para construir nuevos productos de datos, con dos demos en vivo.
¿Qué es Apache Ossie?
El estándar abierto para ontologías y modelos semánticos, antes conocido como Open Semantic Interchange.
¿Qué es Purpose-based Access Control?
Los agentes de IA deciden en tiempo de ejecución qué datos necesitan. Purpose-based Access Control comprueba cada consulta contra las condiciones de uso del Data Contract.