Conférence · data2day 2026
Agentic Analytics: From Hype to Real Value
Fabian Biberger (Founding Engineer, Entropy Data) ·
La conférence de Fabian Biberger à data2day 2026 à Cologne, donnée en allemand sous le titre Agentic Analytics: Wie aus Hype echter Mehrwert wird. Elle retrace le parcours d’Entropy Data : d’un serveur MCP à un chatbot gouverné, le contexte dont un agent a besoin pour travailler de façon fiable sur les données, et Apache Ossie pour les ontologies et les modèles sémantiques.
Un résumé remanié de la conférence, traduit de l’allemand.
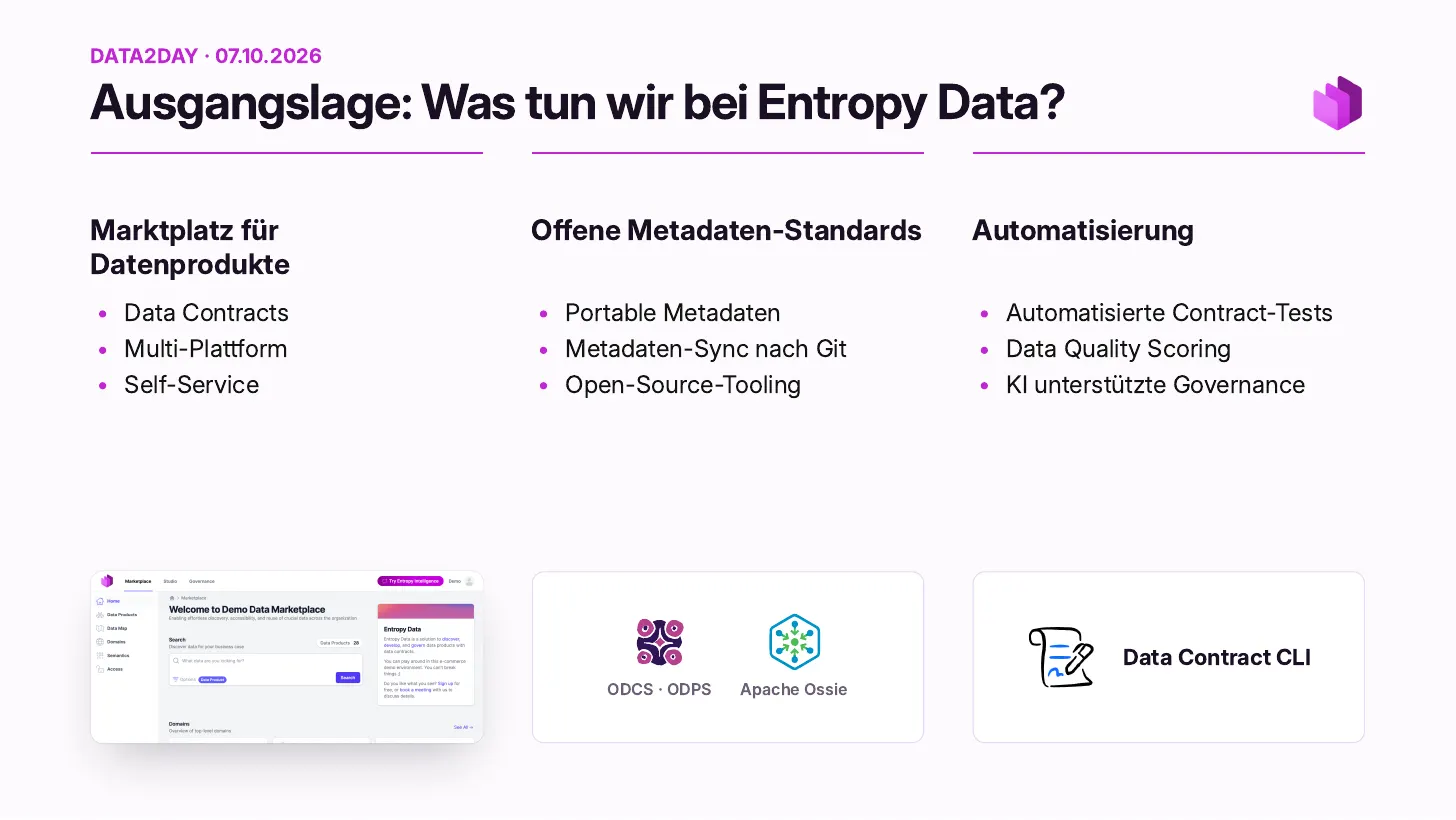
Le point de départ d’Entropy Data
- Une marketplace de produits de données avec des Data Contracts, multi-plateforme et en self-service.
- Des standards ouverts : ODCS, ODPS et Apache Ossie.
- De l’automatisation : tests de contrat avec la Data Contract CLI, scoring de la qualité des données, gouvernance assistée par IA.
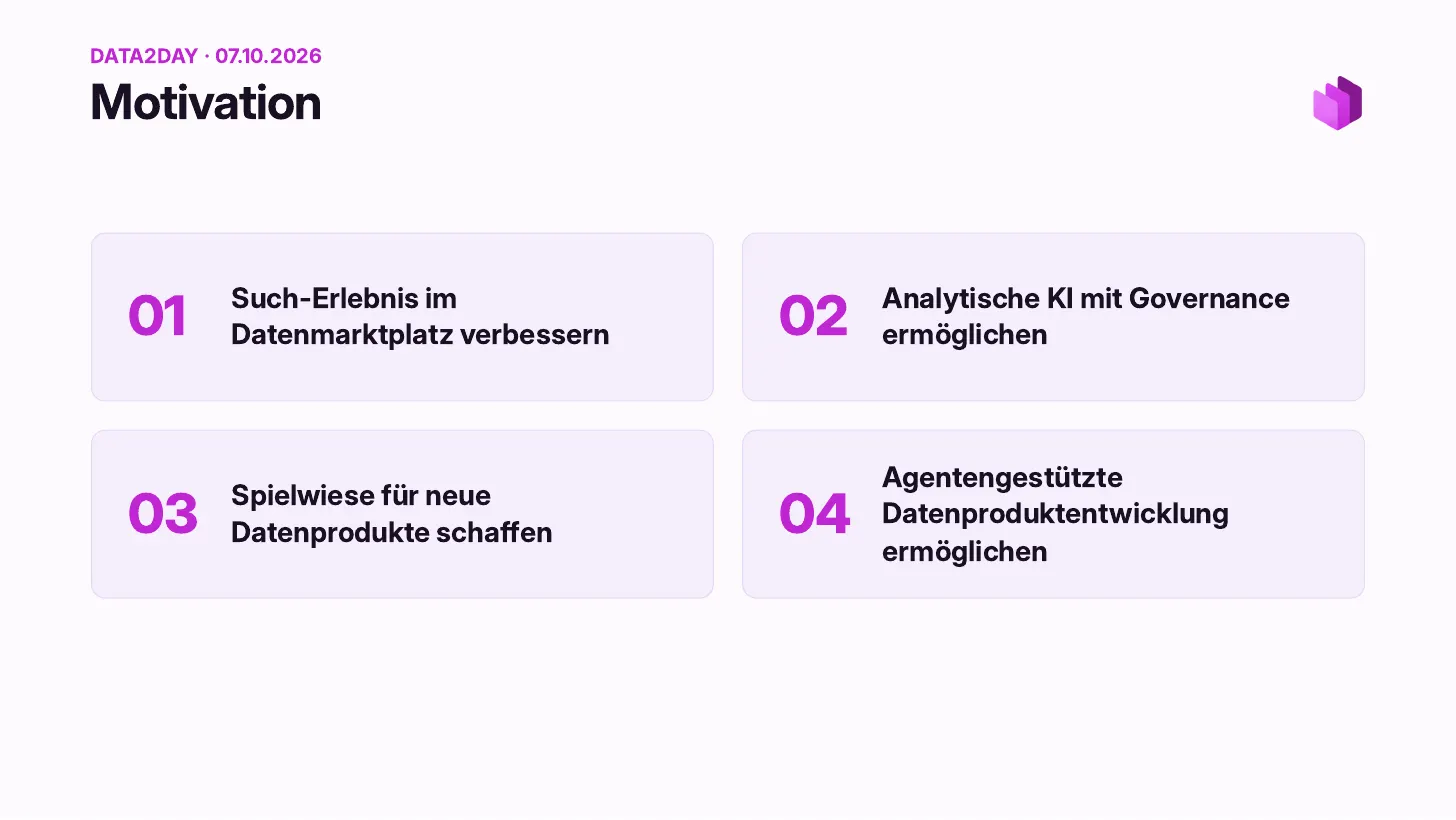
Quatre raisons de passer à l’agentique
- Une meilleure recherche dans la marketplace de données.
- Une IA analytique gouvernée.
- Un bac à sable pour de nouveaux produits de données.
- Un développement de produits de données assisté par agents.
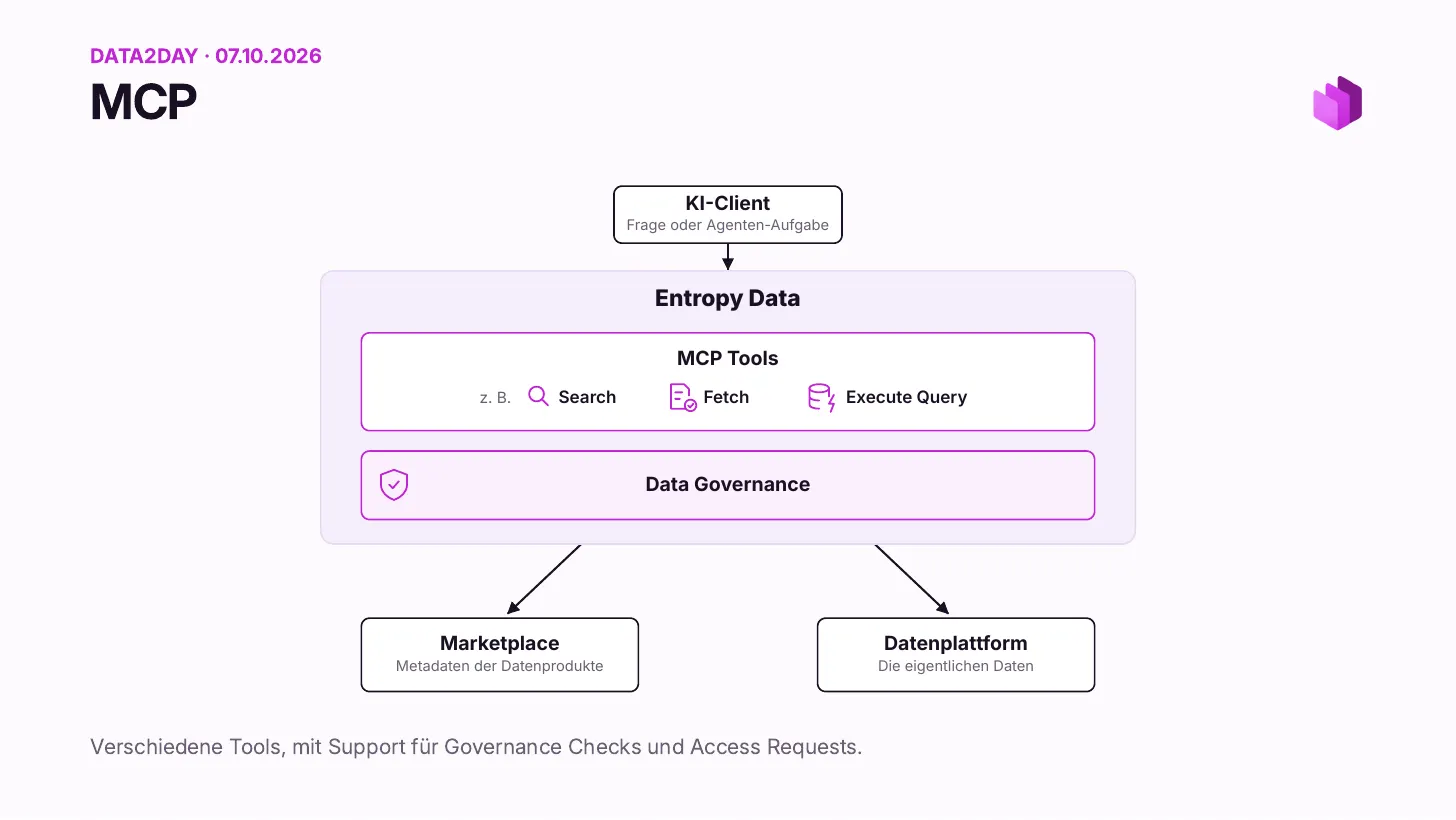
Première étape : un serveur MCP
- Les clients IA comme Claude ou ChatGPT se connectent à la marketplace via MCP.
- Des outils : chercher des produits de données, récupérer des Data Contracts, exécuter des requêtes.
- Les contrôles de gouvernance et les demandes d’accès s’intercalent.
« Superbe. Mais nous ne pourrons jamais l’utiliser. »
- Gouvernance : MCP rassemble les données sur un poste personnel, hors gouvernance.
- Disponibilité : beaucoup d’entreprises n’ont aucun client de chat validé, ou seulement Copilot.
- Décision : construire notre propre chatbot.
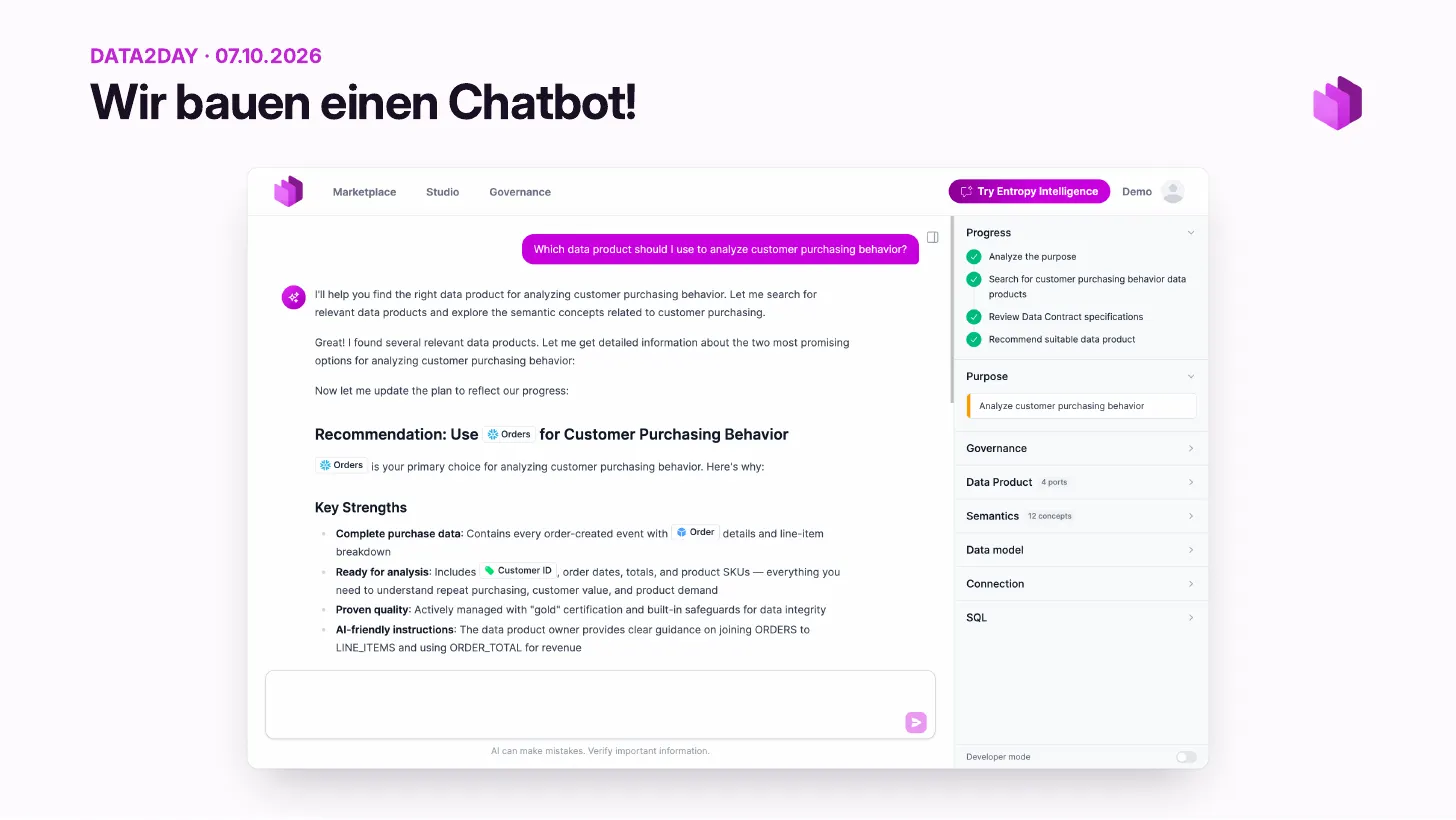
Nous avons donc construit un chatbot
- Entropy Intelligence vit dans la marketplace, sous la gouvernance existante.
- Le system prompt s’ajuste aux cas d’usage d’Entropy Data.
- Les outils MCP sont intégrés directement, et la gouvernance ne peut pas être contournée.
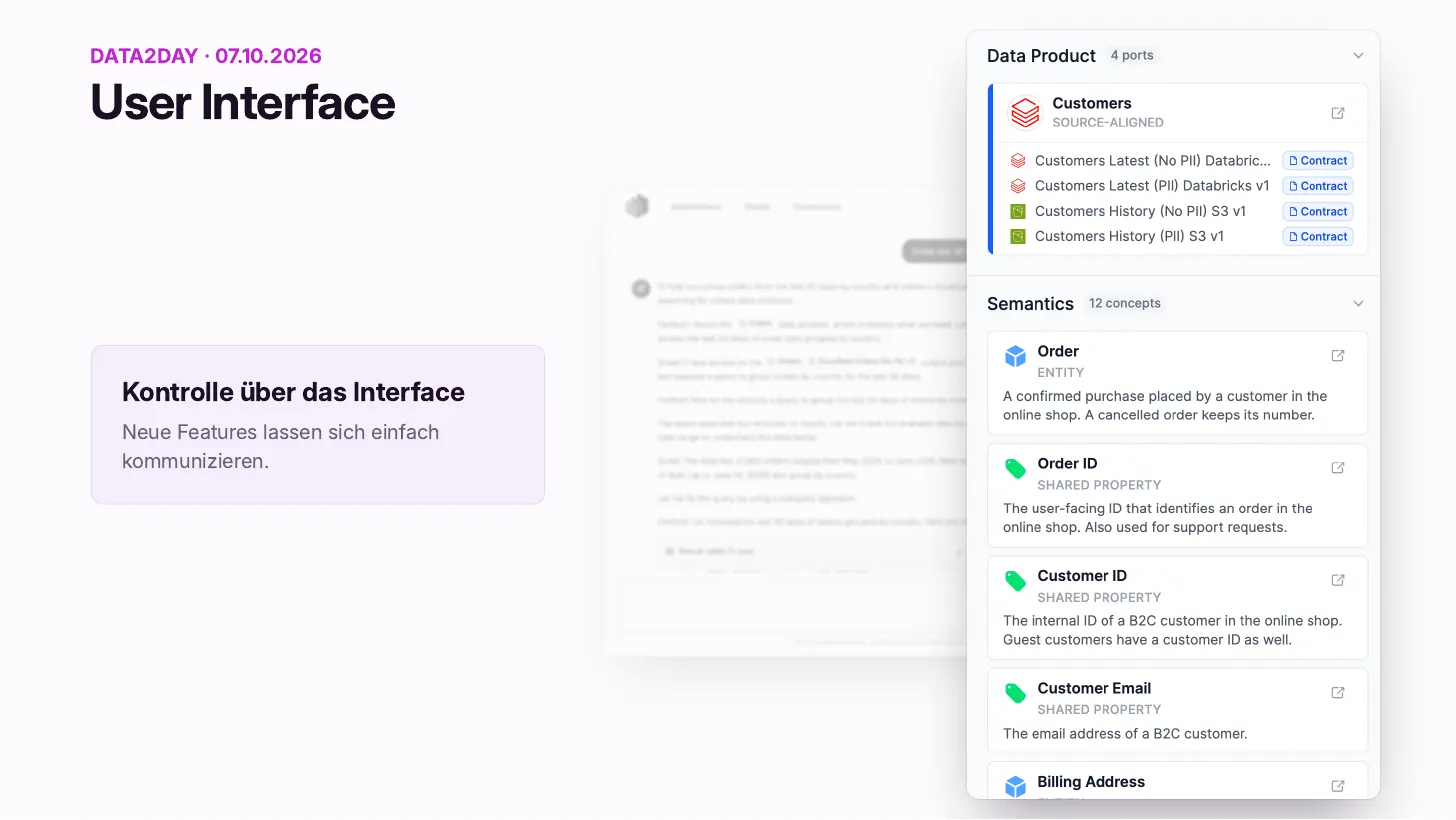
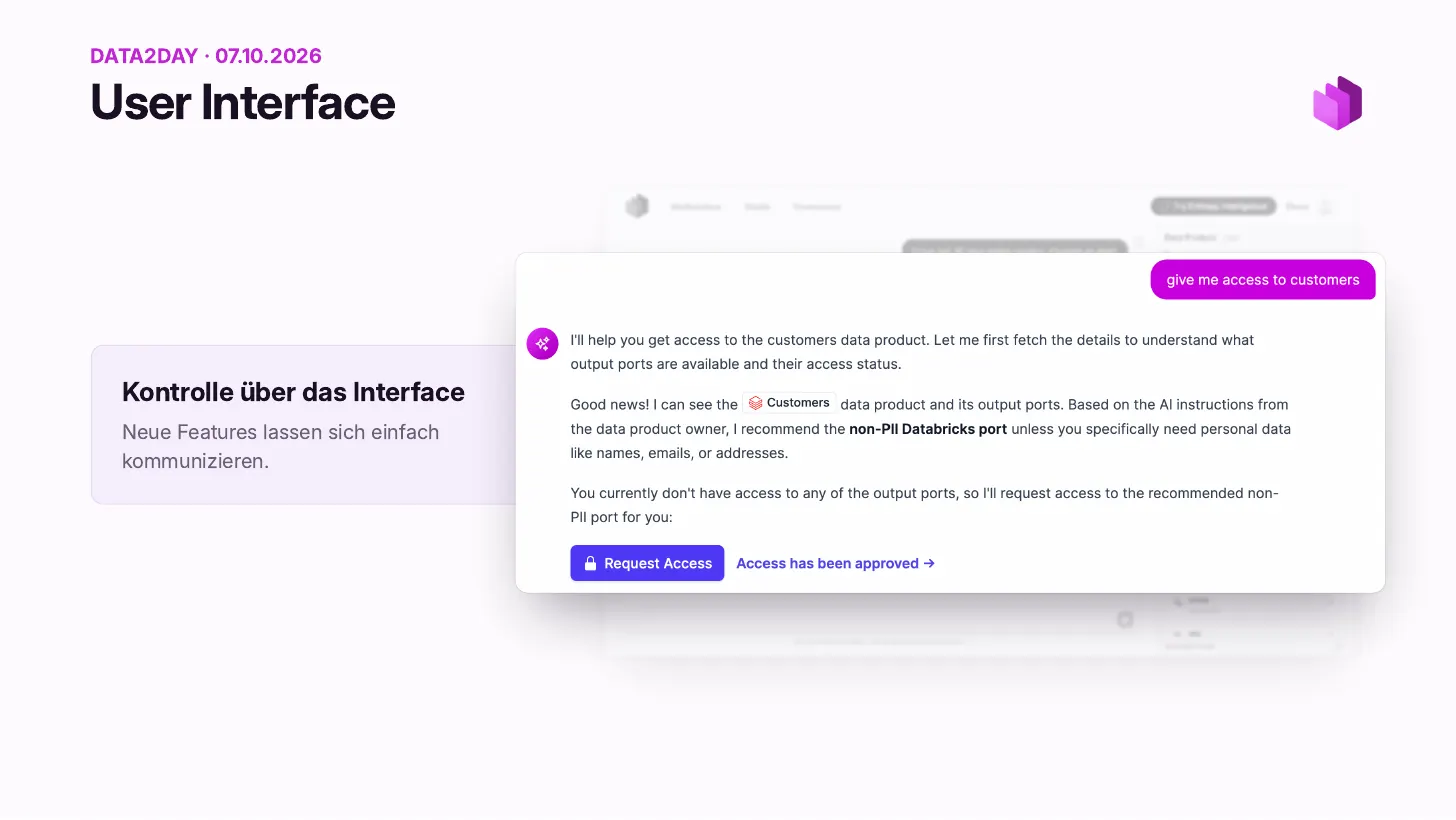
« Neue Features lassen sich einfach kommunizieren » : en maîtrisant l’interface, les nouvelles fonctionnalités se communiquent facilement.
Interface utilisateur
- Une meilleure traçabilité grâce au panneau de contexte : produit de données, Output Ports, concepts sémantiques et finalité d’un coup d’œil.
- De nouvelles fonctionnalités intégrées directement, par exemple un bouton Request Access au cœur de la conversation.
- Des éléments d’interface réutilisés, comme les puces et les icônes de la marketplace, aident les utilisateurs à se repérer.
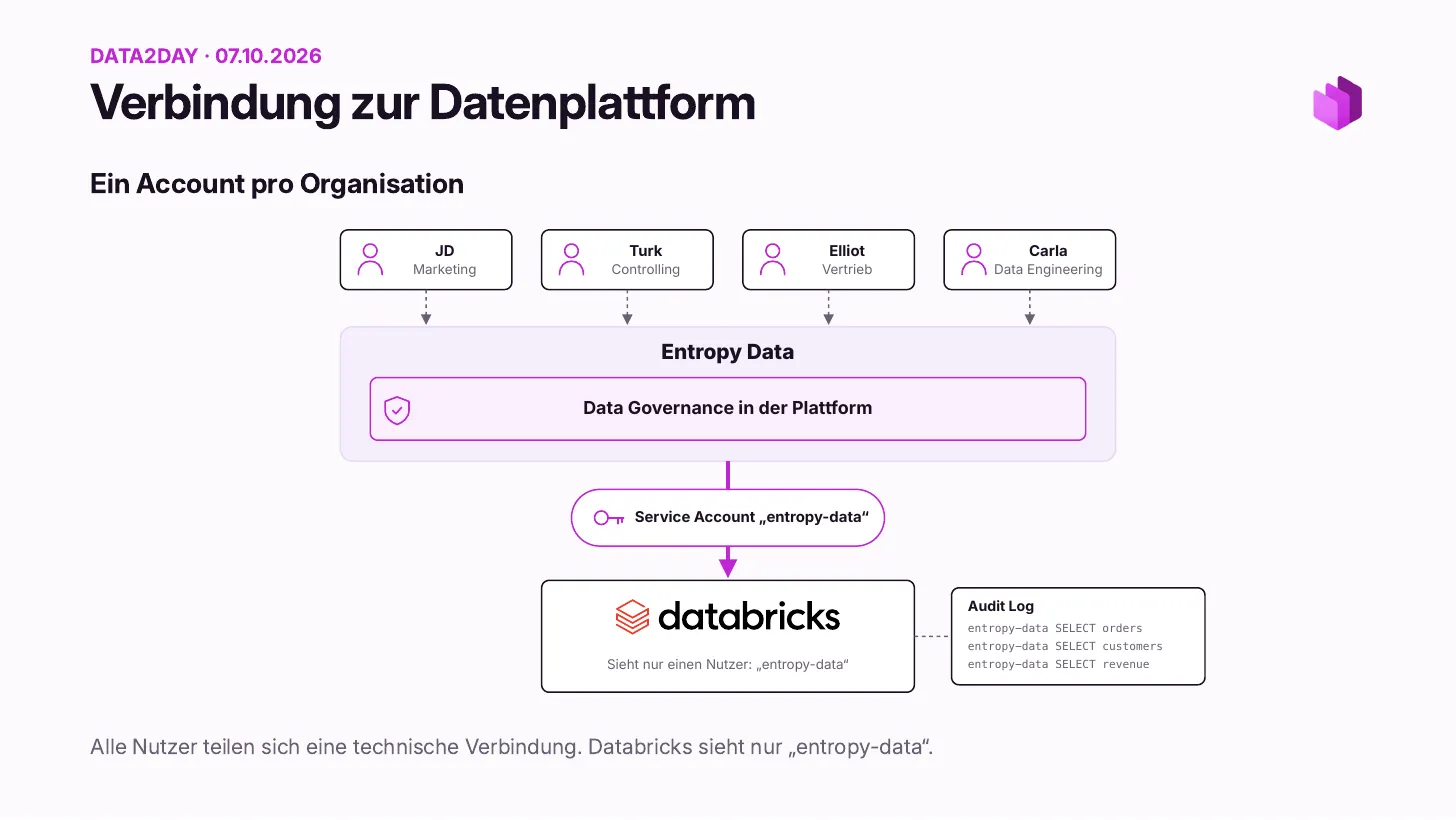
Qui interroge réellement les données ?
- Un seul compte de service pour toute l’organisation.
- Databricks ne voit qu’un seul utilisateur :
entropy-data. - Le journal d’audit ne montre plus qui a accédé à quoi.
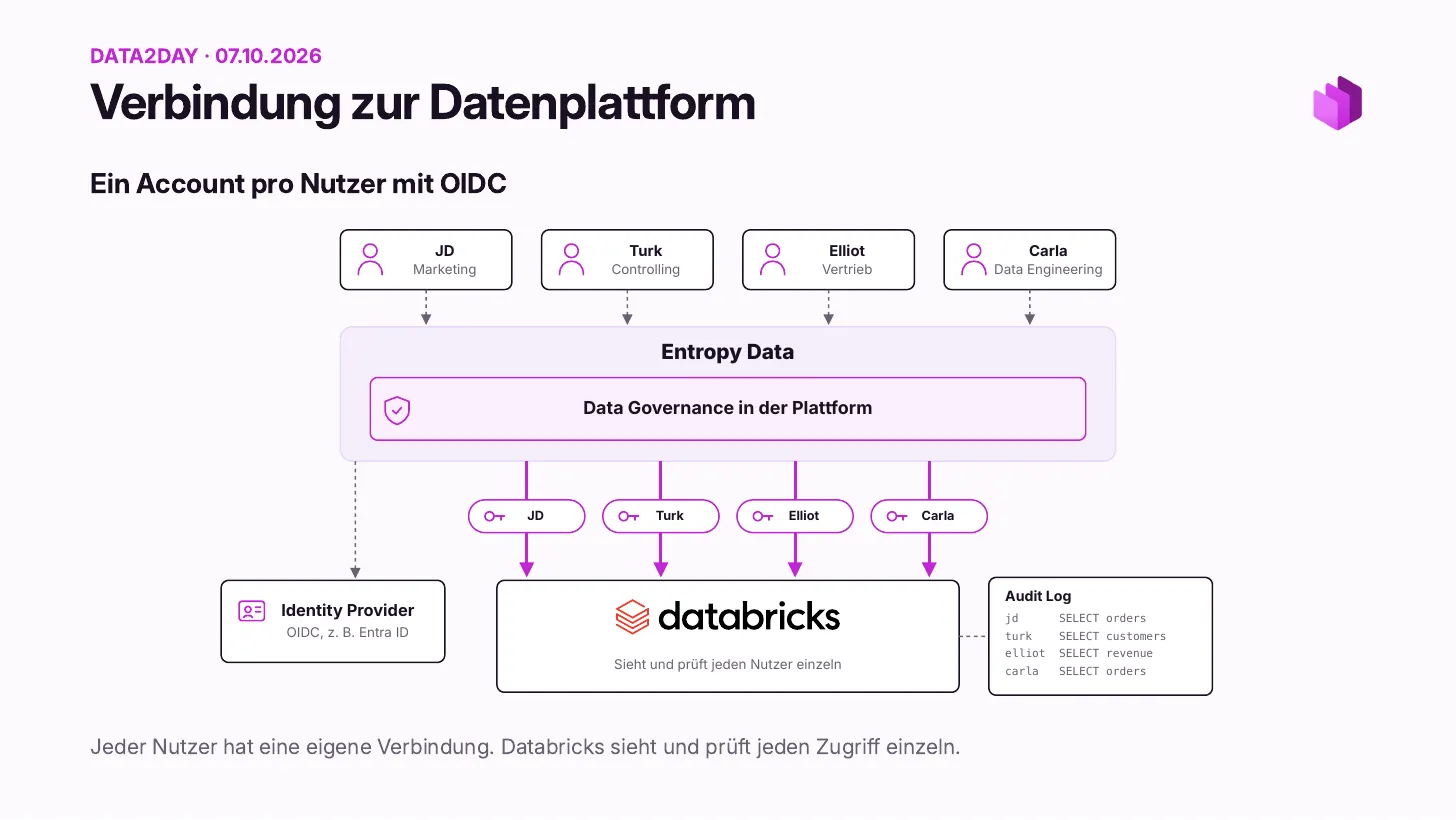
- OIDC : le fournisseur d’identité, par exemple Entra ID, transmet chaque identité à la plateforme.
- Databricks vérifie chaque accès individuellement, et le journal d’audit redevient exploitable.
- Principe : décidez d’abord sous quelle identité s’exécute l’accès aux données.
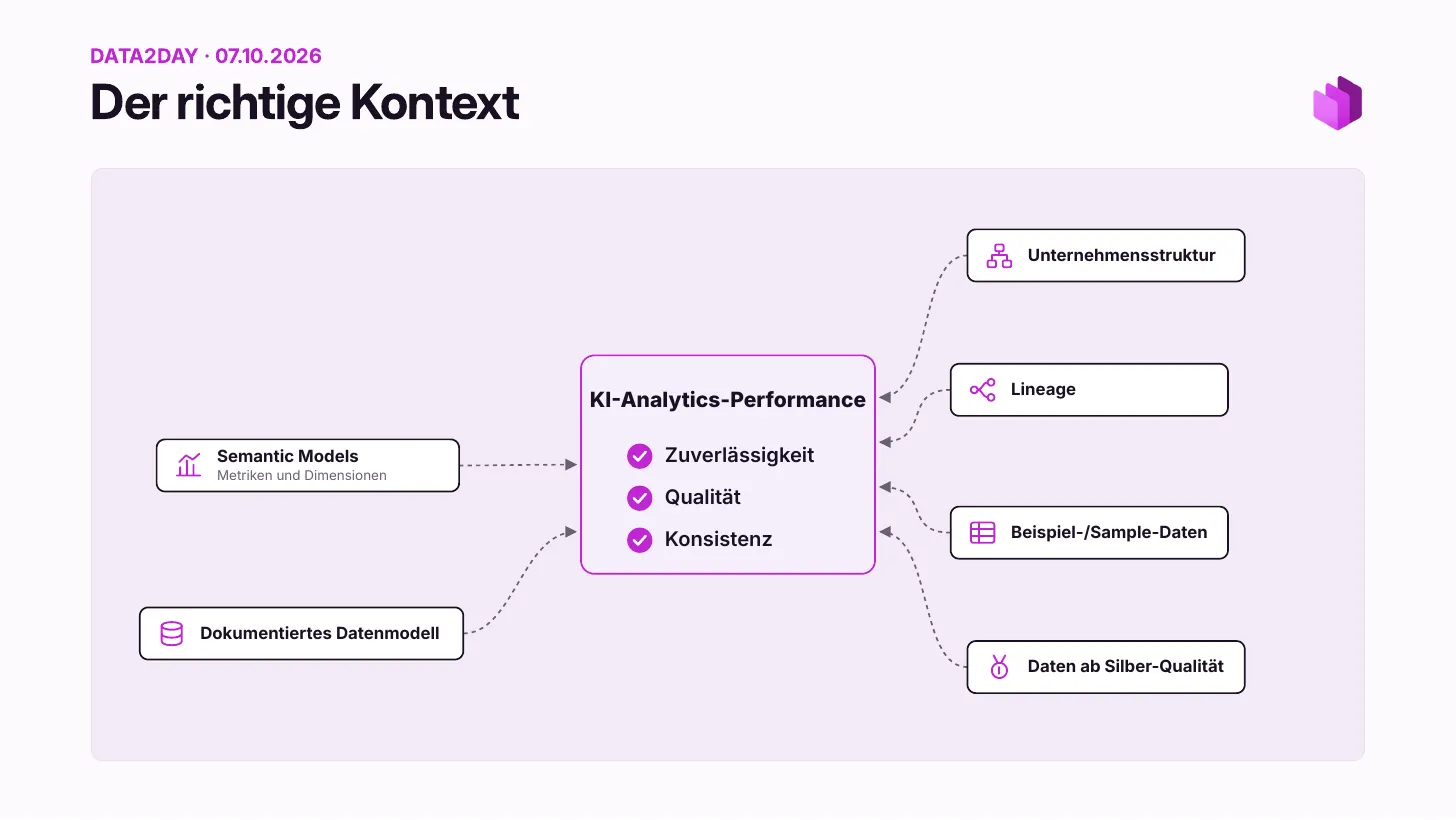
Le bon contexte : sept facteurs
- Les bases : des données de qualité silver au minimum et un modèle de données documenté.
- Les accélérateurs : structure de l’entreprise, data lineage et données d’exemple.
- La sémantique : modèles sémantiques (métriques, dimensions) et ontologies (concepts partagés).
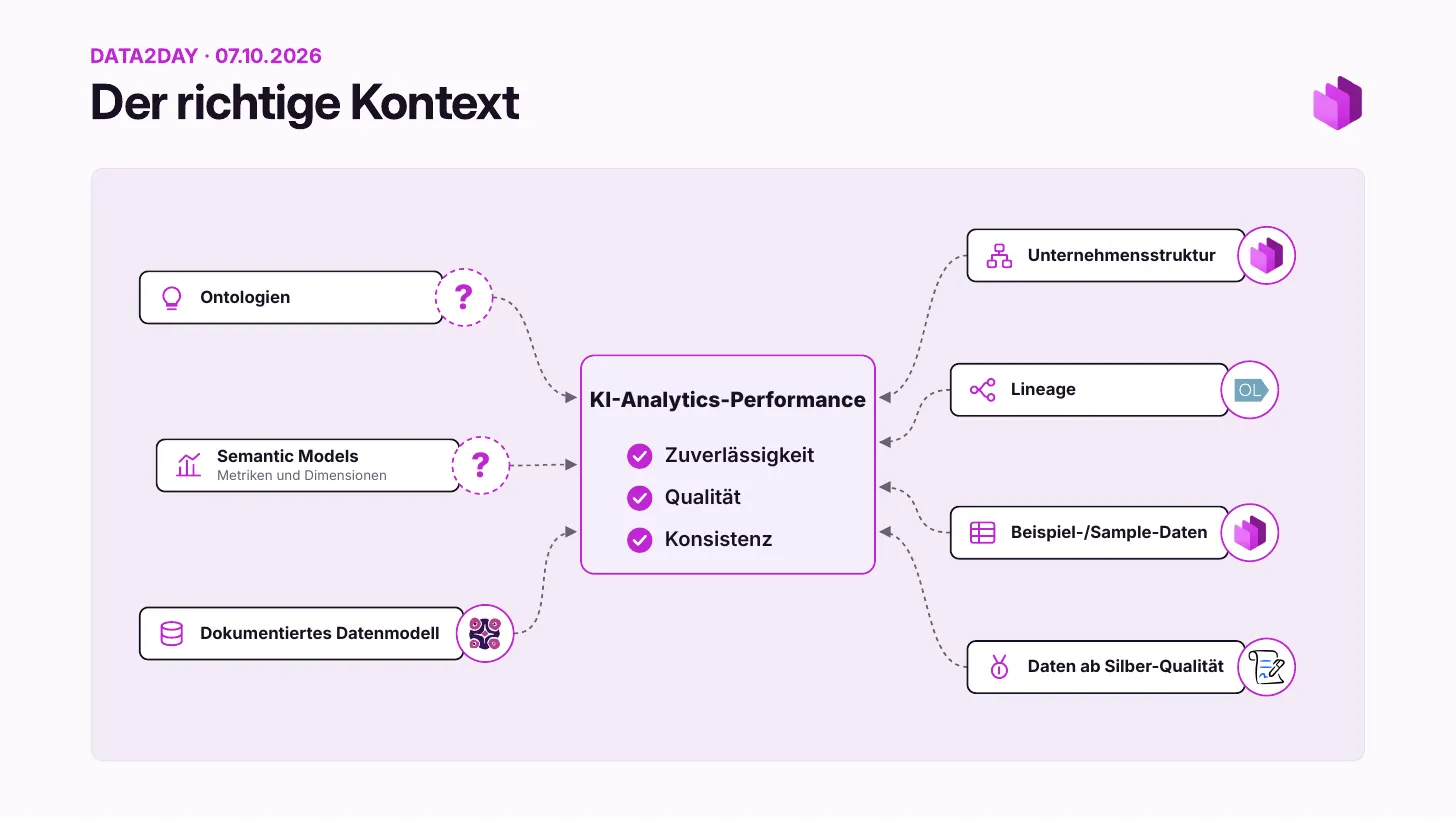
Cinq couverts, deux en suspens
- Modèle de données et qualité silver : couverts par les Data Contracts et les tests de contrat.
- Data lineage via les liens entre produits de données et OpenLineage, données d’exemple en partie dans les Data Contracts, structure de l’entreprise sous forme d’équipes et de domaines.
- Encore en suspens : les modèles sémantiques et les ontologies.
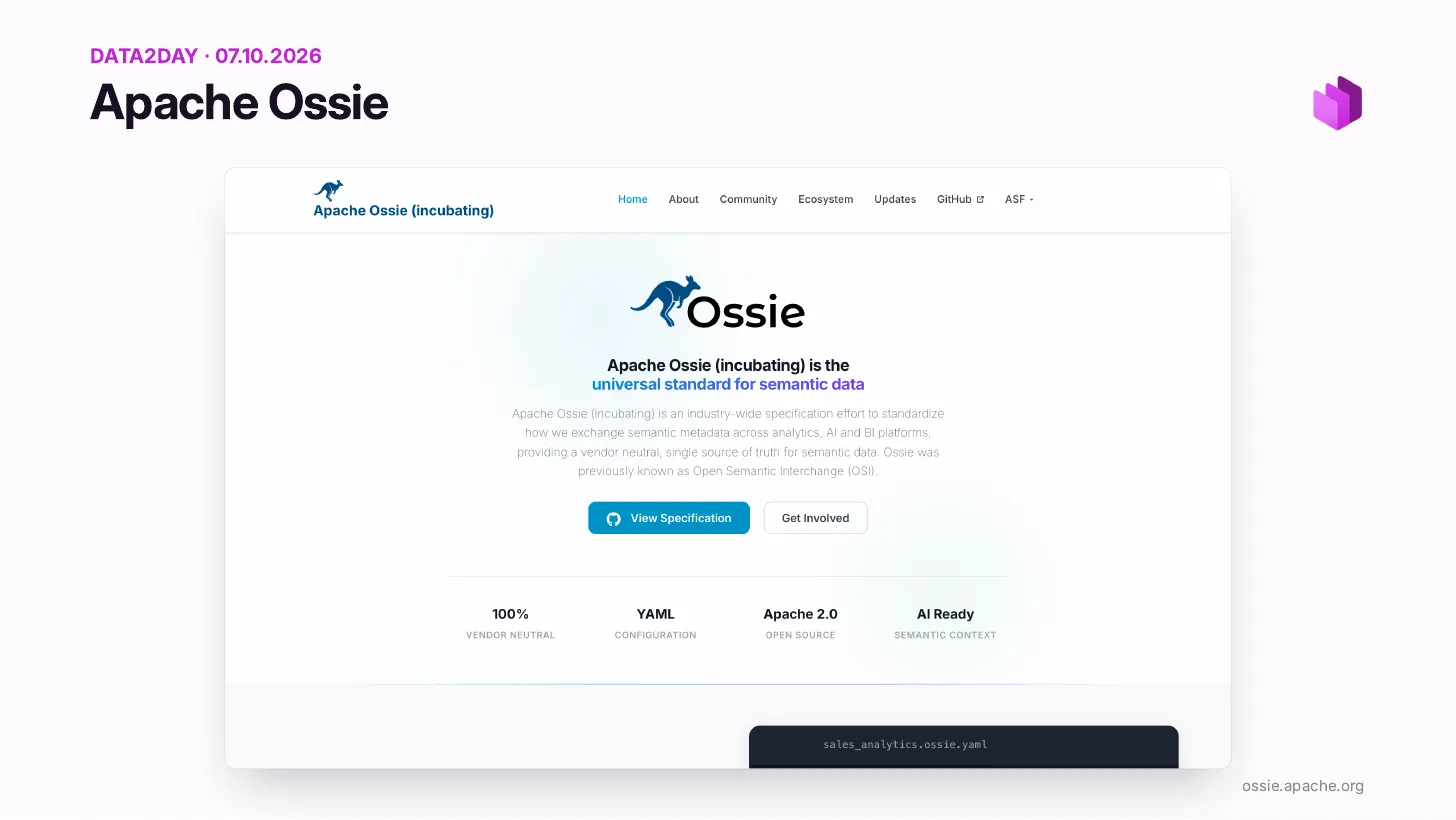
Apache Ossie
- Anciennement Open Semantic Interchange (OSI), aujourd’hui Apache Ossie.
- Un projet Apache en incubation pour les modèles sémantiques et les ontologies.
- Entropy Data le prend en charge comme format pour la sémantique.
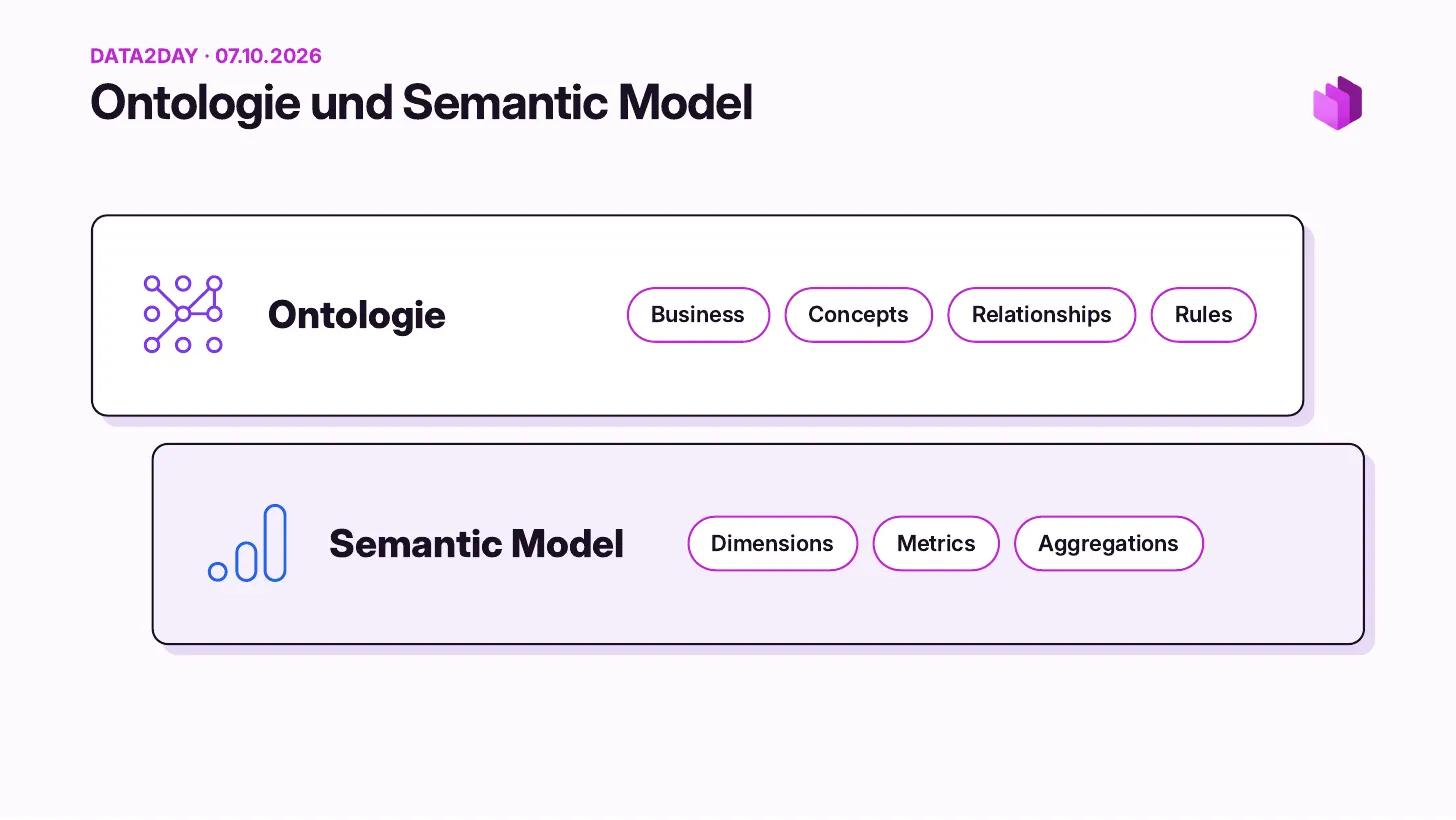
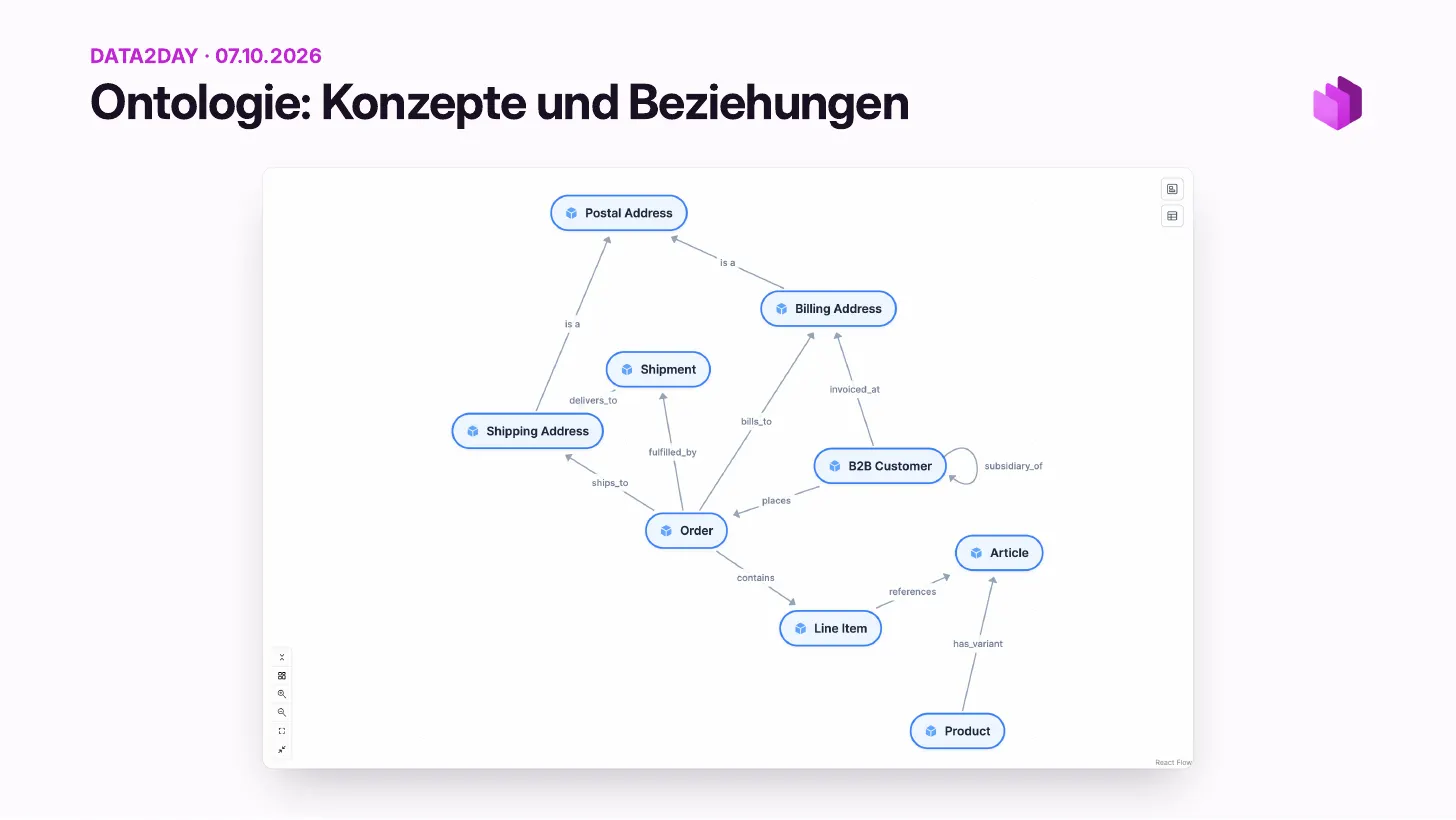
Ontologie et modèle sémantique
- Ontologie : des concepts comme Order, avec leurs propriétés.
- Les relations portent du sens : une commande ships to une adresse de livraison.
- Plus de sens, c’est plus de contexte pour l’agent.
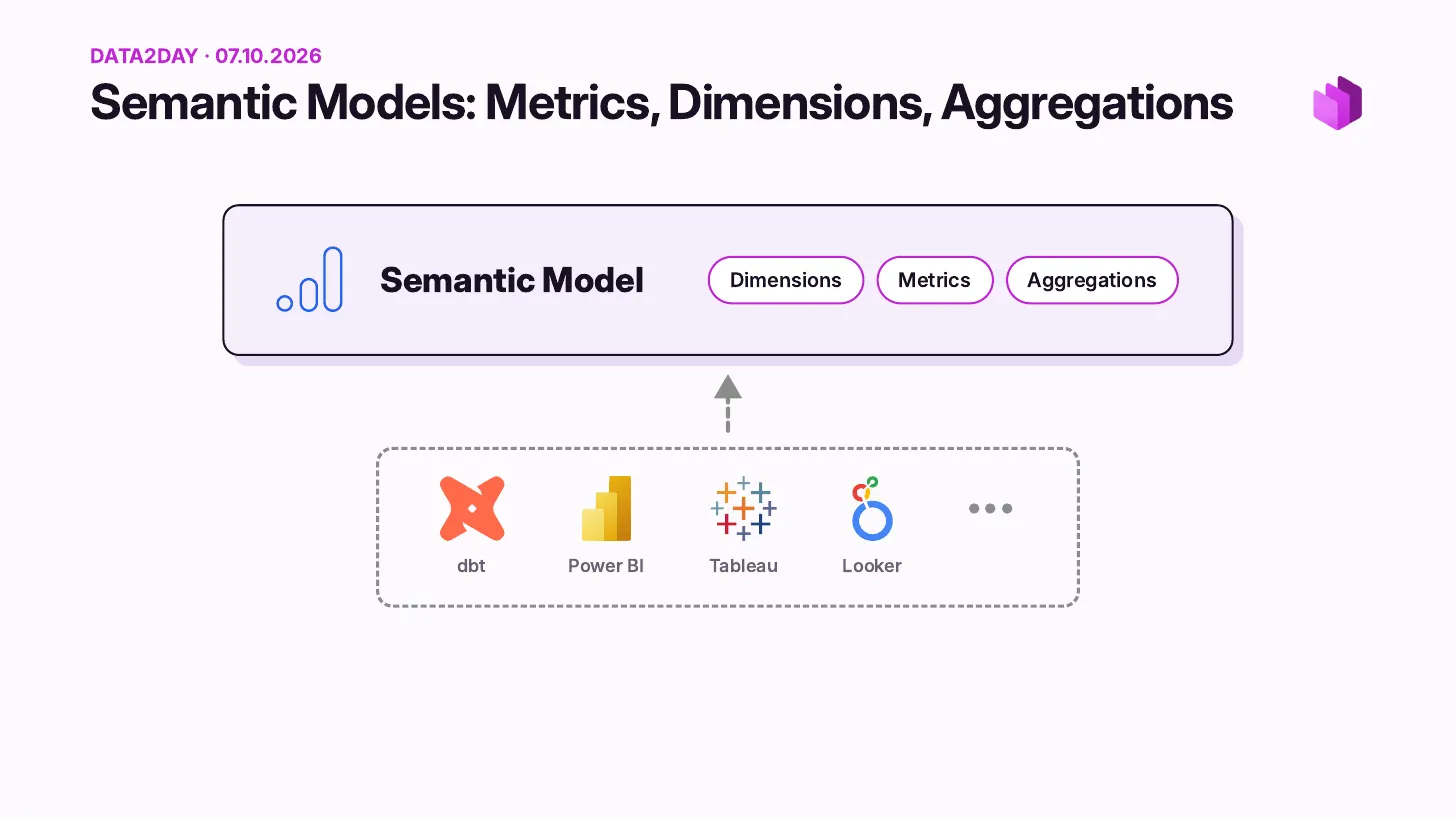
- Modèle sémantique : métriques, dimensions et agrégations sur les données.
- Connu de dbt MetricFlow, Power BI, Tableau et Looker.
- La logique de calcul, comme la valeur de commande, est définie en un seul endroit.
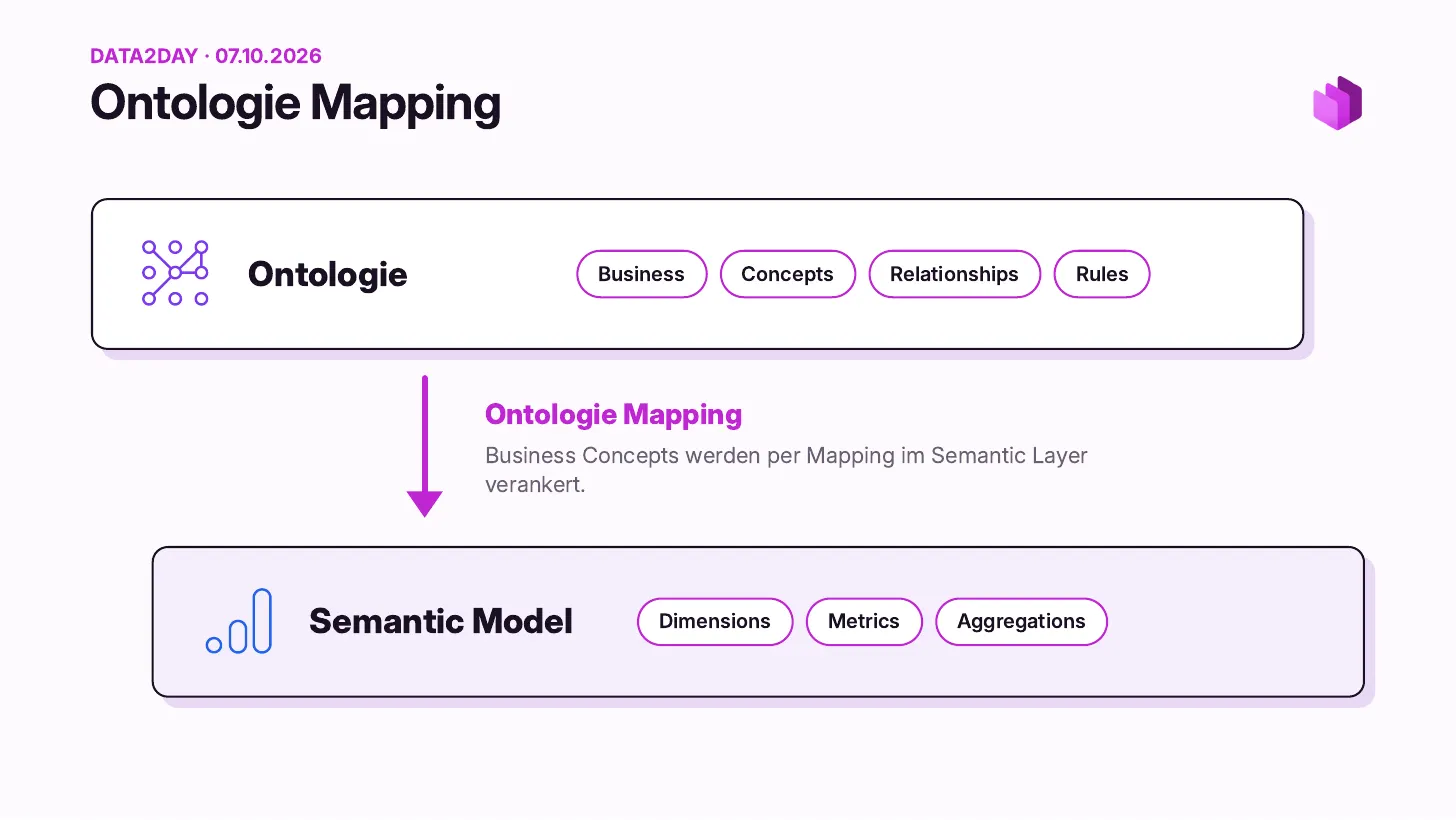
- Ossie ancre l’ontologie dans les modèles sémantiques.
- Une couche de mapping relie chaque concept à l’endroit où il apparaît.
- Avec ce lien, l’agent construit de meilleures requêtes.
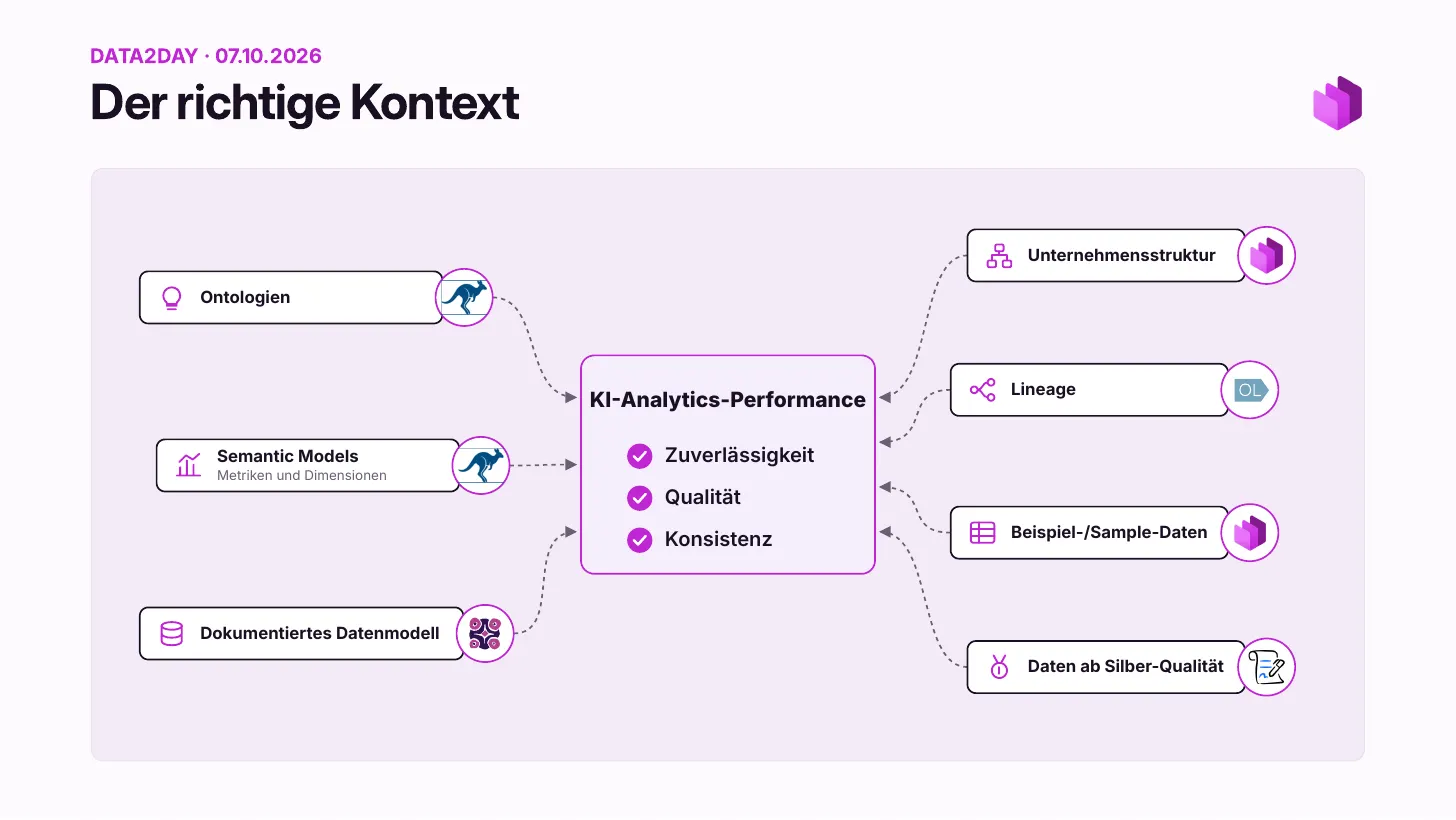
Par où commencer
- Commencez par les bases : un modèle de données documenté et des données de qualité silver.
- La structure de l’entreprise, le data lineage et les données d’exemple viennent en renfort.
- Les modèles sémantiques et les ontologies apportent de meilleurs résultats et plus de traçabilité.
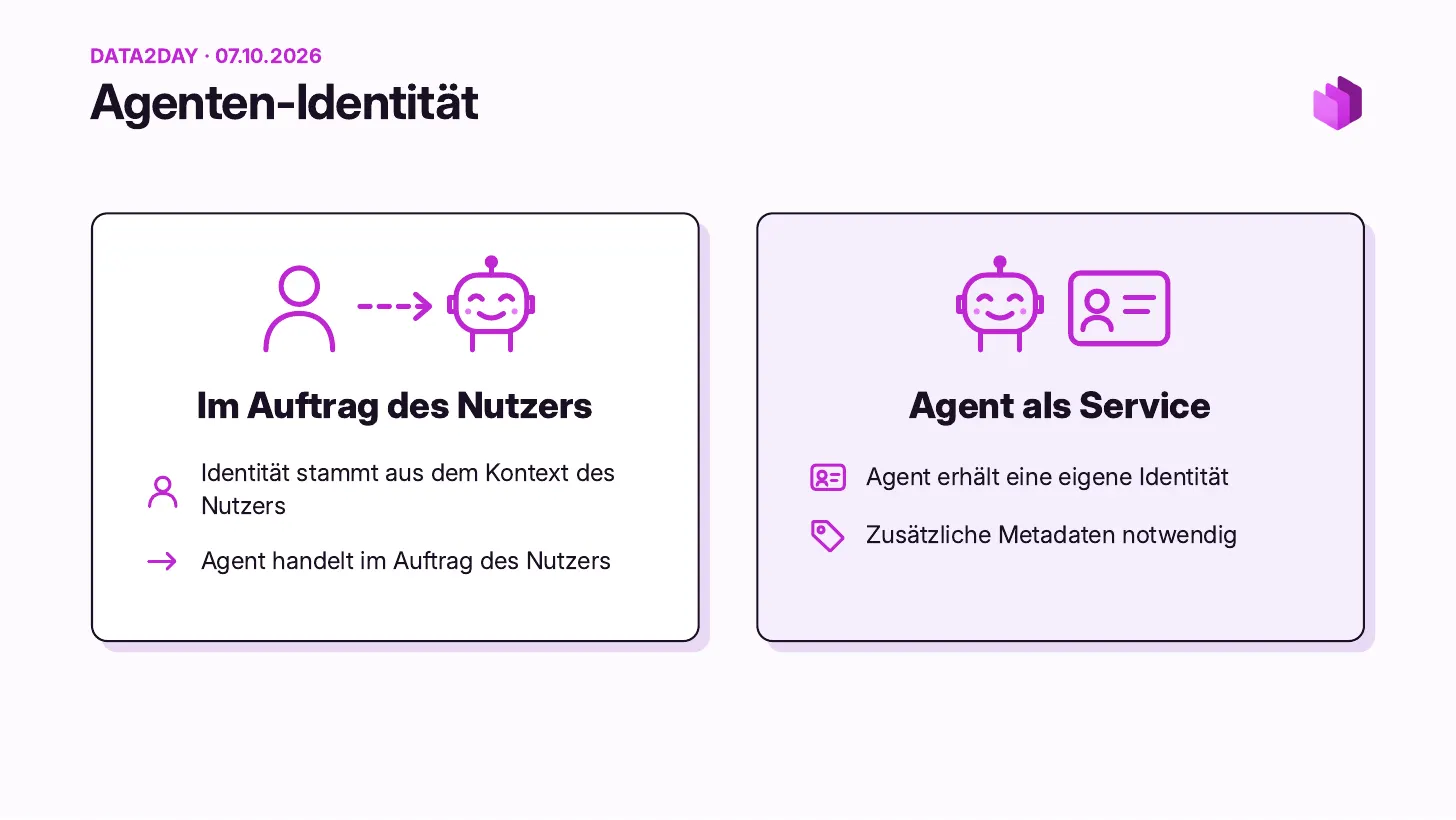
Les agents arrivent
- Les agents autonomes ont aussi besoin d’une identité.
- On behalf of the user : l’identité vient de l’utilisateur, comme dans le chatbot aujourd’hui.
- Agent as a service : une identité propre, plus des métadonnées comme l’opérateur.
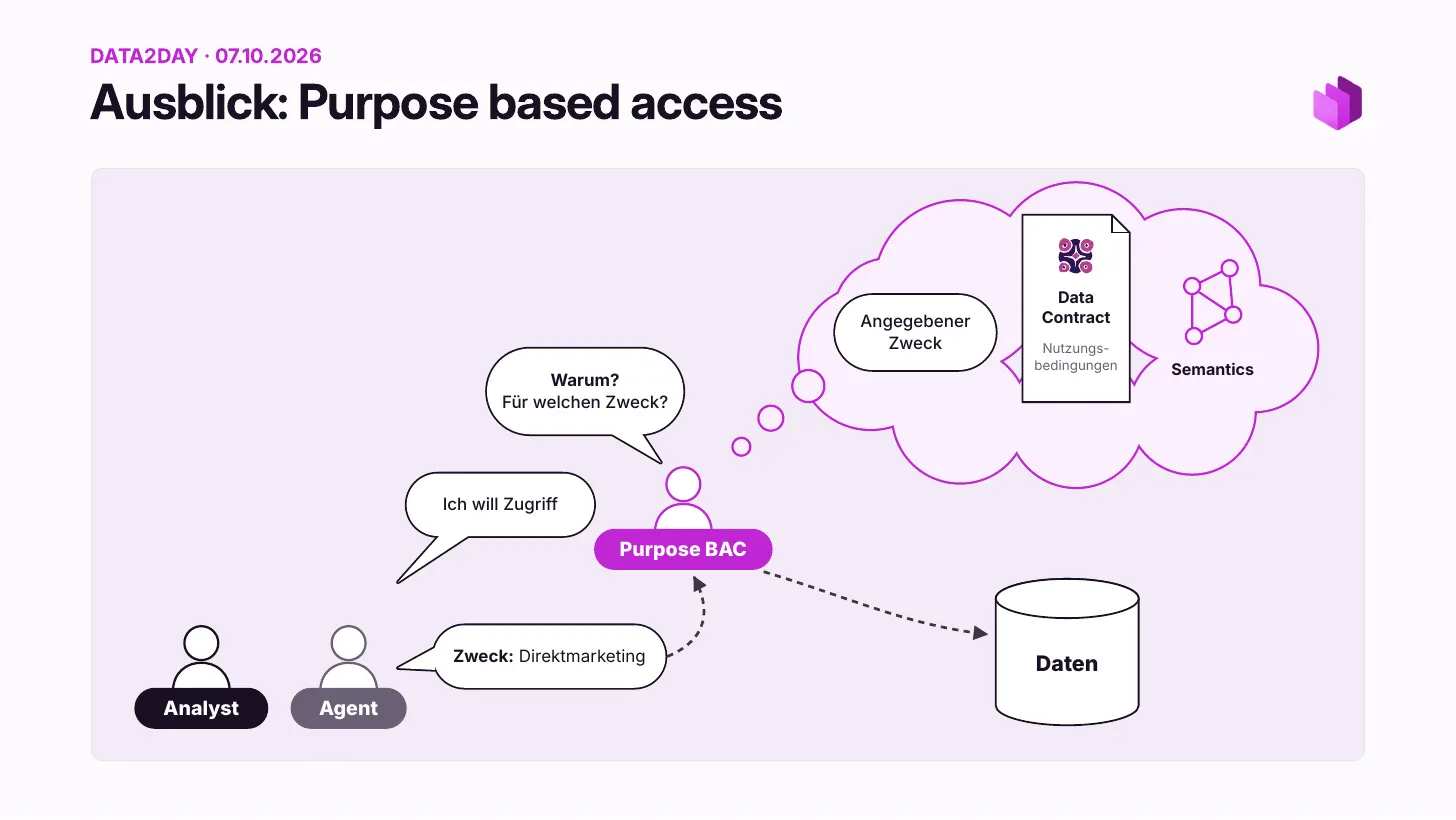
Perspective : le Purpose-based Access
- Les analystes et les agents doivent indiquer pourquoi ils ont besoin des données.
- La finalité est vérifiée par rapport aux conditions d’utilisation du Data Contract et à la sémantique.
- Une idée venue des questions du public : limiter l’accès dans le temps, par exemple à la session de l’agent.
À vous d’essayer
- Lancez la démo en 1 clic sur demo.entropy-data.com.
- Découvrez Apache Ossie et MCP.
- Testez vos Data Contracts avec la Data Contract CLI.
Articles associés
A Data Marketplace is What Your Agent Needs
Pourquoi les agents IA ont besoin d’une marketplace de données, pour lire les données via des outils gouvernés et pour construire de nouveaux produits de données, avec deux démos en direct.
Qu’est-ce qu’Apache Ossie ?
Le standard ouvert pour les ontologies et les modèles sémantiques, anciennement connu sous le nom d’Open Semantic Interchange.
Qu’est-ce que le Purpose-based Access Control ?
Les agents IA décident à l’exécution des données dont ils ont besoin. Le Purpose-based Access Control vérifie chaque requête par rapport aux conditions d’utilisation du Data Contract.