Conférence · JAX 2026
Data Architecture: The New Backbone of Modern Software
Dr. Gernot Starke (INNOQ Fellow) & Dr. Simon Harrer (CEO, Entropy Data) ·
Une conférence à deux voix à JAX 2026, à Mayence. Gernot commence par le recul historique : l'histoire du stockage des données et une thèse, celle d'un génie logiciel qui a largement oublié les données entre 1995 et 2020. Simon enchaîne avec le remède : les Data Contracts comme couche de spécification d'API pour les données, l'Open Data Contract Standard (ODCS), et une démo live d'un agent IA qui répond à des questions métier à partir de produits de données adossés à des contrats.
Enregistré en direct à JAX 2026, à Mayence. Le commentaire ci-dessous est un résumé remanié de la conférence.
TL;DR
Les cinq points clés et enseignements de la conférence.
-
Le génie logiciel a oublié les données. Entre 1995 et 2020, l'orientation objet, la SOA, l'agilité et les microservices se sont concentrés sur le comportement, pas sur la forme des données qui circulent. Résultat : des données sans propriétaire, du shadow IT et des marécages de données que l'IA met aujourd'hui à nu.
-
Chaque entreprise a déjà des API de données. Des CSV sur SFTP, du JSON sur S3 ou des tables sur Snowflake sont des interfaces dont dépendent tableaux de bord, rapports et modèles de ML. Quand un Data Producer les modifie en silence, les chiffres changent simplement, sans erreur ni alerte.
-
Les Data Contracts sont des spécifications d'API pour les données. Comme OpenAPI a mis fin au chaos des services des années 2000, un Data Contract ODCS décrit la propriété, le schéma, la sémantique, la qualité, les conditions d'utilisation, les SLA et les serveurs dans un seul fichier YAML. Rendre la propriété explicite est le grand pas, car le décalage entre les attentes des Data Producers et des Data Consumers explique pourquoi les pipelines cassent.
-
La valeur vient de l'automatisation et de l'outillage. Un Data Contract devient rentable dès que vous en générez du code, le testez contre les données réelles, bloquez les PR en cas de changement cassant et surveillez en continu. Comme pour OpenAPI, de bons outils open source comme le Data Contract CLI et le Data Contract Editor comptent davantage pour l'adoption que le standard lui-même.
-
Les agents IA ont besoin de Data Contracts, pas de suppositions. Les Data Contracts donnent aux agents la sémantique, les conditions d'utilisation, l'accès et la qualité nécessaires pour répondre aux questions métier directement sur les données de l'entreprise. Le pari : ODCS 3.0, publié en 2025, sera aussi omniprésent dans cinq ans qu'OpenAPI aujourd'hui.
Deux intervenants
Gernot Starke est INNOQ Fellow, cofondateur et mainteneur d'arc42, cofondateur d'aim42 et de l'iSAQB. Il fait de l'architecture logicielle depuis très longtemps, et les données en ont toujours fait partie, y compris à l'époque où le reste de la profession avait cessé d'en parler.
Simon Harrer est product engineer dans l'âme, coauteur de « Java by Comparison » et de « Remote Mob Programming », et cotraducteur en allemand du « Data Mesh » de Zhamak Dehghani. Après des années chez INNOQ, il a cofondé Entropy Data en 2025, sous forme de spin-off. Il comaintient le Data Contract CLI et le Data Contract Editor, et siège au TSC de BITOL, le projet Linux Foundation dédié aux standards ouverts de Data Contracts et de produits de données.
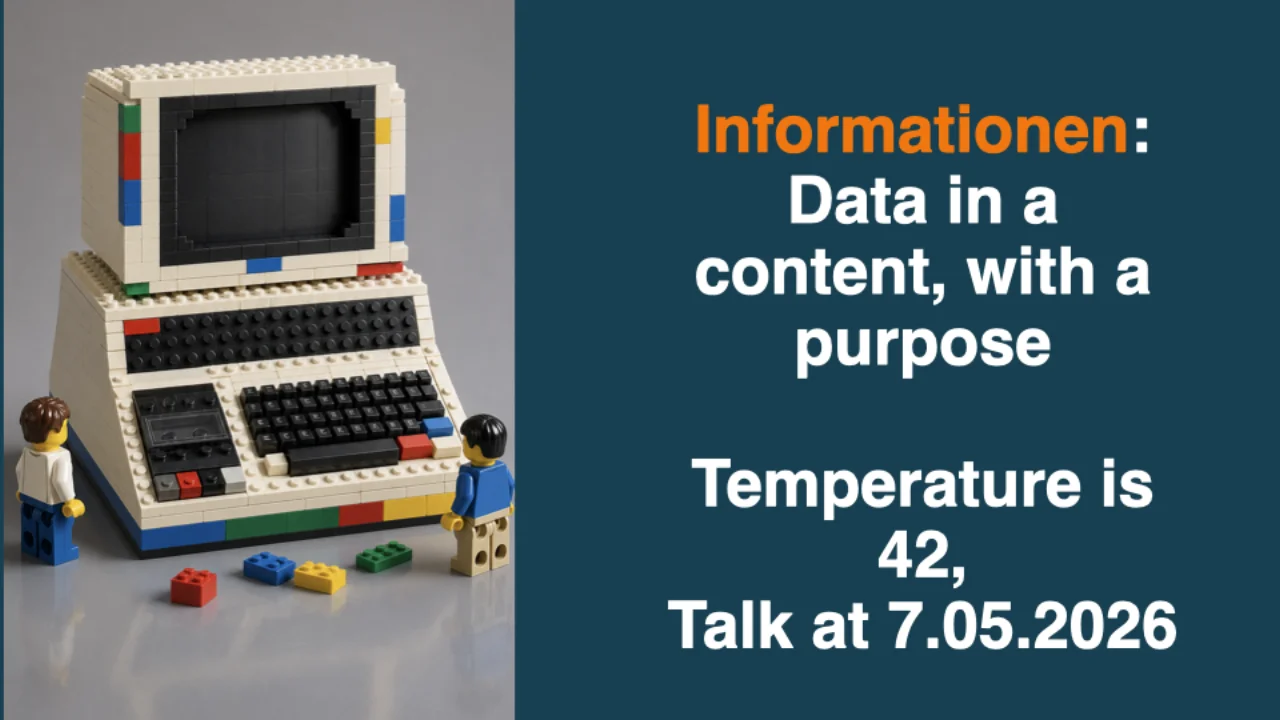
Données ou information ?
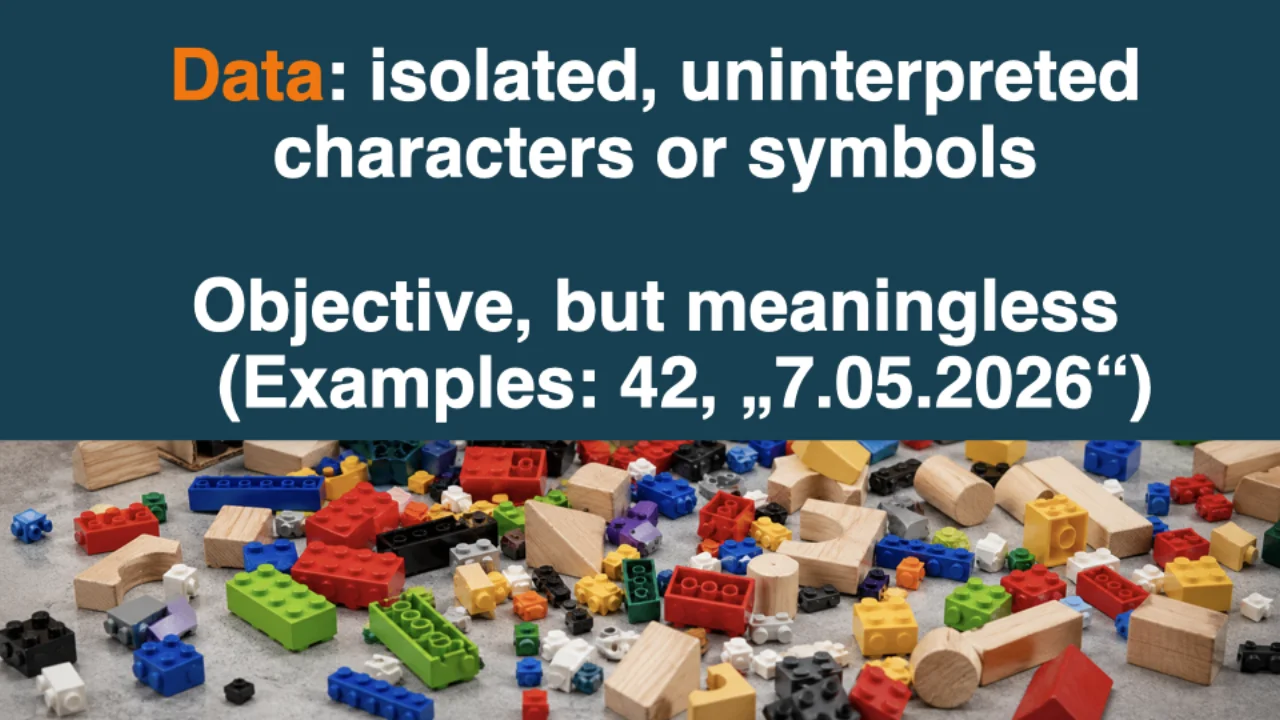
Tout le monde en informatique connaît la différence, mais elle mérite d'être redite. Les données, c'est le tas de briques Lego en vrac au fond du tiroir : des symboles isolés qui ne veulent rien dire tout seuls. 42 ou 07.05.2026, ce n'est qu'une valeur.
L'information, c'est la donnée remise en contexte, avec de la sémantique. « La température est de 42 °C » ou « conférence le 2026-05-07 », là on peut agir. Toute l'histoire de l'architecture de données consiste à transformer la première en la seconde.
De la mémoire à tores aux disquettes
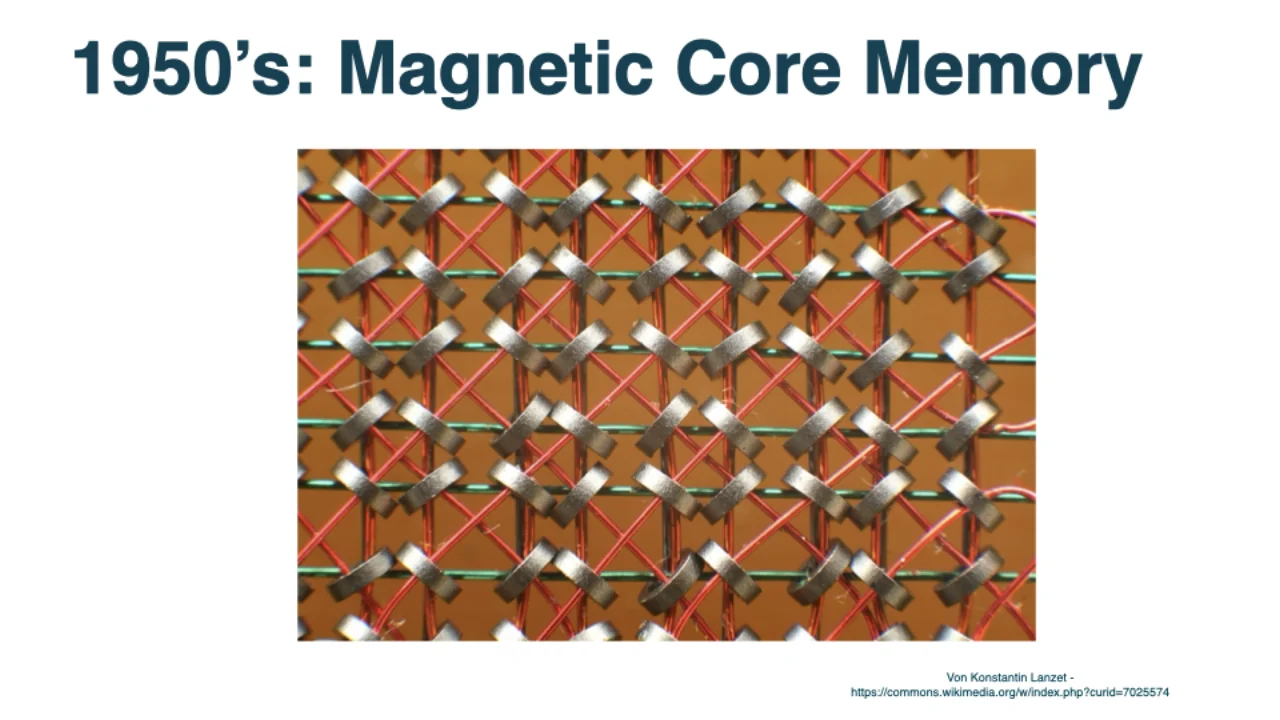
Côté informatique, tout commence dans les années 1950 avec la mémoire à tores de ferrite : de minuscules anneaux enfilés sur des fils, qu'on aimantait dans un sens ou dans l'autre pour stocker un bit. Rien à voir avec le nucléaire, malgré le nom allemand « Kernspeicher », et quasiment personne dans la salle n'en avait jamais eu une entre les mains.
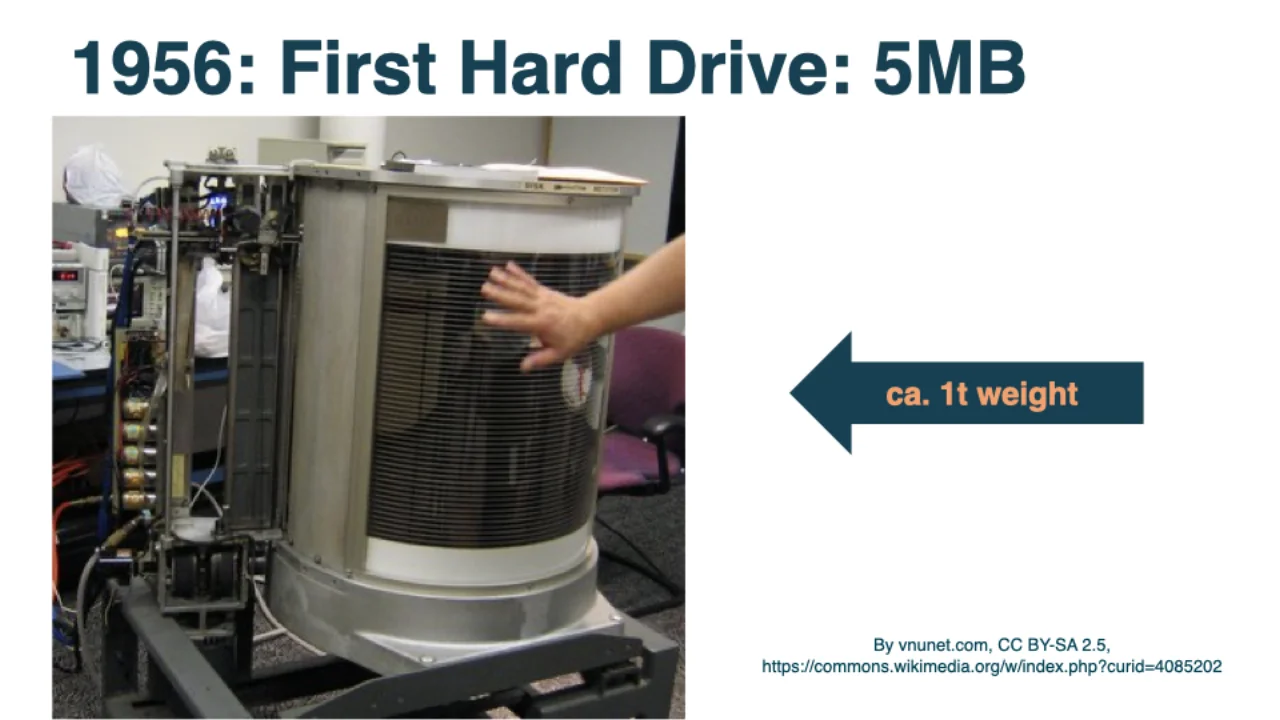
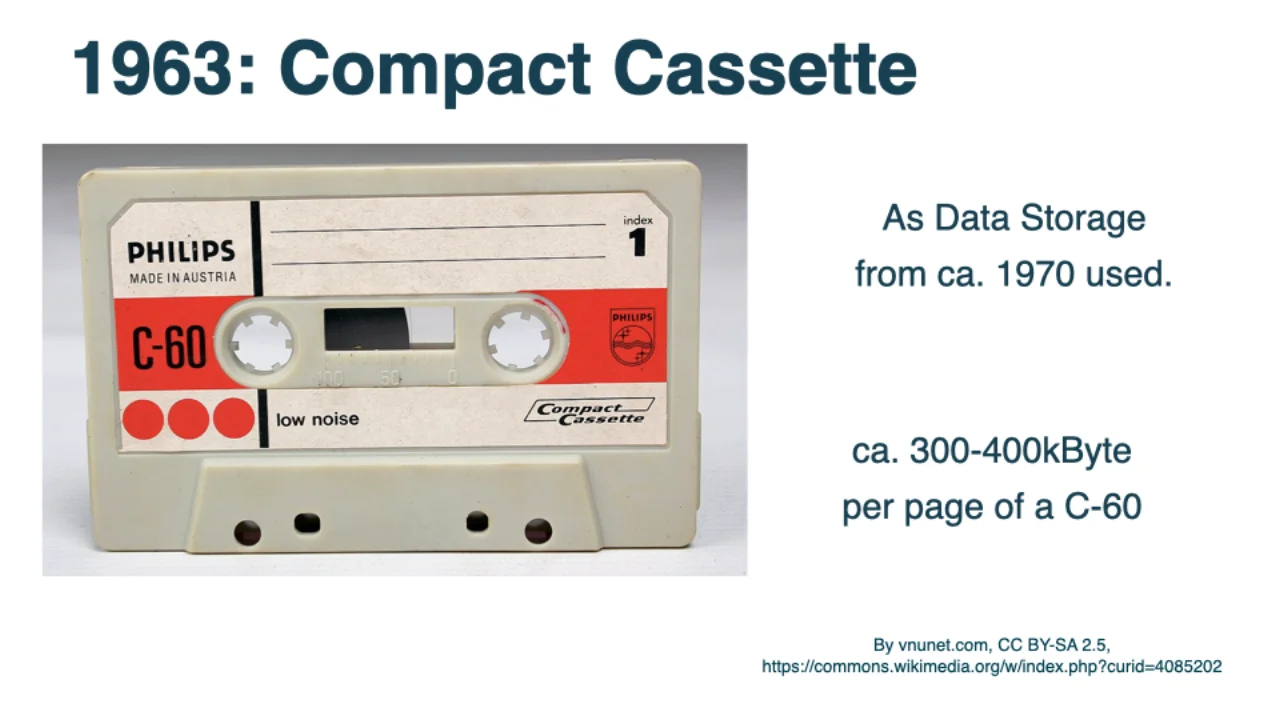
En 1956, IBM livre le premier disque dur : une pile de plateaux magnétiques, 5 mégaoctets, et près d'une tonne. Dans les années 1970, on réquisitionne la cassette audio comme support de données : 300 à 400 kilooctets par face, soit aujourd'hui à peu près la moitié d'une icône d'application.
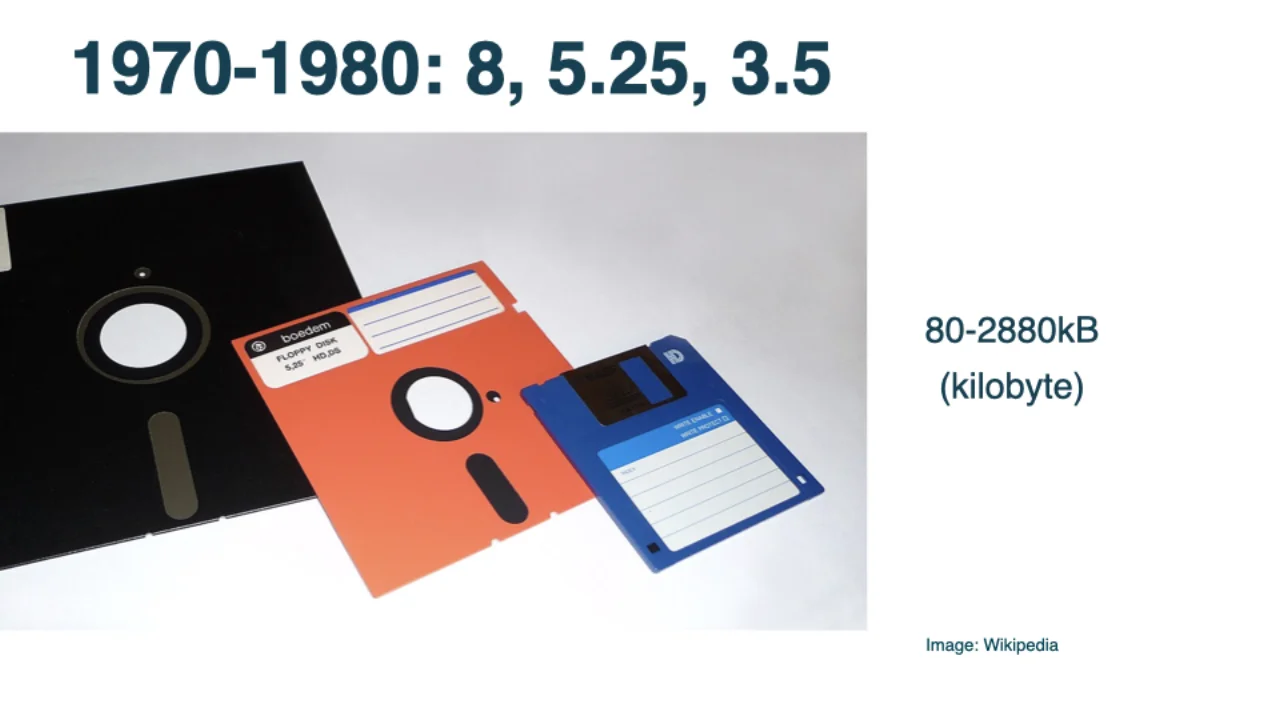
Viennent ensuite les disquettes 8, 5,25 et 3,5 pouces : souples, sensibles à la poussière, et pratiquement vides. 80 ko sur les premières, jusqu'à 2880 ko sur les toutes dernières. Des « porteurs de données », au sens le plus littéral du terme.
Du gigaoctet à l'ångström
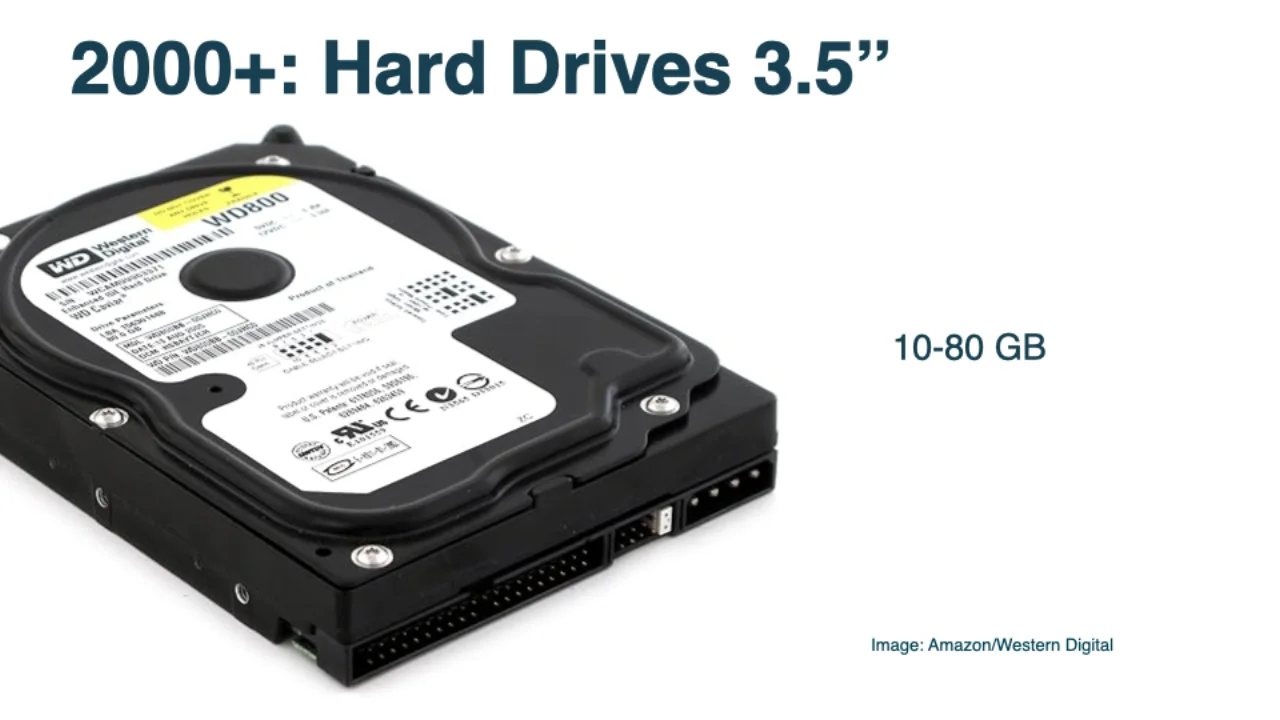
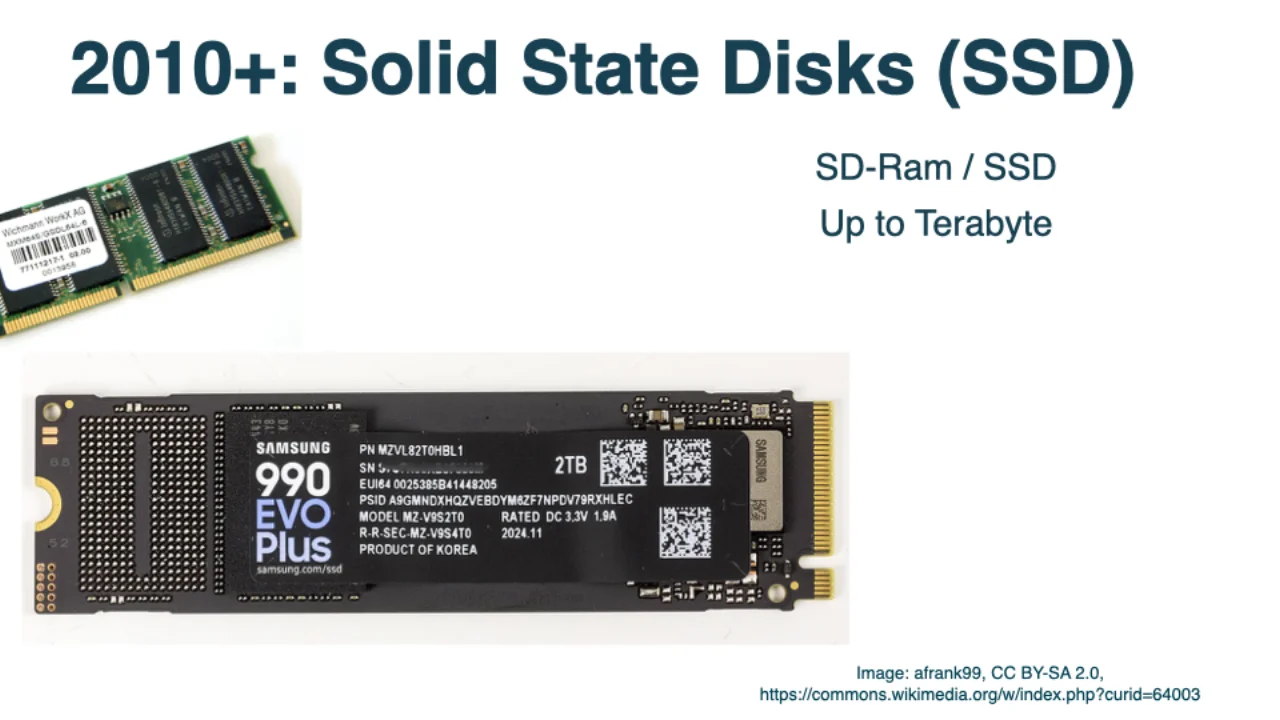
Dans les années 2000, les disques grand public se comptent en dizaines de gigaoctets ; à partir de 2010, les SSD font passer le même format au téraoctet. Les disques de datacenter d'aujourd'hui affichent 24 To, et ce n'est pas fini. Ironie de l'histoire, ils sont aussi devenus difficiles à acheter : ils partent tous chez les hyperscalers.
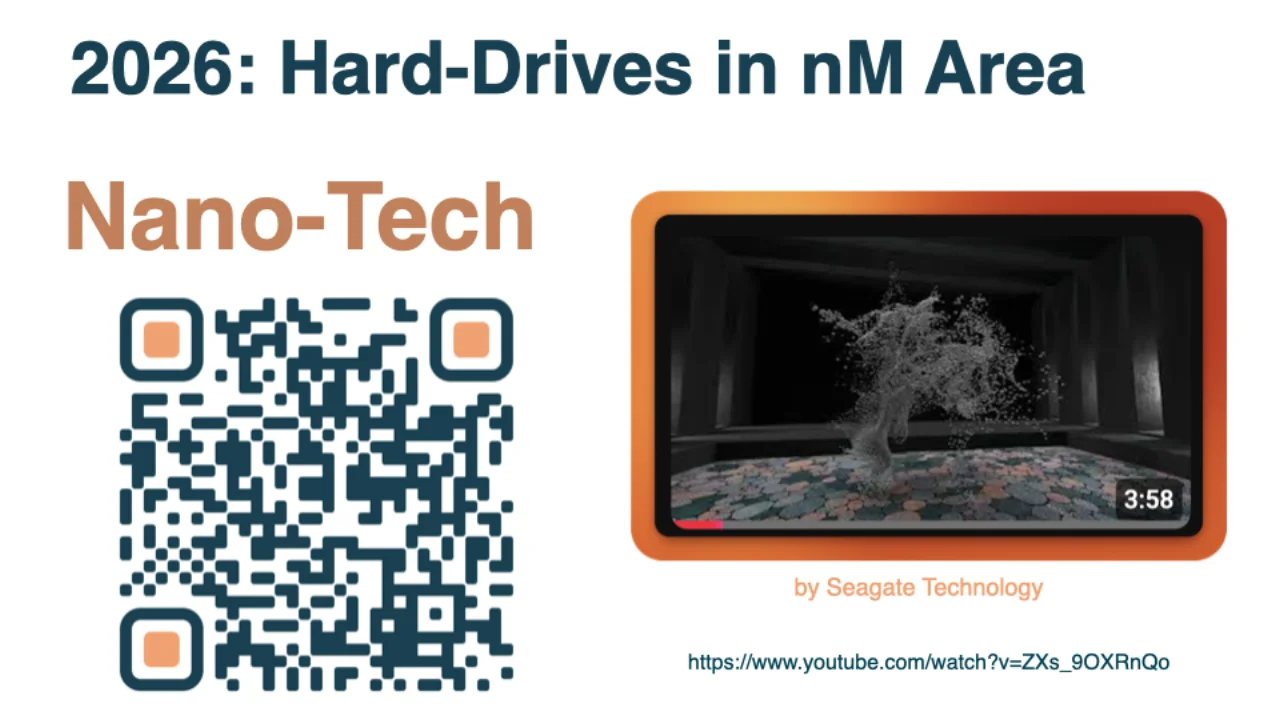
Le plus fascinant, c'est ce que l'industrie du stockage est devenue en silence : dans une vidéo Seagate que Gernot a projetée, on voit des têtes de lecture-écriture voler au-dessus du plateau avec des tolérances de l'ordre de l'ångström, c'est-à-dire à l'échelle moléculaire. Les fabricants de disques durs travaillent avec la même précision que les machines de gravure d'ASML. Quatre minutes de vidéo qui valent le détour.
Le commerce, premier cas d'usage des données
Consigner les choses est un besoin fondamental des civilisations depuis toujours. Le commerce en est le bon exemple. Les bâtisseurs de pyramides égyptiens tenaient déjà des listes de transactions. Les marchands du Moyen Âge notaient leurs achats et leurs ventes à la plume dorée.
Puis quelqu'un a inventé la comptabilité en partie double : doubler délibérément le volume de données à tenir, pour réduire les erreurs. C'est au fond un dispositif de qualité de données. (Spoiler : l'idée va revenir.)
Aujourd'hui, dans un groupe de distribution, la donnée est l'or. C'est elle qui permet de négocier de meilleures conditions d'achat, de répartir les stocks entre les magasins, de personnaliser les offres. Vous pouvez avoir des algorithmes brillants, des tableaux de bord soignés et les meilleurs modèles de ML du monde : si les données qui les alimentent sont médiocres, ce que le manager récupère à l'autre bout l'est tout autant.
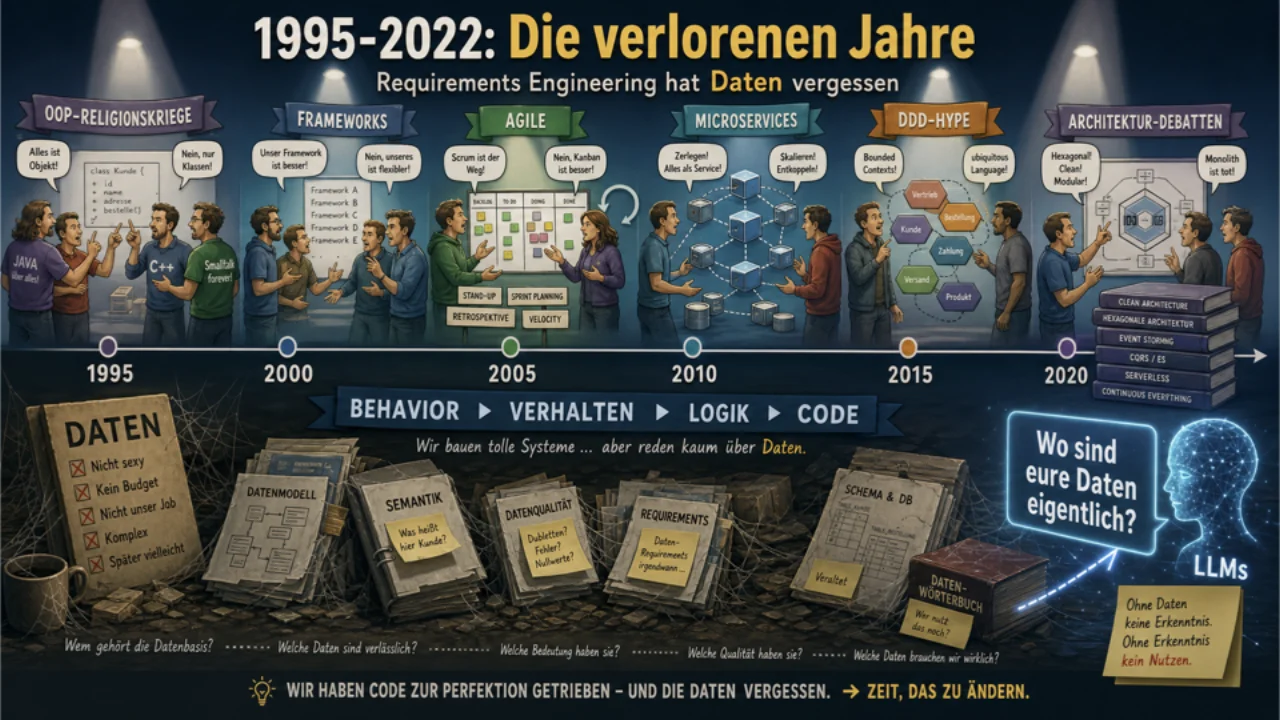
Défi n° 1 : le génie logiciel a oublié les données
La thèse est volontairement provocatrice : entre 1995 et 2020, le génie logiciel a largement oublié les données. On avait la tête ailleurs.
Vers 1995, C++ se généralise, Java débarque, et tout le monde apprend l'objet : héritage, méthodes, couplage et cohésion. Le versant fonctionnel du logiciel. Dans les années 1980, on parlait encore couramment de « modèle de données » ; à la fin des années 1990, le terme était presque devenu un gros mot. Puis la SOA. Puis l'agilité et Scrum (le mot « données » n'apparaît nulle part dans le Scrum Guide). Puis les microservices. Tout cela centré sur le comportement, jamais sur la forme des données qui circulaient.
Gernot reconnaît volontiers qu'il était en plein dedans. Complice, dit-il. Il ne s'agit pas de s'excuser, mais de prendre la mesure du trou dont nous sommes en train de remonter.
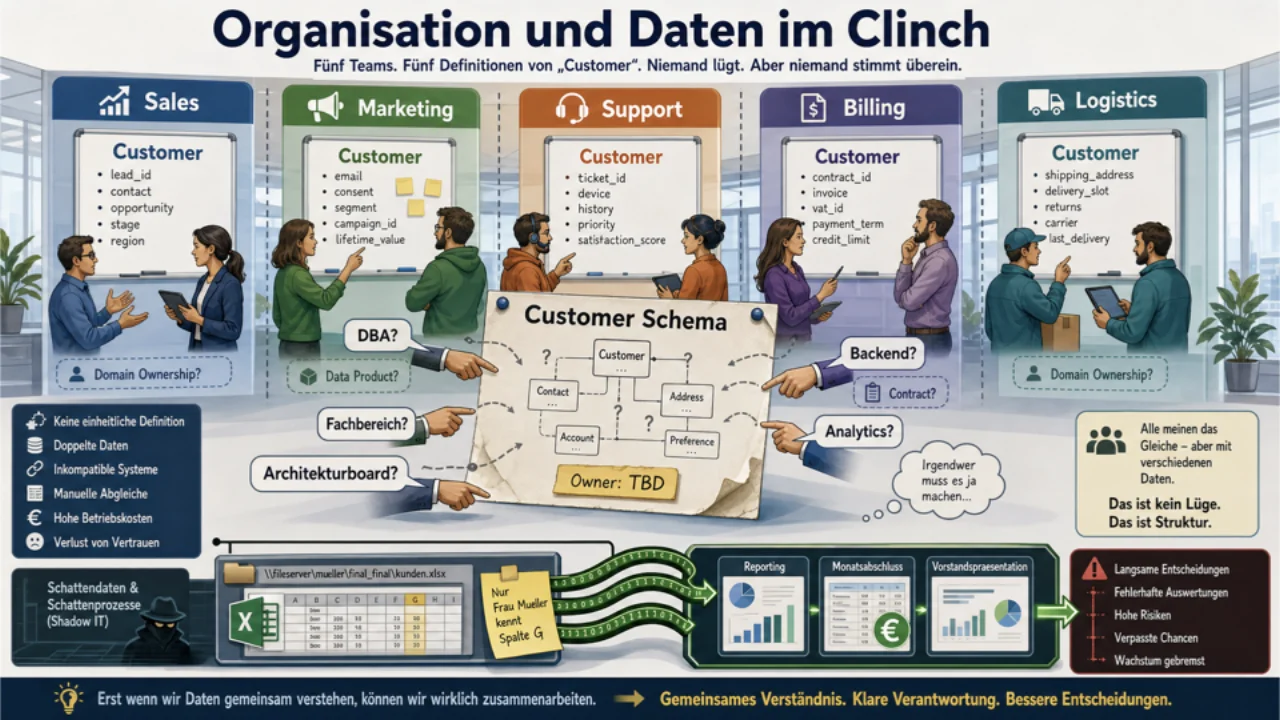
Défi n° 2 : les données, seul actif sans propriétaire
Dans une entreprise, tous les autres actifs ont un propriétaire. Les données, traditionnellement, non. Ou plutôt : tout le monde s'estime propriétaire, ce qui revient au même problème sous une autre forme.
L'exemple préféré de Gernot vient d'un assureur chez qui il travaillait au moment de la mise en place du RGPD. La maison avait une joyeuse convention d'« adresse pour tous » : dès que quelqu'un manifestait de l'intérêt pour un produit, son adresse était transmise à tous les destinataires internes susceptibles d'en vouloir. Puis le RGPD arrive, « Sylvia » demande la suppression de ses données, et personne ne peut dire honnêtement où elles ont atterri. Personne n'était propriétaire du fichier d'adresses.
Il appelle l'état qui en résulte, avec son mot allemand, du « Wildwuchs » : une prolifération sauvage. Il y a des données en pagaille, mais personne ne sait quelle copie fait foi, si elle est encore valide, ni si elle a le bon nombre de décimales.
Défi n° 3 : de jolies images posées sur un marécage
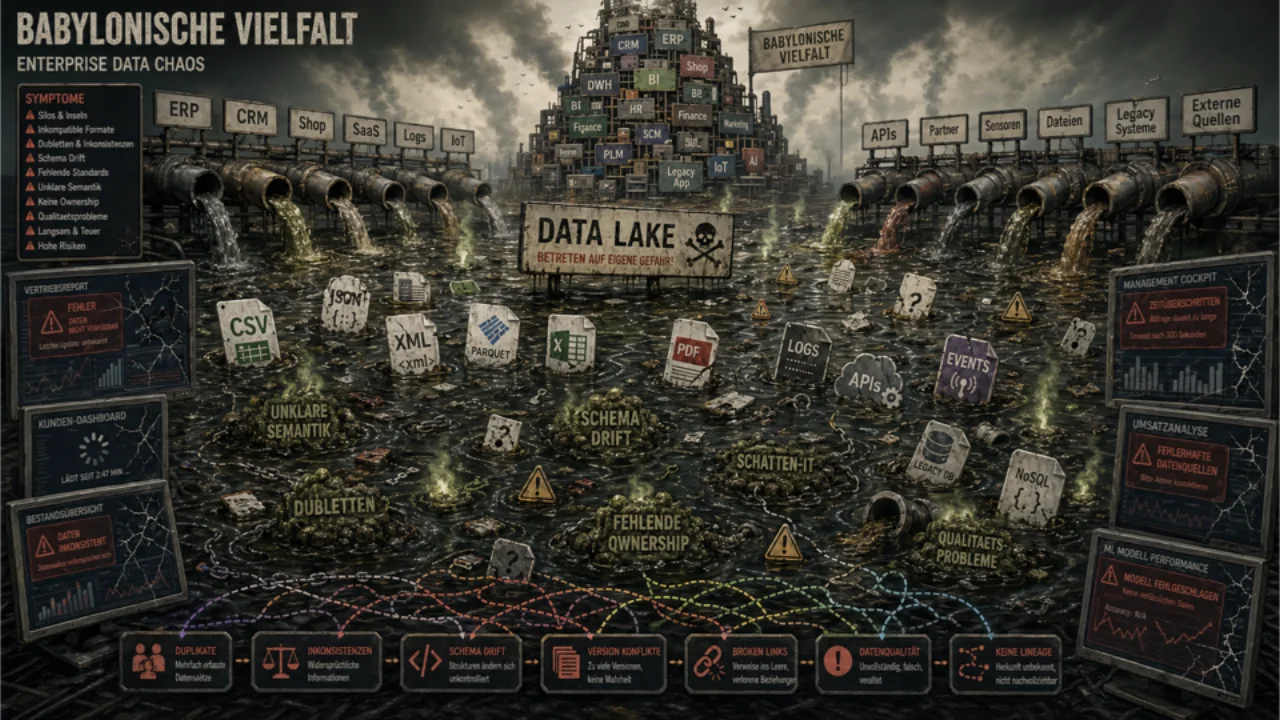
Les data warehouses classiques produisent de très beaux rapports. Le problème, c'est qu'ils arrivent souvent trop tard et reposent sur de mauvaises données. Gernot a assisté à quantité de réunions où quelqu'un sortait un fichier Excel d'un autre âge en lâchant : « tiens, moi je n'ai pas les mêmes chiffres ».
C'est du shadow IT, et il apparaît exactement là où la tuyauterie centrale a laissé les gens sur le carreau. Les data lakes ont hérité du même problème, à plus grande échelle : on déverse tout dedans en espérant qu'il en sorte quelque chose de bon. L'espoir est une belle chose, mais une piètre stratégie de données.
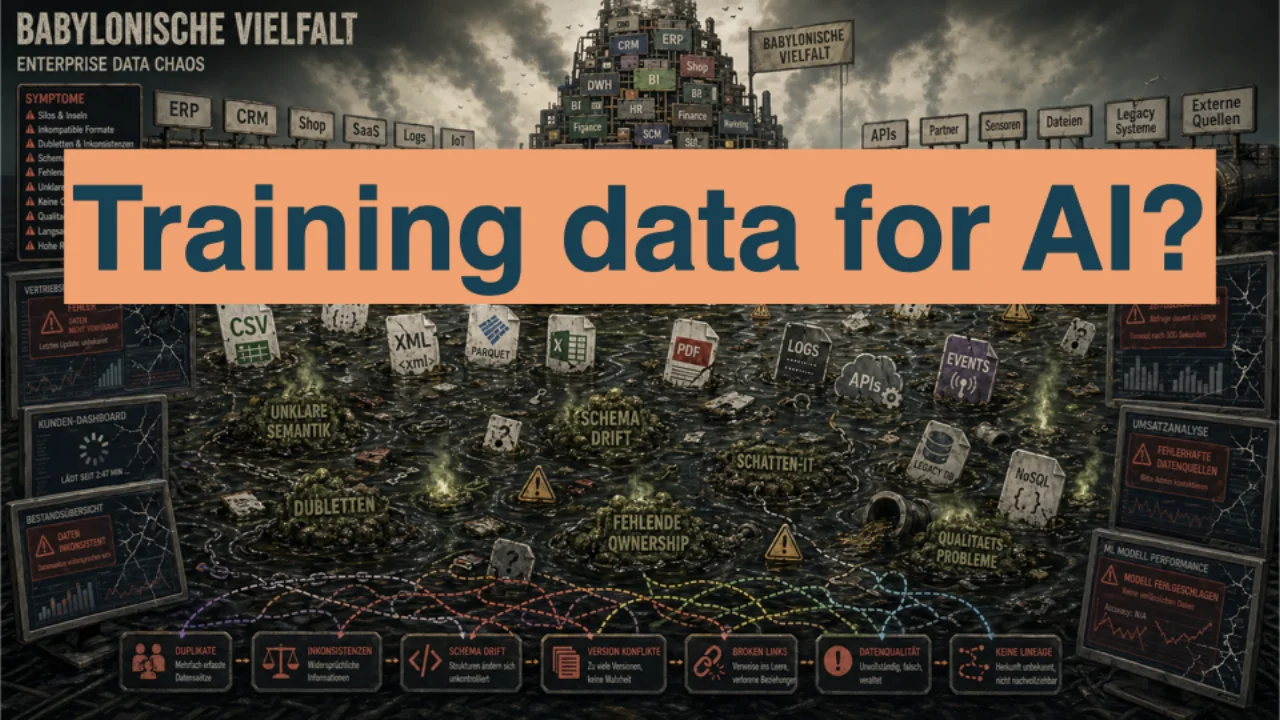
La vague de l'IA a rendu la chose impossible à ignorer. Dès qu'une entreprise a voulu affiner son propre modèle et s'est mise en quête de données d'entraînement, la réponse a généralement été : nous avons beaucoup de données, mais aucune idée de celles qui sont justes. Un modèle entraîné sur un marécage n'est pas intelligent. C'est un marécage.
Nous avons déjà résolu ce problème
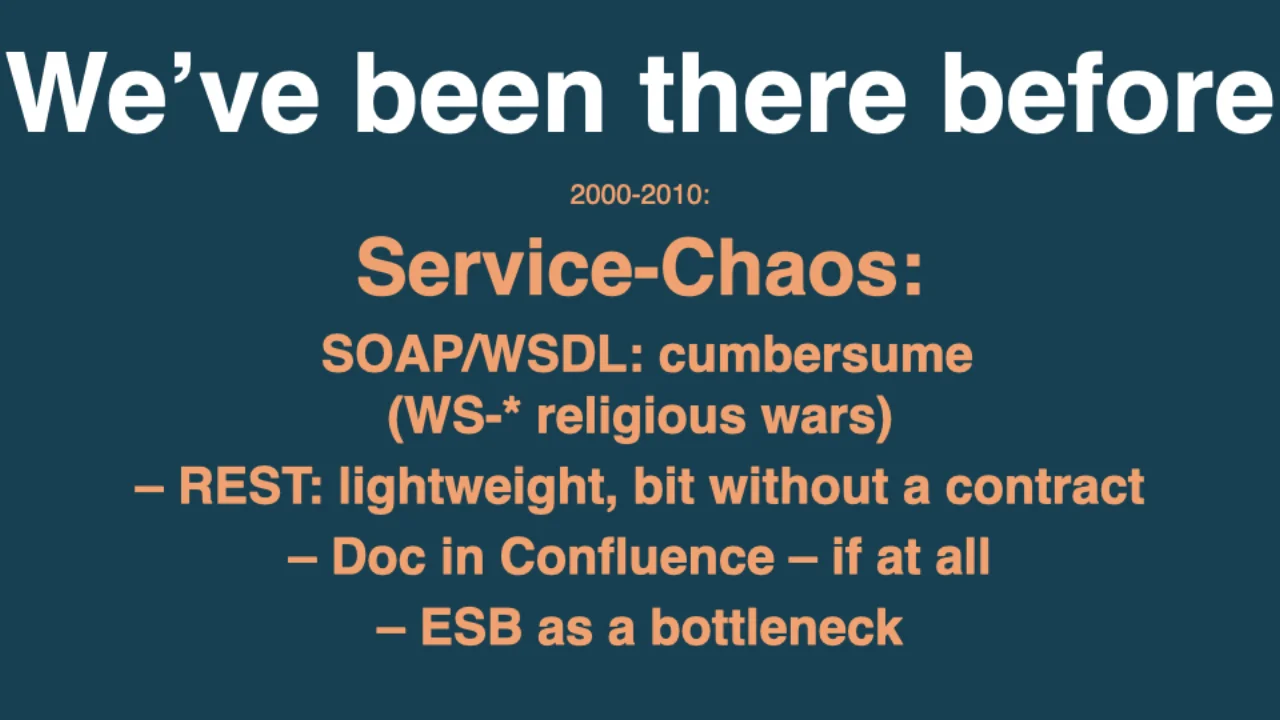
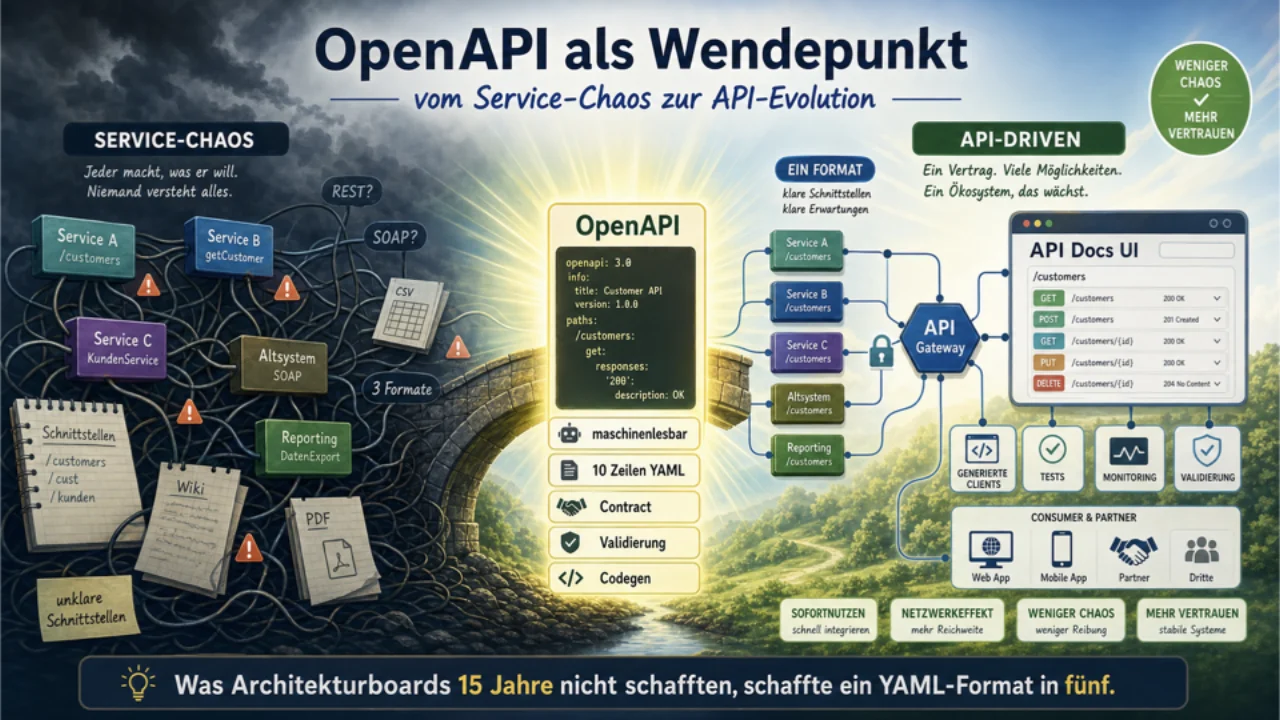
On a déjà connu ce genre de pagaille. Le « chaos des services » des années 2000 y ressemblait beaucoup : SOAP/WSDL était lourd, REST était léger mais sans contrat, la documentation vivait dans Confluence quand elle existait, et l'ESB faisait goulot d'étranglement. Personne ne savait vraiment quels services l'entreprise possédait.
Ce qui nous en a sortis, c'est Swagger puis OpenAPI. Un format texte, lisible par la machine et neutre vis-à-vis des éditeurs. Dix lignes de YAML suffisent pour démarrer. Swagger UI donne un bénéfice immédiat. Comme le dit Gernot, qui pèse ses mots, ça a vraiment changé la donne dans la façon dont les équipes produisent et consomment des services.
Il faut maintenant faire passer la même idée dans le monde des données.
Toute entreprise a déjà des API de données
REST a OpenAPI. Les messages et les événements ont AsyncAPI. Et les jeux de données partagés ?
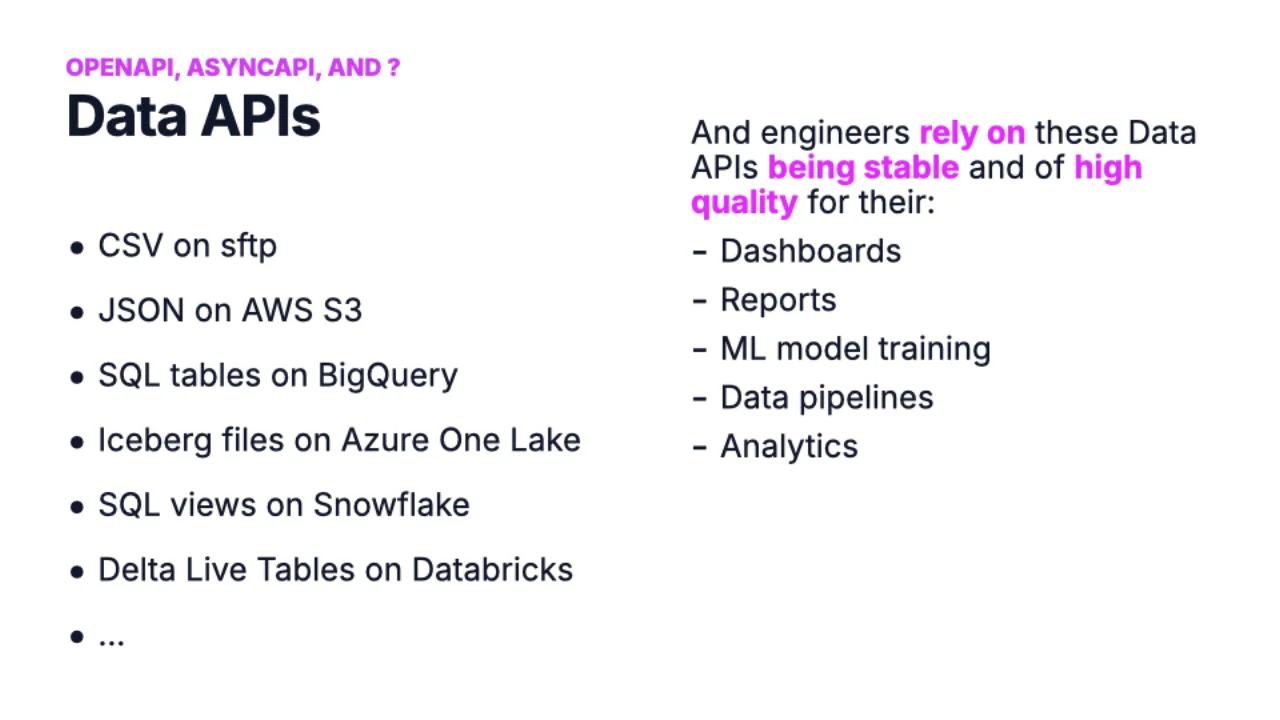
Parce qu'en vérité, toute entreprise possède déjà des dizaines d'« API de données ». Simplement, elles n'y ressemblent pas. Elles ressemblent plutôt à ceci :
- des CSV sur un SFTP
- des fichiers JSON sur S3
- des tables SQL sur BigQuery ou Snowflake
- des fichiers Iceberg sur Azure One Lake
- des Delta Live Tables sur Databricks
- des fichiers Excel sur SharePoint
Une équipe produit, d'autres consomment. Tableaux de bord, rapports pour le comité de direction, entraînement de modèles, pipelines en aval : tout repose sur la stabilité et la qualité de ces interfaces. Et le jour où le pipeline producteur change discrètement un en-tête de CSV ou vide une colonne, le tableau de bord affiche simplement un autre chiffre. Aucune erreur, aucune alerte : le pire mode de défaillance possible.
Qu'est-ce qu'un Data Contract ?
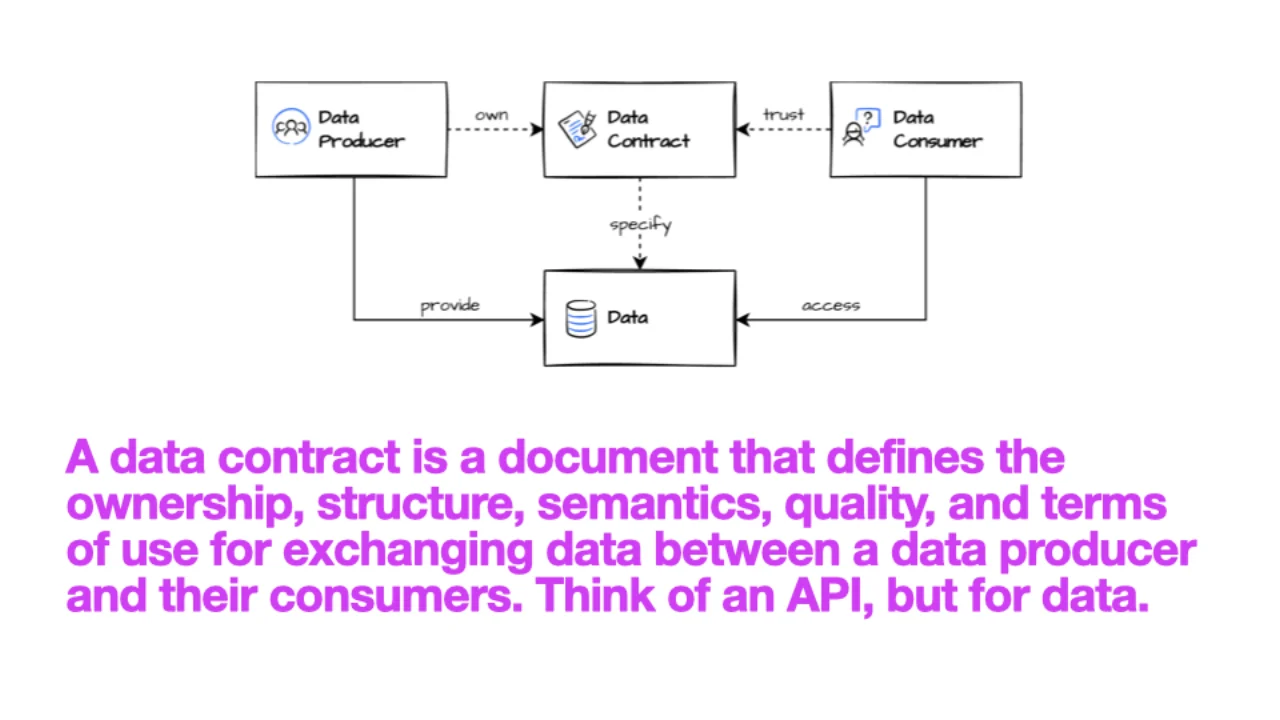
Un Data Contract est un document qui définit la propriété, la structure, la sémantique, la qualité et les conditions d'utilisation des données échangées entre un producteur et ses consommateurs. Pensez à une spécification d'API, mais pour les données.
Le producteur est propriétaire du contrat et y déclare ses garanties. Le consommateur le lit et s'y fie. Sans contrat, il ne lui reste qu'à rétro-concevoir le schéma en scrutant quelques lignes d'exemple, en devinant que OID2 est le numéro de commande alors que ce peut être tout autre chose. Ces contresens silencieux sont très difficiles à détecter.
Du bricolage maison au standard
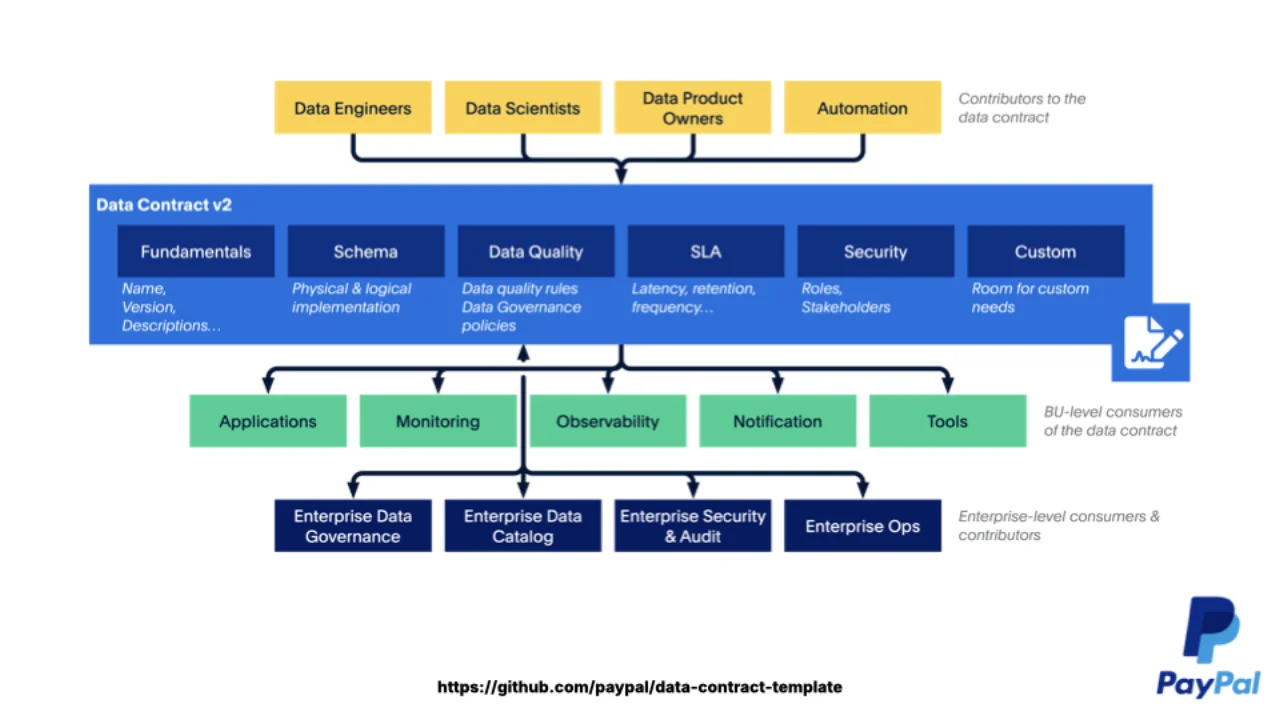
Quand le besoin est apparu, chaque entreprise a inventé son propre format. Du YAML ici, du JSON là, de l'Excel, parfois même des documents Word. Tous cherchaient à encoder la même chose : que signifie chaque champ, quelle est sa qualité, quel est le SLA, quelles sont les conditions d'utilisation.
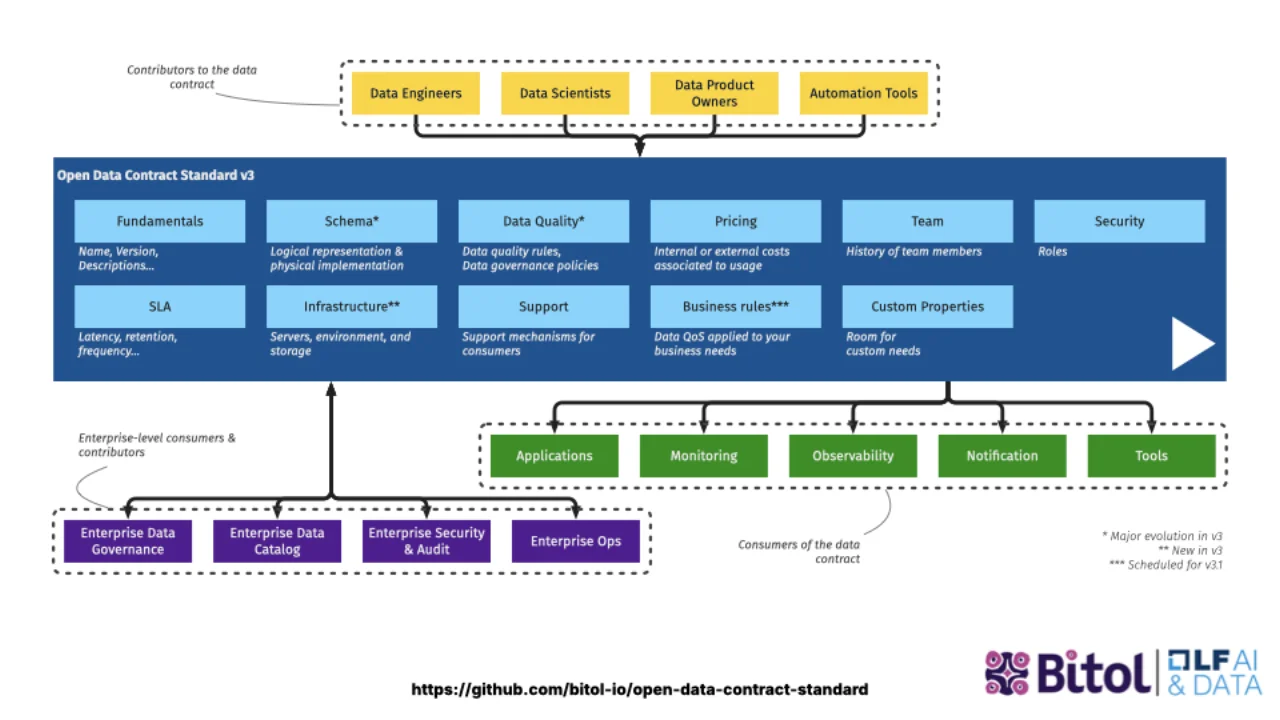
PayPal a ouvert son template interne et l'a donné à la Linux Foundation sous le nom d'ODCS 2.2. Simon a rejoint le TSC et aidé à en retirer les spécificités PayPal pour que n'importe quelle entreprise puisse l'utiliser. ODCS 3.0, publié en 2025, est la première version réellement neutre.
Le standard vit désormais chez BITOL, le projet Linux Foundation dédié aux standards ouverts de Data Contracts et de produits de données, avec un bon équilibre entre utilisateurs finaux, consultants et éditeurs au sein du comité. C'est ce type de gouvernance qui fait du mot « standard » autre chose qu'un argument marketing.
Ce que contient un contrat ODCS
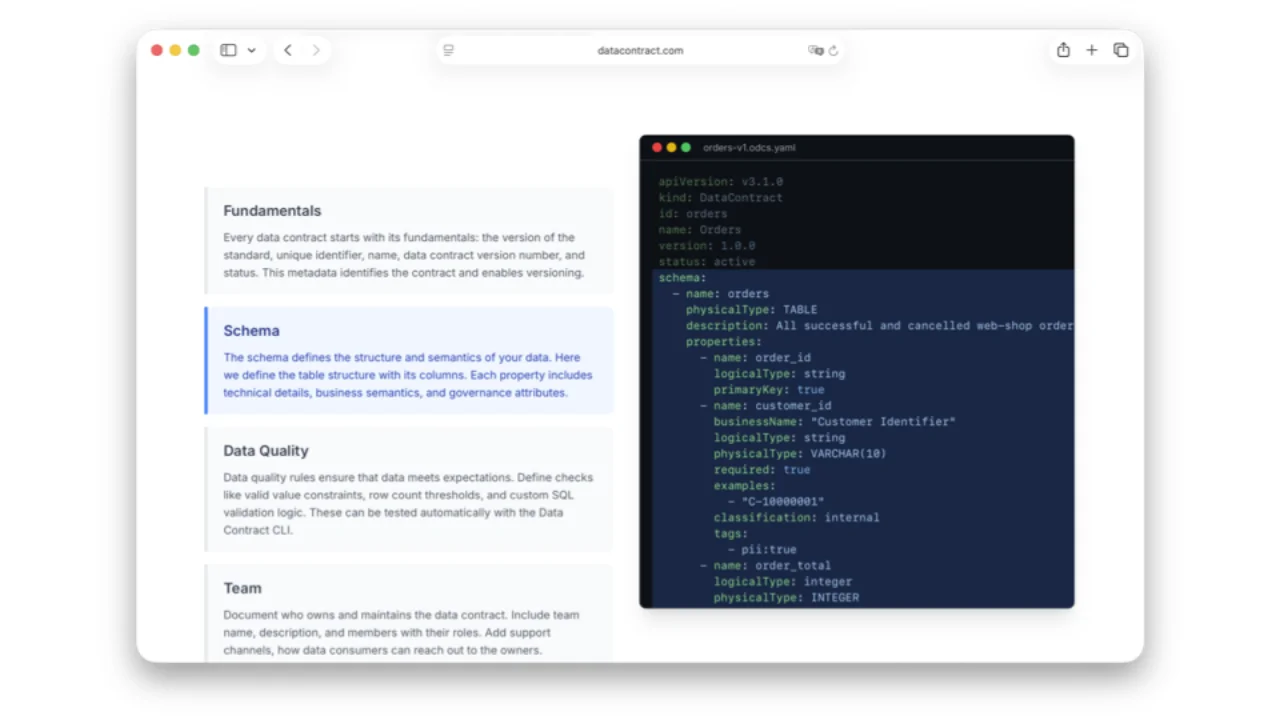
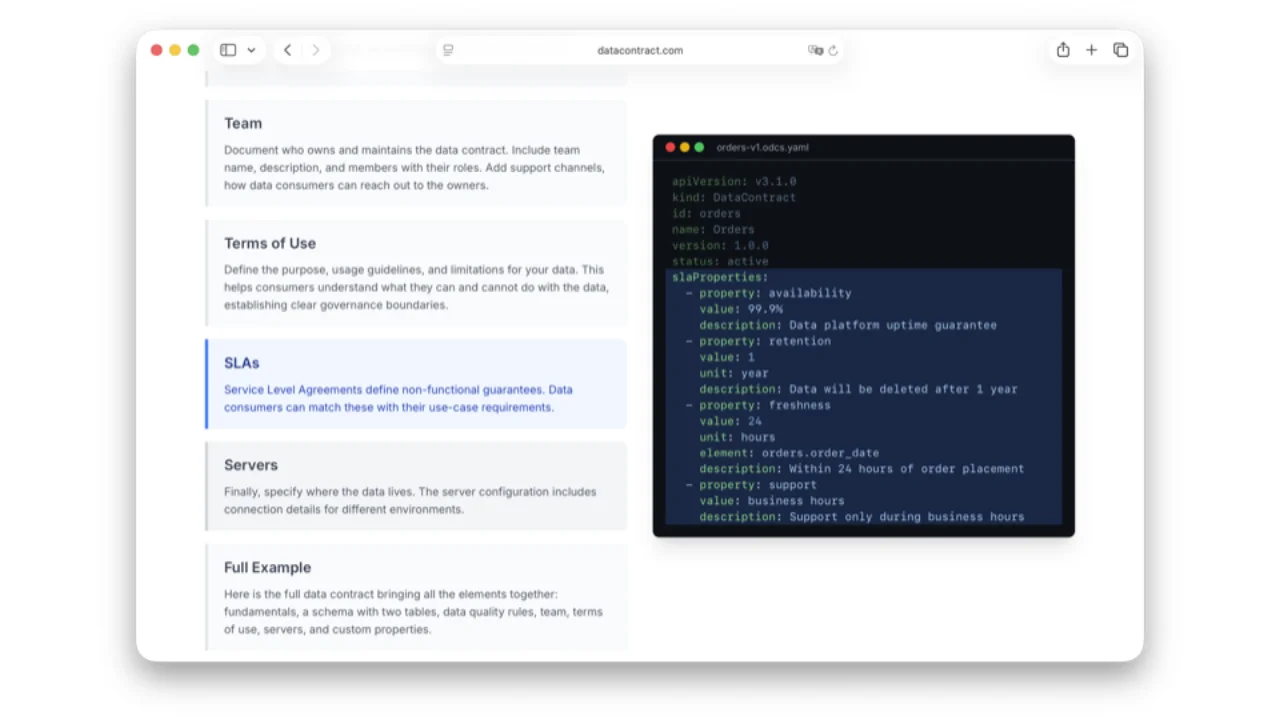
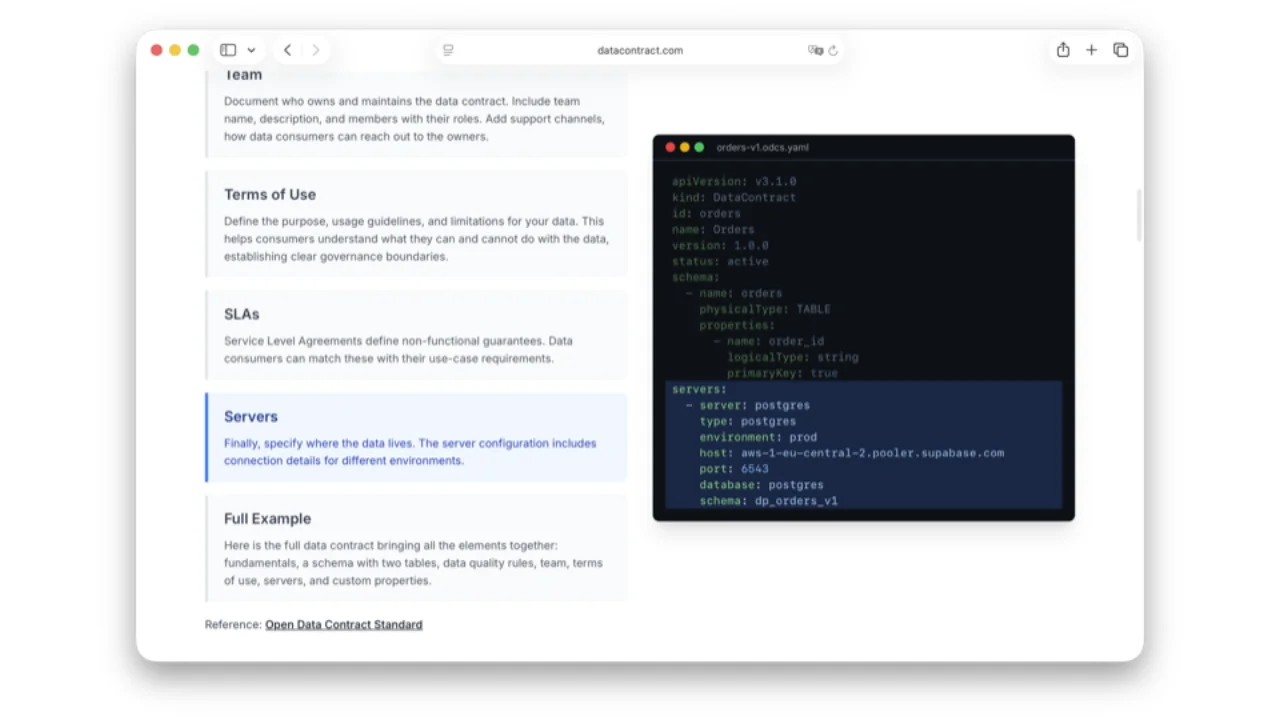
Un seul fichier YAML rassemble tout ce dont un consommateur a besoin :
- Fondamentaux : id, nom, version, statut (pour le cycle de vie).
- Schéma : tables et colonnes avec types logiques et physiques, clés primaires et étrangères, noms métier (« Customer Identifier »), classifications, étiquettes PII.
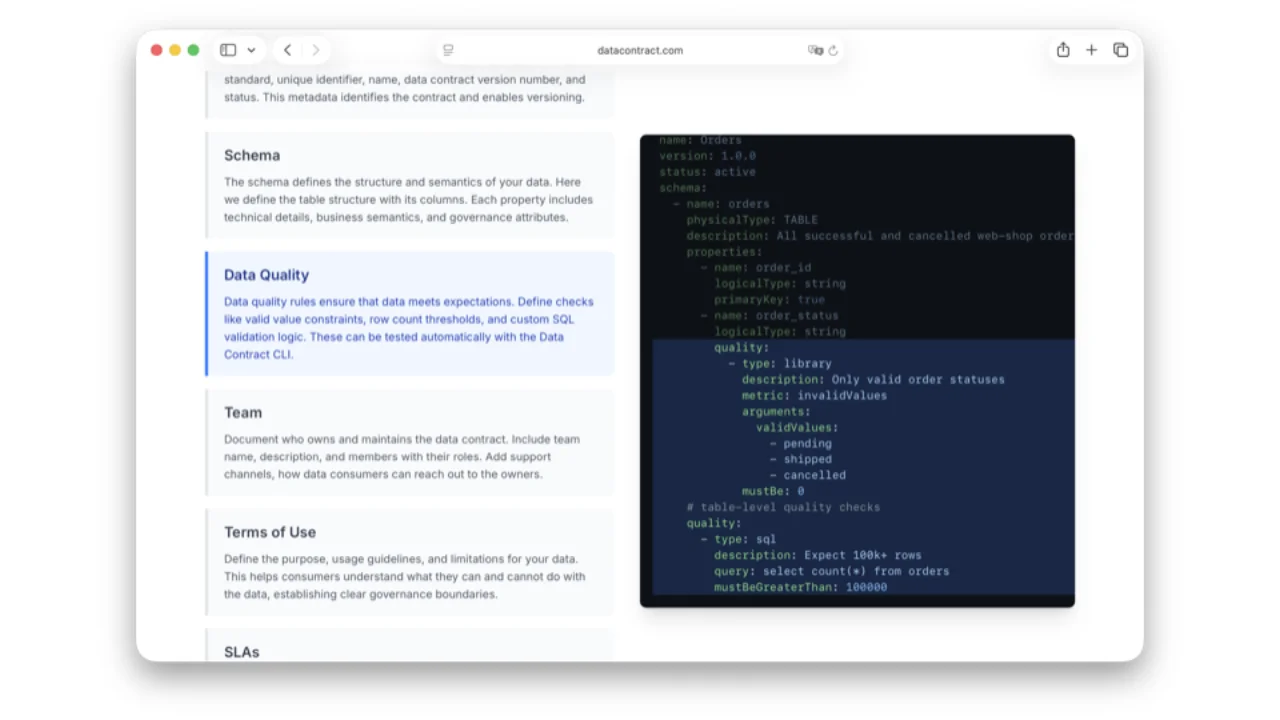
- Qualité des données : énumérations (
order_status ∈ {pending, shipped, cancelled}) ou SQL libre (« le nombre de lignes doit dépasser 100 000 »). Point crucial, tout s'exprime en pourcentages plutôt qu'en obligatoire/facultatif strict : les données réelles sont imparfaites et un modèle de ML fonctionne très bien avec 99 % de complétude. - Équipe et support : propriétaires, canaux Slack, outils de ticketing.
- Conditions d'utilisation : ce que les consommateurs ont le droit de faire ou non avec les données (portée géographique, garanties d'absence de PII, limitation de finalité).
- SLA : disponibilité, rétention, fraîcheur, latence. Dans le monde des données, la latence et la fraîcheur comptent bien plus que la disponibilité de la plateforme (Databricks, Snowflake ou BigQuery sont simplement là).
- Servers : l'endroit où les données résident réellement, pour qu'un consommateur autorisé puisse s'y connecter directement.
« Rendre la propriété explicite, voilà le grand pas. Tant que c'était implicite, les producteurs pensaient que la structure et la sémantique devaient évoluer, et les consommateurs supposaient qu'elles resteraient figées pour toujours. C'est ce malentendu qui casse les pipelines. »
Tout automatiser
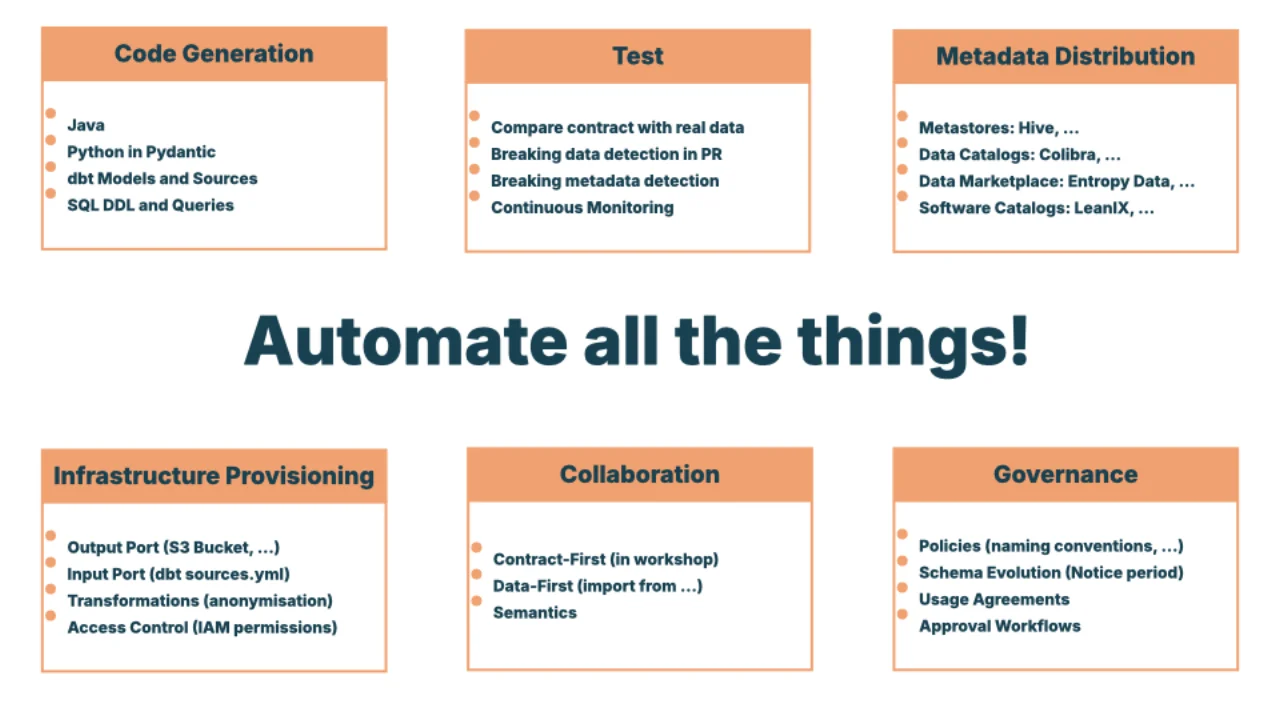
Dès lors qu'un contrat est du YAML, on peut en faire beaucoup : générer du Java, du Pydantic, des modèles dbt ou du DDL SQL, le confronter aux données réelles, faire échouer une pull request en cas de changement cassant, surveiller en continu en production, pousser les métadonnées vers des catalogues (Colibra), des marketplaces (Entropy Data) et des catalogues applicatifs (LeanIX).
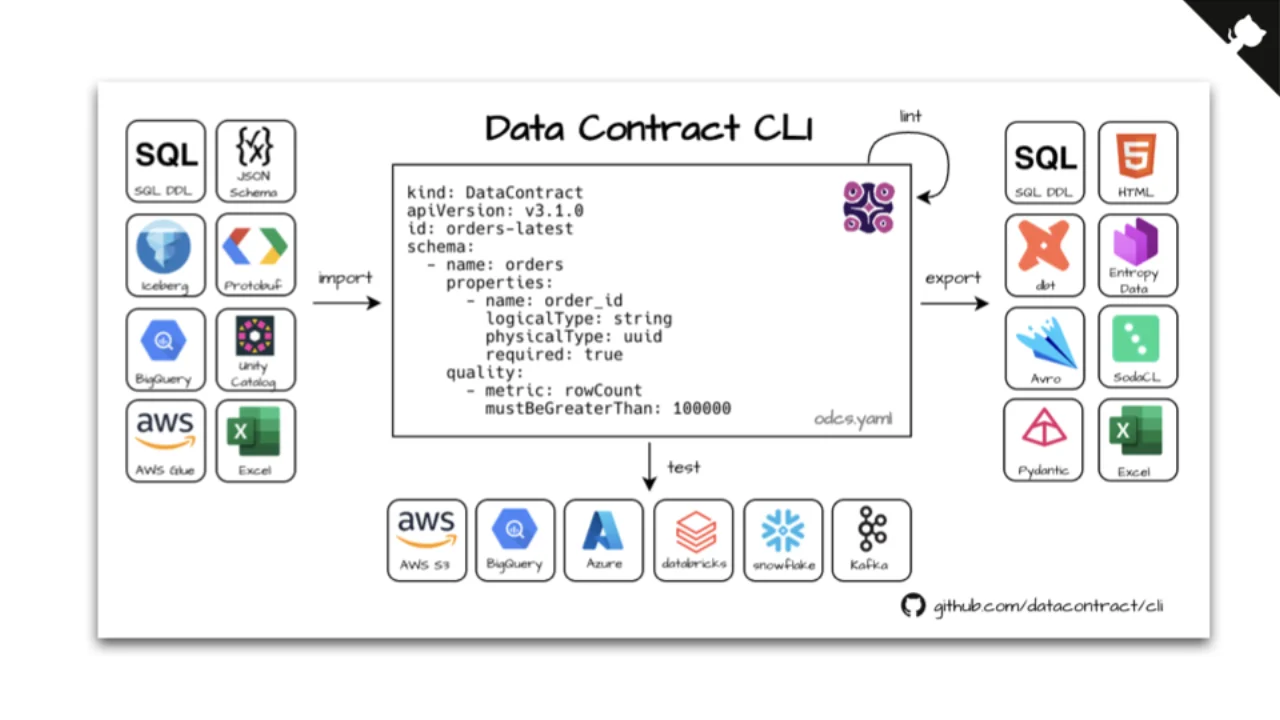
Le Data Contract CLI open source fait le gros du travail : imports depuis SQL DDL, JSON Schema, Iceberg, Protobuf, BigQuery, Unity Catalog, AWS Glue et Excel ; exports vers SQL DDL, HTML, dbt, Entropy Data, Avro, SodaCL, Pydantic et Excel ; tests sur AWS S3, BigQuery, Azure, Databricks, Snowflake et Kafka.
« Avant, les contrôles de qualité étaient des invariants enfouis dans notre code. Maintenant ils vivent à côté des données, dans le contrat, et ils tournent en continu. »
L'outillage compte plus que le standard
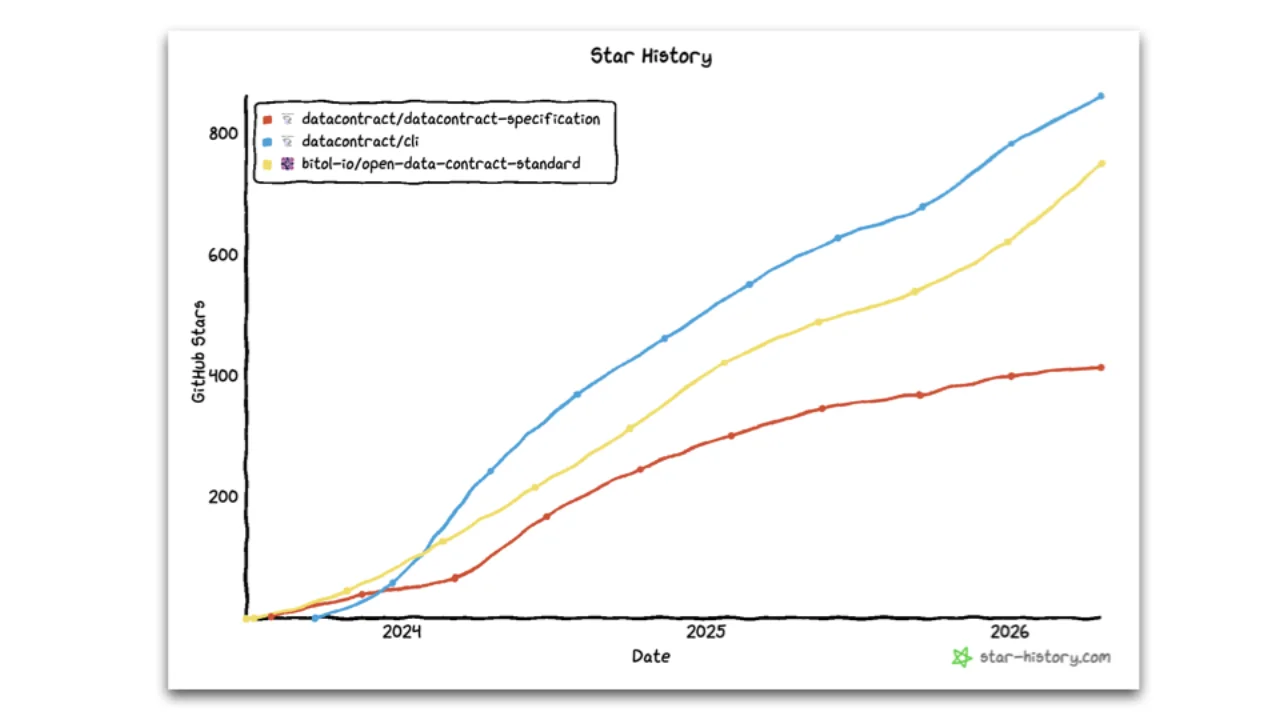
Si l'on regarde les étoiles GitHub, le Data Contract CLI est plus populaire que la spécification ODCS elle-même. C'est de nouveau la leçon d'OpenAPI : un standard ouvert a besoin d'un bon outillage open source pour être adopté.
C'est le standard qui vous offre cet outillage gratuitement, qui évite l'enfermement propriétaire dès que plusieurs outils parlent le même format, et qui fait que les équipes s'entraident au lieu de réinventer dix fois le même YAML avec dix variantes.
Des éditeurs pour les humains (et pour le métier)
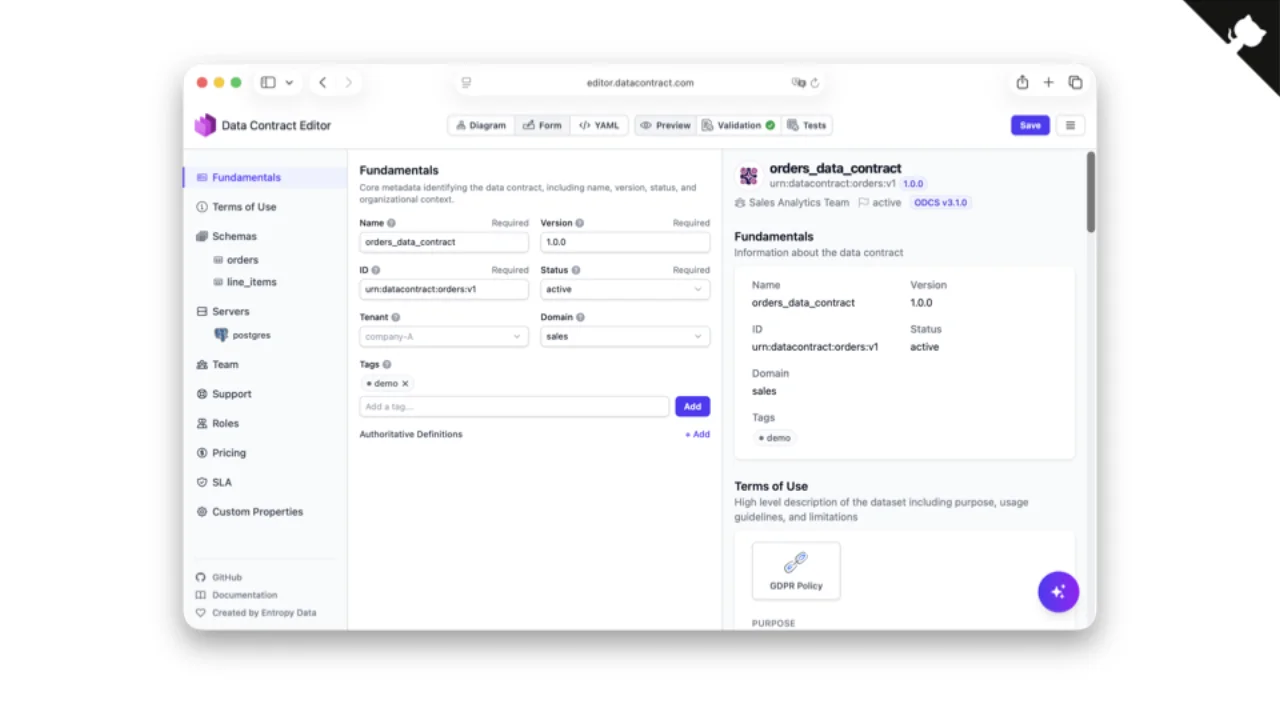
Écrire du YAML à la main est fastidieux, alors nous avons construit un Data Contract Editor open source. Vue diagramme, vue formulaire, vue YAML brut, avec aperçu et validation. Il est intégré au CLI : pendant que vous éditez, vous pouvez relancer les tests sur les données et vérifier que le contrat tient toujours.
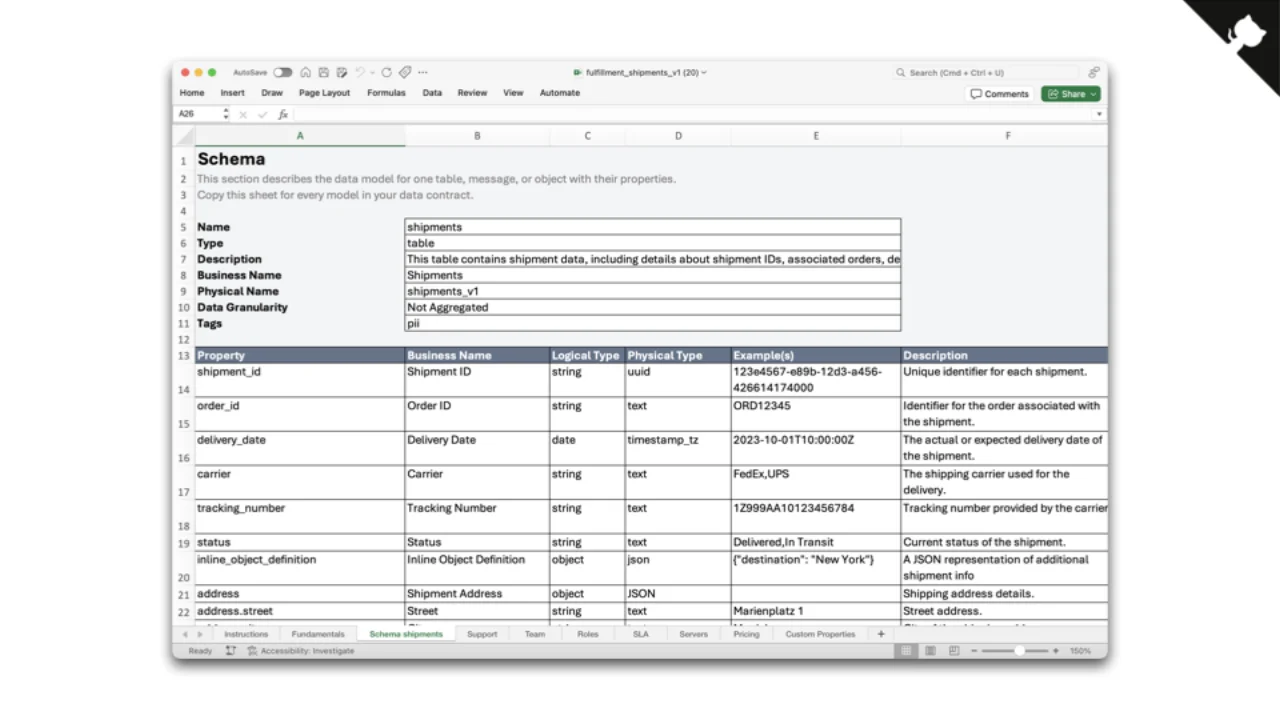
Pour les collègues qui n'ont aucune envie d'apprendre un nouvel outil, il existe aussi un modèle Excel ODCS. Le CLI le convertit en YAML. Ce n'est pas beau, mais c'est pratique, et Excel n'est pas près de disparaître.
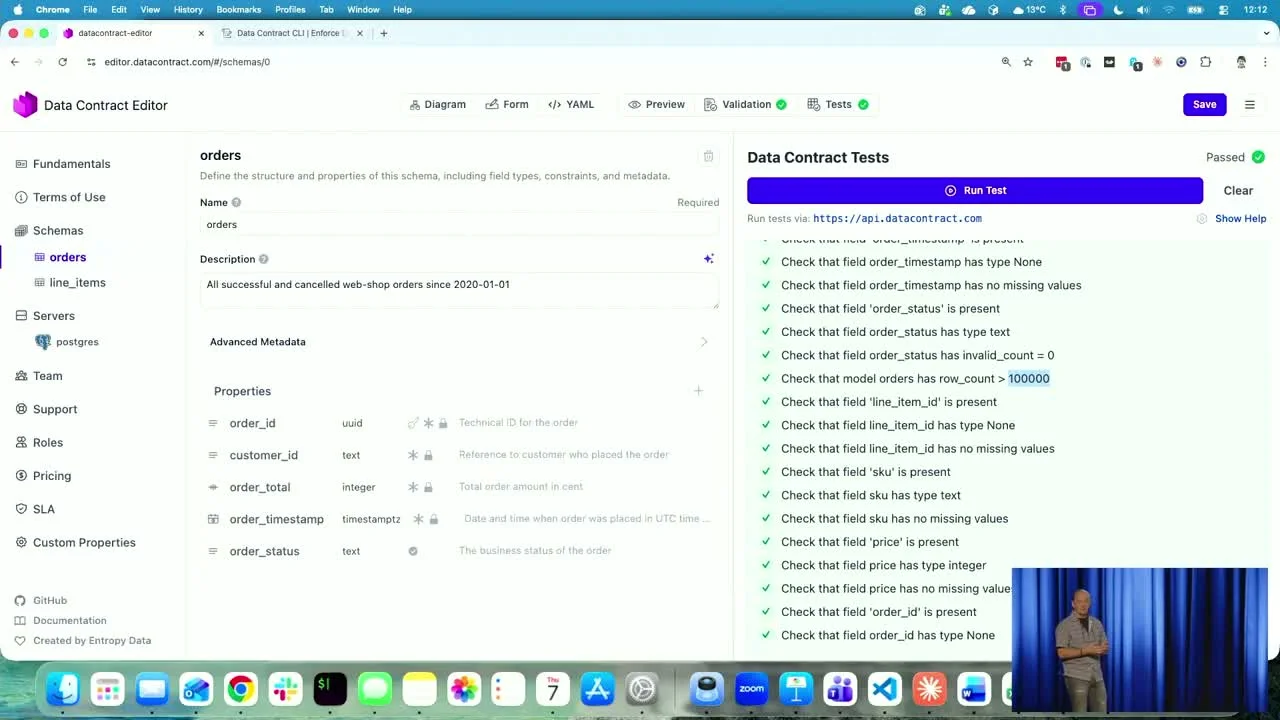
Démo live : l'éditeur et le CLI sur une vraie base
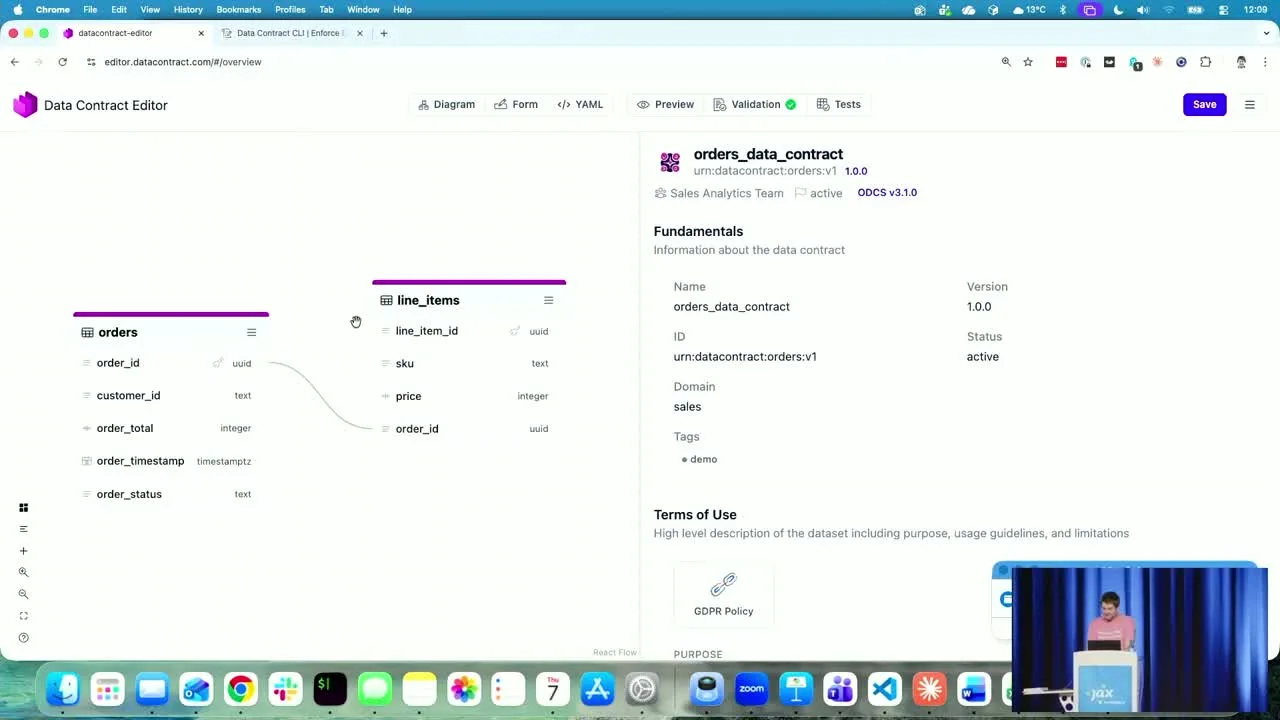
L'éditeur, sur editor.datacontract.com, affiche un contrat orders et line_items sous forme de diagramme, avec la clé étrangère qui les relie. Chaque champ a son type logique et son type physique, des exemples (« C-10000001 »), des classifications (internal, PII) et une description compréhensible par le métier (SKU → Stockkeeping Unit).
L'éditeur est branché sur une base Postgres hébergée chez Supabase. Un clic sur Run Test déclenche des sondes SQL via le CLI et renvoie un rapport tout vert : chaque champ du schéma attendu est présent et bien typé, order_status ne contient aucune valeur invalide, et le nombre de lignes dépasse largement le minimum de 100 000 exigé par le contrat.
Tout ce que vous savez exprimer en SQL devient un contrôle de qualité. Tout ce que vous savez exprimer devient un test continu.
Où les Data Contracts s'inscrivent dans le tableau d'ensemble
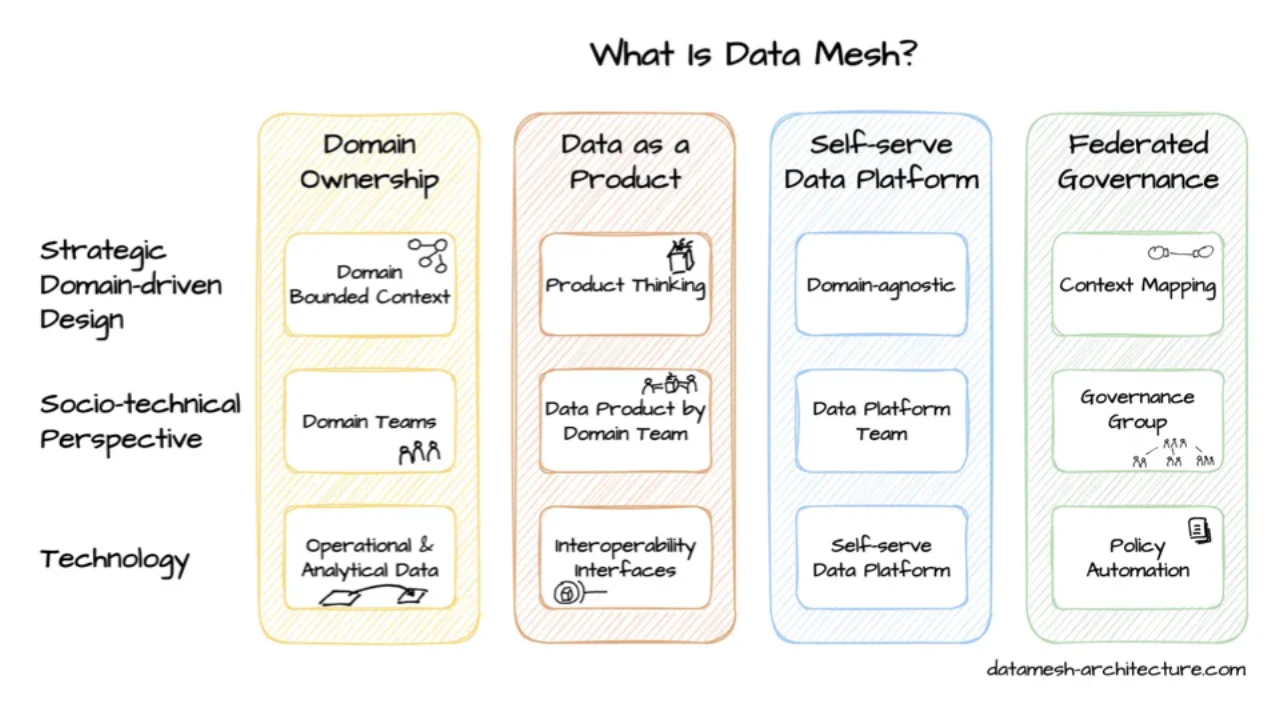
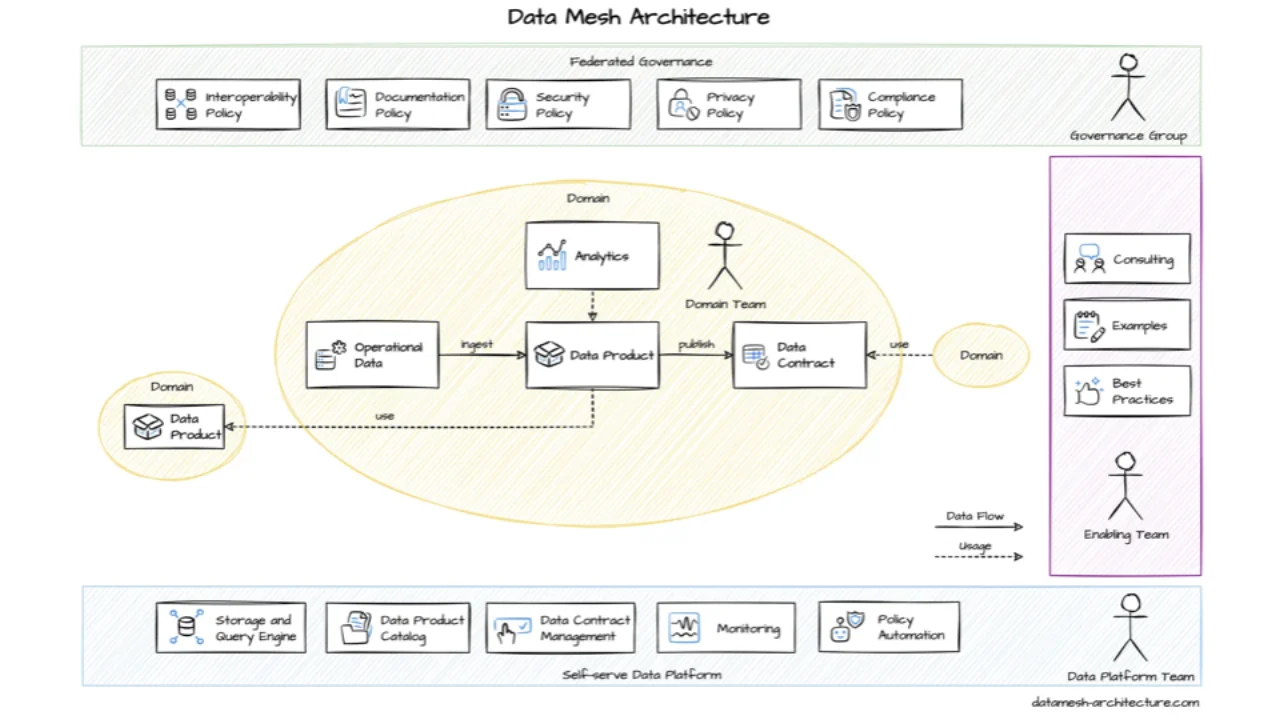
Les Data Contracts s'accordent naturellement avec le Data Mesh : propriété par domaine, données comme produit, plateforme en self-service, gouvernance fédérée. Les équipes de domaine construisent des produits de données qui consomment les contrats d'autres produits de données et en exposent de nouveaux. C'est la logique d'API que nous appliquons déjà aux services, avec la même pensée produit, la même pensée plateforme et la même gouvernance, transposée aux données.
Vous n'avez pas besoin de mettre en place un Data Mesh pour utiliser des Data Contracts. Le minimum, c'est deux équipes : une qui produit les données, une qui les consomme. Le Mesh se marie très bien avec, mais ce n'est pas un prérequis.
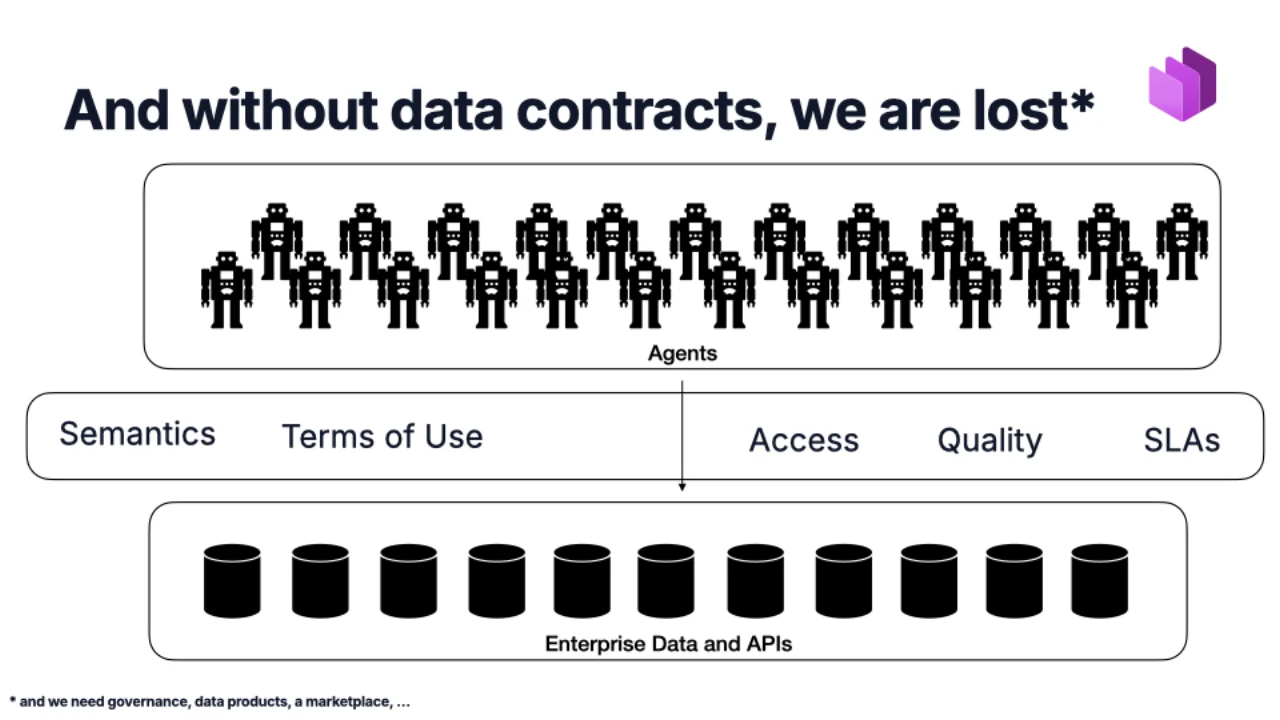
La vraie raison pour laquelle les Data Contracts vont s'imposer : les agents IA
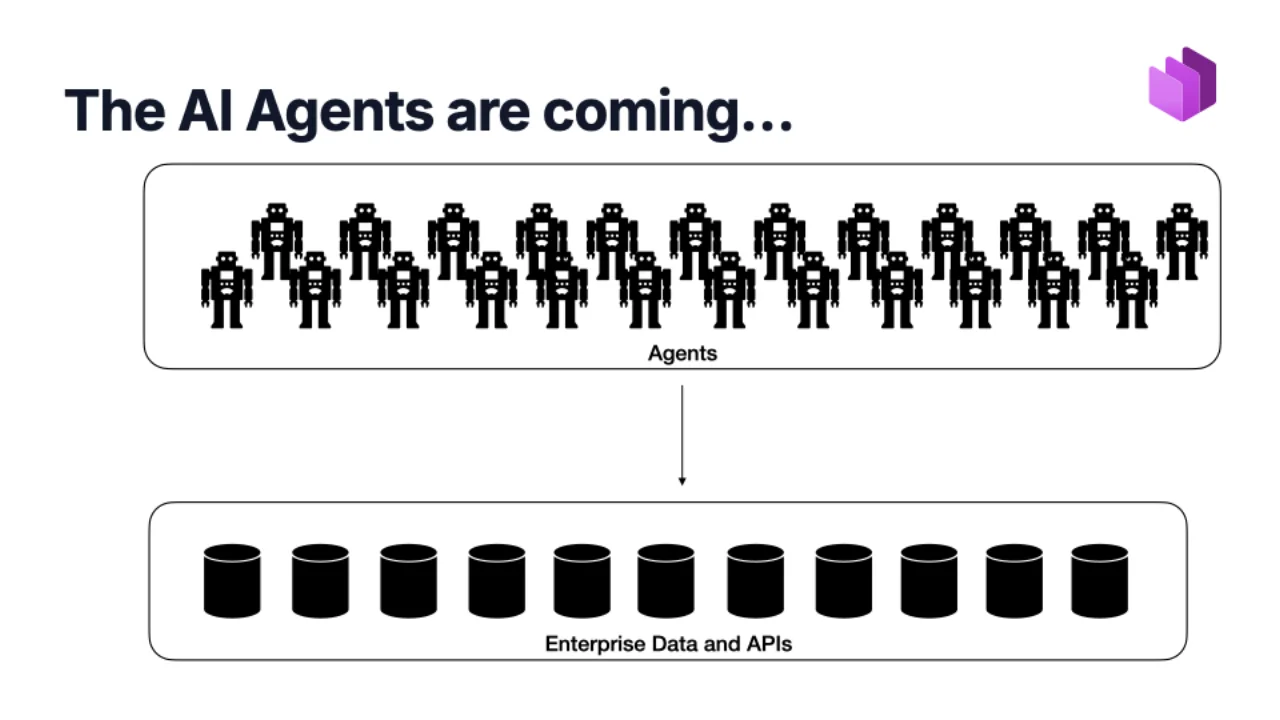
Le codage agentique n'est que la petite partie visible. Le vrai enjeu, ce sont les agents qui dialoguent avec les données de l'entreprise. Or un agent ne sait pas nativement ce que veulent dire vos tables, à quel point les données sont fraîches, s'il a le droit de s'en servir pour du marketing, ni comment demander un accès.
Le contrat lui donne tout cela : sémantique, conditions d'utilisation, accès, qualité, SLA. Souvenez-vous de la diapositive sur données et information : le contrat est précisément la couche qui transforme la donnée brute en information sur laquelle un agent peut raisonner.
Sans contrat, les agents finissent par deviner, et joignent les mauvaises colonnes avec beaucoup d'assurance. Avec des contrats, ils disposent de métadonnées solides sur lesquelles s'appuyer. C'est là tout le pari.
Démo live : un agent posé sur la couche contractuelle
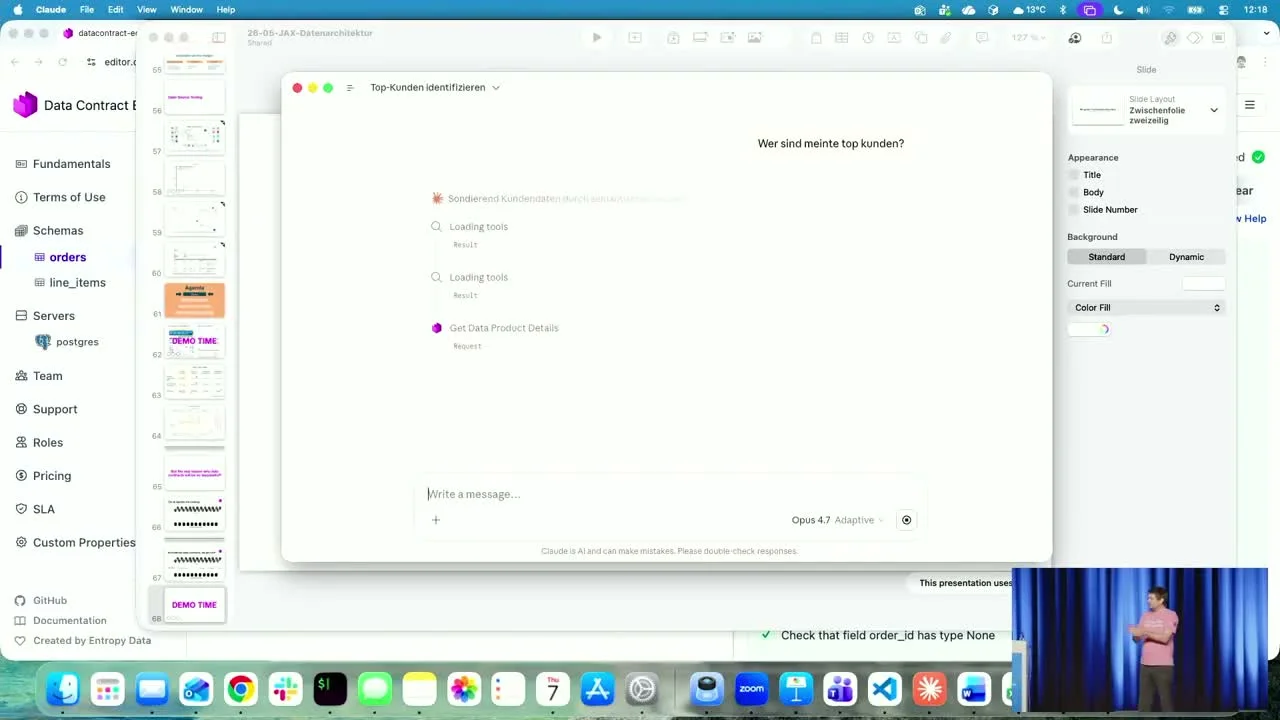
Même montage, un étage au-dessus. Un agent (Claude Opus) est branché au serveur MCP d'Entropy Data, qui expose la marketplace de données : des produits de données consultables, chacun accompagné de son contrat ODCS.
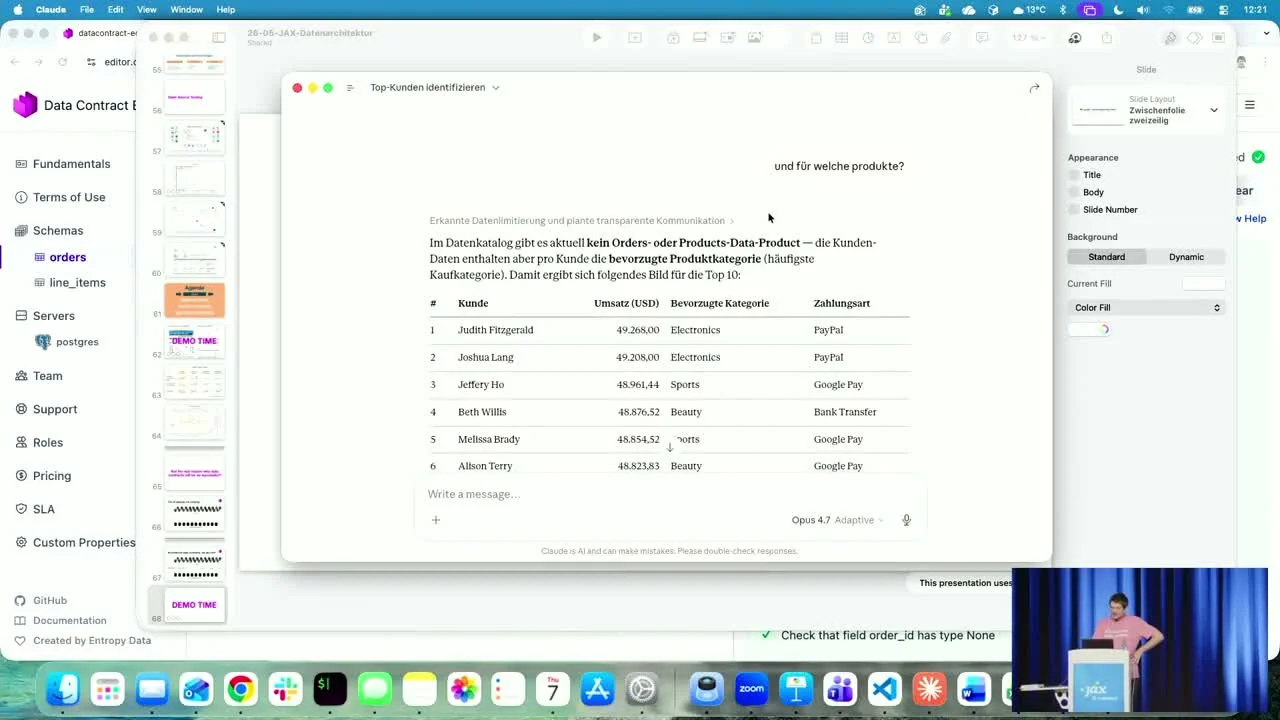
Un utilisateur métier pose sa question en allemand : « Wer sind meine Top-Kunden ? » (« qui sont mes meilleurs clients ? »). L'agent parcourt l'offre de données à partir des métadonnées des contrats, choisit le produit de données capable de répondre, vérifie que l'accès existe (et déposerait automatiquement une demande dans le cas contraire), exécute du SQL et renvoie un top 10 : nom, chiffre d'affaires, catégorie de produits préférée, moyen de paiement. Puis vient une relance, « und für welche Produkte ? » (« et pour quels produits ? »), et il poursuit, en disant franchement ce qu'il a trouvé et ce qu'il n'a pas trouvé.
L'important n'est pas que l'agent soit malin. L'important, c'est ce que le contrat rend possible : des utilisateurs métier qui formulent directement leurs hypothèses, au lieu d'ouvrir un ticket et d'attendre des semaines qu'une équipe data leur construise un cube.
La prédiction
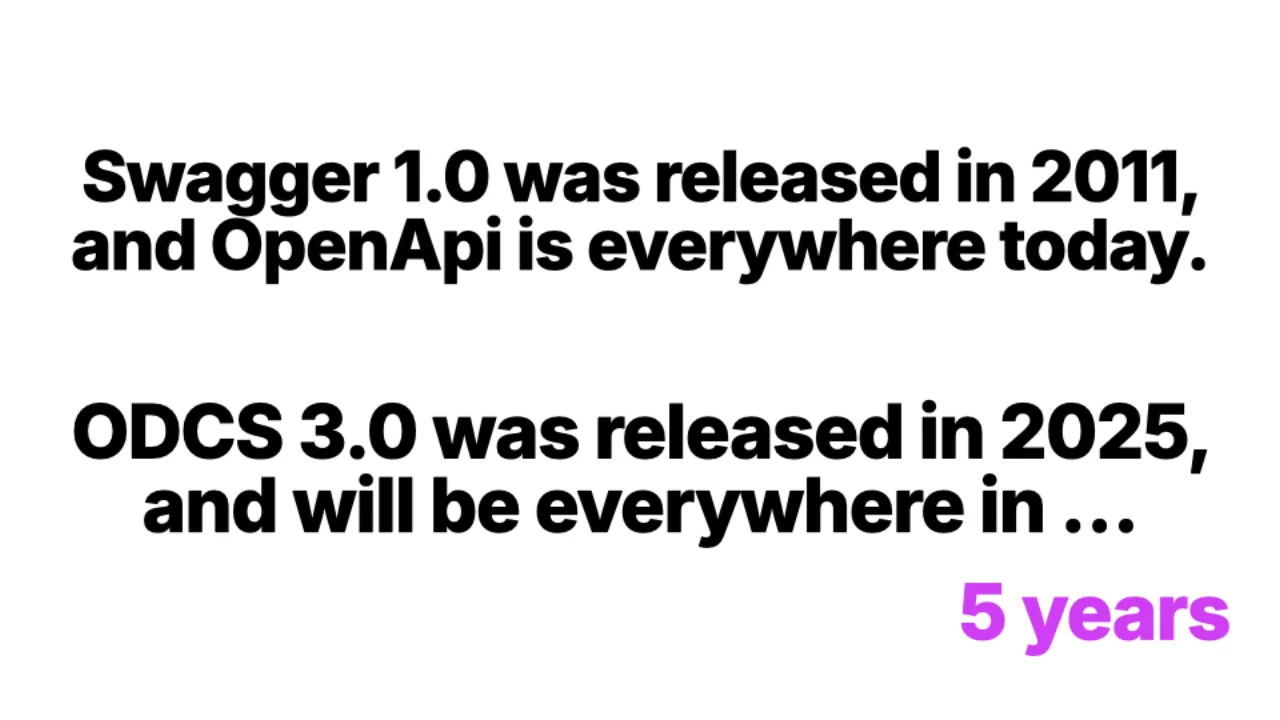
Swagger 1.0 est arrivé en 2011. Au début, il n'avait même pas de schémas, seulement des endpoints. Aujourd'hui, chaque API REST que vous croisez a sa spécification OpenAPI.
ODCS 3.0, la première version réellement neutre, est sorti en 2025. Le pari : dans cinq ans, il occupera la place qu'OpenAPI occupe aujourd'hui. Les choses vont plus vite qu'en 2011.
Le ticket d'entrée est modeste : n'importe quel éditeur de texte, dix lignes de YAML et le CLI open source suffisent à valider la pertinence sur votre propre cas d'usage. Autant être proactif plutôt que réactif.
Merci
Merci au public de JAX 2026 d'avoir patienté avant le déjeuner, et à la conférence pour le créneau. Pour prolonger la discussion :
Essayez la marketplace de produits de données fondée sur les contrats sur entropy-data.com, et si datacontract-cli vous a rendu service, offrez-lui une étoile sur GitHub.
Questions-réponses
Une sélection de questions posées par le public après la conférence.
Q : Comment fait-on réellement respecter un contrat, en particulier sur l'exfiltration des données et les limites d'usage ?
Côté producteur, on peut tout à fait faire respecter les garanties que l'on donne : schéma, fraîcheur, qualité. Faire respecter la part du consommateur (« vous ne pouvez utiliser ces données que pour la finalité X, pas Y ») est plus difficile. Notre réponse, sans grande surprise, c'est encore de l'IA : on ne surveille vraiment le comportement d'une IA qu'avec une autre IA. Un filtre purement à base de règles laisse tout passer ou étrangle le modèle au point de le rendre inutile. On peut aussi durcir les choses par classe : interdire purement et simplement à l'IA de toucher aux jeux de données les plus sensibles. C'est net et à base de règles, mais cela veut dire aussi que l'IA ne pourra pas vous aider sur ces jeux de données. Dans tous les cas, le simple fait que l'IA sache que la donnée existe et où elle se trouve est déjà un risque à gérer, comme pour toute technologie à double usage.
Q : Faut-il un registre central pour que les contrats soient réellement découvrables ?
Oui. Nous recommandons une marketplace de données : un endroit central où les consommateurs font leurs courses de données et où la demande d'accès fait partie du parcours. C'est l'équivalent d'une API gateway ou d'un catalogue d'API. Les contrats, eux, restent gérés de façon décentralisée par les équipes de domaine, mais le registre doit être central pour que la découverte fonctionne. C'est l'arbitrage classique entre décentralisation et centralisation que l'on retrouve dans toute plateforme.
Q : Comment cela s'articule-t-il avec les contrats de service et OpenAPI ? Ces derniers décrivent aussi des données, via les DTO, non ?
OpenAPI décrit la forme de l'équivalent d'une ligne : ce champ est facultatif, celui-là non, éventuellement une expression régulière. Au-delà, il se tait. Il ne vous dit pas si un champ relève des PII, quelle est sa classe de protection interne, ni comment il se rattache aux autres concepts du métier. Le lien entre orderId dans l'API et OID2 dans une table de base de données, seule une couche sémantique le capture. Avec de bonnes métadonnées, ODCS d'un côté et OpenAPI de l'autre, l'IA peut reconnaître qu'il s'agit du même concept et faire la jointure. Sans elles, elle doit supposer, et les suppositions sont généralement fausses.
Q : Faut-il arrêter de construire des interfaces en lecture seule pour les systèmes externes et publier des Data Contracts à la place ?
Un GET REST est déjà une interface de lecture, donc techniquement rien n'empêche d'y poser un contrat : le seul prérequis d'un Data Contract, c'est que des données soient partagées en lecture. La vraie question est de conception : de petites API point à point, taillées chacune pour le besoin d'un consommateur, se multiplient vite et deviennent un fardeau de maintenance dans le monde des données. Ce que vous voulez, c'est peu d'offres, bien conçues, qui servent beaucoup de consommateurs : une logique produit, du un-vers-plusieurs. Le même réflexe que celui qui nous éloigne des microservices taillés par consommateur.
Q : Un contrat décrit le côté producteur. Comment voit-on où les données circulent réellement, qui les consomme et comment elles sont utilisées ?
Une marketplace vous emmène une partie du chemin : les consommateurs demandent l'accès en déclarant une finalité, qui est enregistrée. Au-delà, des formats de lineage comme OpenLineage rendent compte de la circulation réelle des données dans les systèmes en aval, jusqu'au niveau des colonnes. Combinez les deux et vous pouvez vérifier si vos règles de macro-architecture correspondent aux flux réels : un audit très efficace de « ce que nous disions faire » face à « ce qui se passe vraiment ».
Articles associés
Qu'est-ce qu'un Data Contract ?
Un Data Contract définit la propriété, la structure, la sémantique, la qualité et les conditions d'utilisation d'un échange de données. Découvrez l'Open Data Contract Standard (ODCS) avec des exemples.
Qu'est-ce qu'un produit de données ?
Un produit de données est une unité logique qui regroupe tous les composants nécessaires pour traiter et stocker les données d'un domaine métier, au service de cas d'usage analytiques, et les met à disposition des autres équipes via des Output Ports.
Data-first or Contract-first?
Conférence annotée de Jochen Christ (Entropy Data) sur les deux chemins qui mènent à un produit de données : la voie data-first traditionnelle et la voie contract-first, avec les Data Contracts, ODCS, la Data Contract CLI et un agent de code qui construit le produit à partir du contrat.